小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
沉浸式翻译 immersive translate
Dify.AI
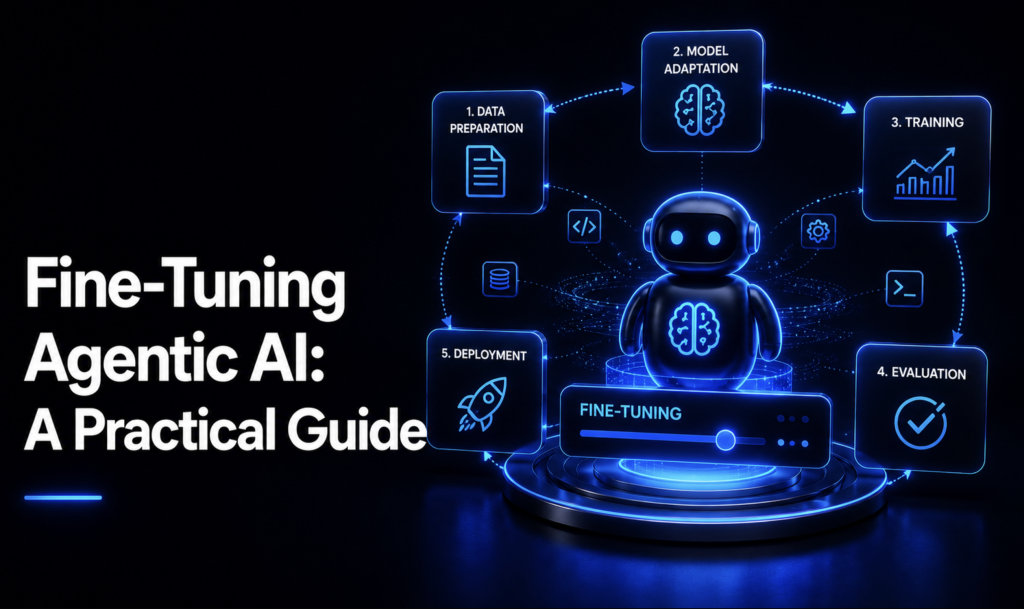
智能体AI微调:实用指南

智能体AI微调需同时优化四个关键环节:训练数据、参数高效微调、运行时超参数和偏好对齐。以客服工单分流智能体为例,工具调用数据集须严格校验格式,采用QLoRA高效训练,调整温度与重试策略,并用DPO提升判断力。最后通过评估框架检测灾难性遗忘,决定是否上线。

智能体AI微调:实用指南

MachineLearningMastery.com MachineLearningMastery.com · 2026-09-11T12:00:50Z
理解多模态大语言模型中的对齐:一项综合研究

本文系统研究了多模态大语言模型(MLLMs)中的偏好对齐问题,将算法分为离线(如DPO)和在线(在线DPO)两类,发现两者结合可提升性能。作者提出无需额外标注或外部模型的新型数据构建方法“偏差驱动幻觉采样”(BDHS),在多个基准上达到与现有对齐工作相当的竞争力,并分析了偏好数据集构建细节对模型表现的影响。

理解多模态大语言模型中的对齐:一项综合研究

Apple Machine Learning Research Apple Machine Learning Research · 2026-08-03T00:00:00Z

本文提出了一种基于比较oracle的新偏好对齐方法,旨在解决现有方法在语言模型与人类偏好对齐中的冗长性和可能性偏移问题。实验结果表明,该方法在利用噪声偏好提升语言模型性能方面具有有效性和灵活性。

ComPO: Preference Alignment via Comparison Oracles

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-05-08T00:00:00Z

本研究分析了现有偏好对齐方法在大型语言模型中的局限性,尤其是对高质量正偏好数据集的依赖。提出了“遗忘以对齐”框架,通过双层优化量化负例遗忘对偏好对齐性能的影响,并通过实验验证了其有效性。

Bridging the Gap Between Preference Alignment and Machine Forgetting

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-04-09T00:00:00Z

本研究提出了一种新的后训练偏好对齐方法,旨在缩小多智能体运动生成模型与人类偏好之间的差距。通过利用先前训练示范中的隐式反馈,显著提高了生成行为的真实性和一致性,无需额外的人类偏好注释。

通过先验示范中的隐式反馈实现多智能体运动生成模型的直接后训练偏好对齐

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-03-25T00:00:00Z

本研究提出偏好对齐蒸馏(PAD)框架,旨在解决小型语言模型(SLMs)从大型语言模型(LLMs)中提取偏好知识的细化问题,显著提升人类偏好的对齐效果。

Capturing Fine-Grained Preferences: Preference Alignment Distillation for Small Language Models

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-02-20T00:00:00Z

本研究提出了一种即时偏好对齐方法,有效解决大型语言模型生成与人类价值观对齐的效率问题。实验结果表明,该方法在对齐任务中表现优异,具备高效性和有效性。

Instant Preference Alignment Based on Principle-Guided Decoding

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-02-20T00:00:00Z

本研究提出PIPA框架,以统一理解语言模型的偏好对齐问题。通过最大似然估计,PIPA实现了3-10%的性能提升,并有效整合了先验信息。

优先对齐的先验信息统计估计研究

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-02-09T00:00:00Z
细粒度对齐无需仔细标注了!淘天提出视觉锚定奖励,自我校准实现多模态对齐

AIxiv专栏促进学术交流,报道超过2000篇文章。淘天集团未来生活实验室专注于大模型和多模态AI技术,提出令牌级偏好对齐方法(TPO),有效缓解视觉大模型的幻觉现象,提升模型与视觉信息的关联性。

细粒度对齐无需仔细标注了!淘天提出视觉锚定奖励,自我校准实现多模态对齐

机器之心 机器之心 · 2025-01-19T04:07:07Z

本文探讨了视觉-语言-动作(VLA)模型在机器人操作中的应用与挑战,提出了GRAPE方法,通过偏好对齐提升机器人策略的泛化能力。GRAPE利用视觉语言模型分解任务,优化轨迹以适应不同操控目标,旨在降低强化学习成本并提高灵活性。

GRAPE——RLAIF微调VLA模型:通过偏好对齐提升机器人策略的泛化能力

结构之法 算法之道 结构之法 算法之道 · 2024-12-30T16:02:11Z

本研究提出了一种新颖的多视角偏好对齐方法(PA-RAG),有效解决了现有检索增强生成模型在信息量、鲁棒性和引用质量方面的不足,显著提升了生成器的性能。

PA-RAG: Achieving RAG Alignment through Multi-Perspective Preference Optimization

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-12-19T00:00:00Z

本研究提出RAG-RewardBench基准,旨在解决检索增强语言模型与人类偏好对齐不足的问题。通过评估45个奖励模型,揭示了现有模型在偏好一致性方面的局限性,强调了进行偏好对齐训练的必要性。

RAG-RewardBench: Evaluating Reward Models in Retrieval-Augmented Generation for Preference Consistency

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-12-18T00:00:00Z

本研究提出了一种新颖的偏好对齐框架RADIO,旨在解决检索增强生成(RAG)中重新排序器与生成器之间的相关性差距。通过大语言模型提取推理依据,优化文档排序和生成,实验结果表明该方法在多个任务上优于基线,具有显著实用价值。

Bridging the Gap Between Relevance and Reasoning: Rationale Distillation in Retrieval-Augmented Generation

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-12-11T00:00:00Z

本文综述基于人类反馈的强化学习(RLHF)中奖励模型的研究进展,涵盖分布偏移鲁棒性、偏好分歧建模、冗长性偏差、多偏好数据集融合、过度优化缓解及不确定性量化等问题,并提出d-PM、MORE、UP-RLHF等方法以提升对齐效果。

LLM 对齐的贝叶斯奖励模型

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-02-20T00:00:00Z

该文综述大语言模型隐私保护与人类反馈对齐研究,涵盖强化学习结合差分隐私实现隐私保护对齐、离线强化学习提升训练稳定性、奖励模型改善机器翻译、弹性复位微调减少语言漂移、RAIN自评倒带机制无需训练即可对齐、线性对齐一次推理完成偏好对齐,以及ReST、RRHF等方法提升效率与效果。

语言模型的解码时间对齐

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-02-05T00:00:00Z

本文综述大语言模型与扩散模型的偏好对齐方法。DPO无需奖励模型,直接优化人类偏好,比RLHF更简单稳定;Diffusion-DPO将其扩展至扩散模型,提升视觉吸引力与文本对齐。后续研究提出ΨPO、APA、MODPO、RSO等改进算法,提升稳定性与效率。

Efficient and Accurate Optimization for Language Model Alignment

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-02-01T00:00:00Z

本文综述了基于人类反馈的强化学习(RLHF)优化大语言模型的研究。针对过度优化问题,提出利用多样化LoRA集成量化奖励不确定性,并通过不确定性正则化优化策略。同时介绍了RRHF排名损失、轨迹对采样和迭代在线训练等方法,以提升模型与人类偏好的一致性。

提高基于人类反馈的强化学习效果的高效奖励模型集成

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-01-30T00:00:00Z

本文综述了基于人类反馈的强化学习(RLHF)优化语言模型的研究,涵盖多奖励模型投票、对比学习与元学习以增强奖励模型的区分与泛化能力;d-PM采用贝叶斯框架建模偏好分歧;RLHF通过迭代在线训练提升有用性与无害性;RRHF以排名损失对齐偏好;并构建大规模偏好数据集ULTRAFEEDBACK,使离线强化学习训练更稳定高效。

改进奖励建模的西至 N: 合成优先性生成

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-01-22T00:00:00Z

本文综述大语言模型在机器翻译领域的多项进展:提出ALMA微调方法并在WMT测试集上显著提升性能;采用对比式后训练(SLiC、DPO)进行人类偏好对齐,改善Orca等模型表现;探索上下文学习以实现实时自适应翻译;用混合策略解决同传训练与推理不匹配问题;系统评估多语言翻译能力;研究文档级翻译适配;利用GPT-4等模型进行跨语言数据增强;提出XConST提升零样本翻译;用偏好损失框架开展翻译教学;结合低秩适配器改进翻译与自动后编辑。

对比型偏好优化:推动机器翻译中 LLM 性能的边界

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-01-16T00:00:00Z
利用语言模型挖掘人类偏好 [译]

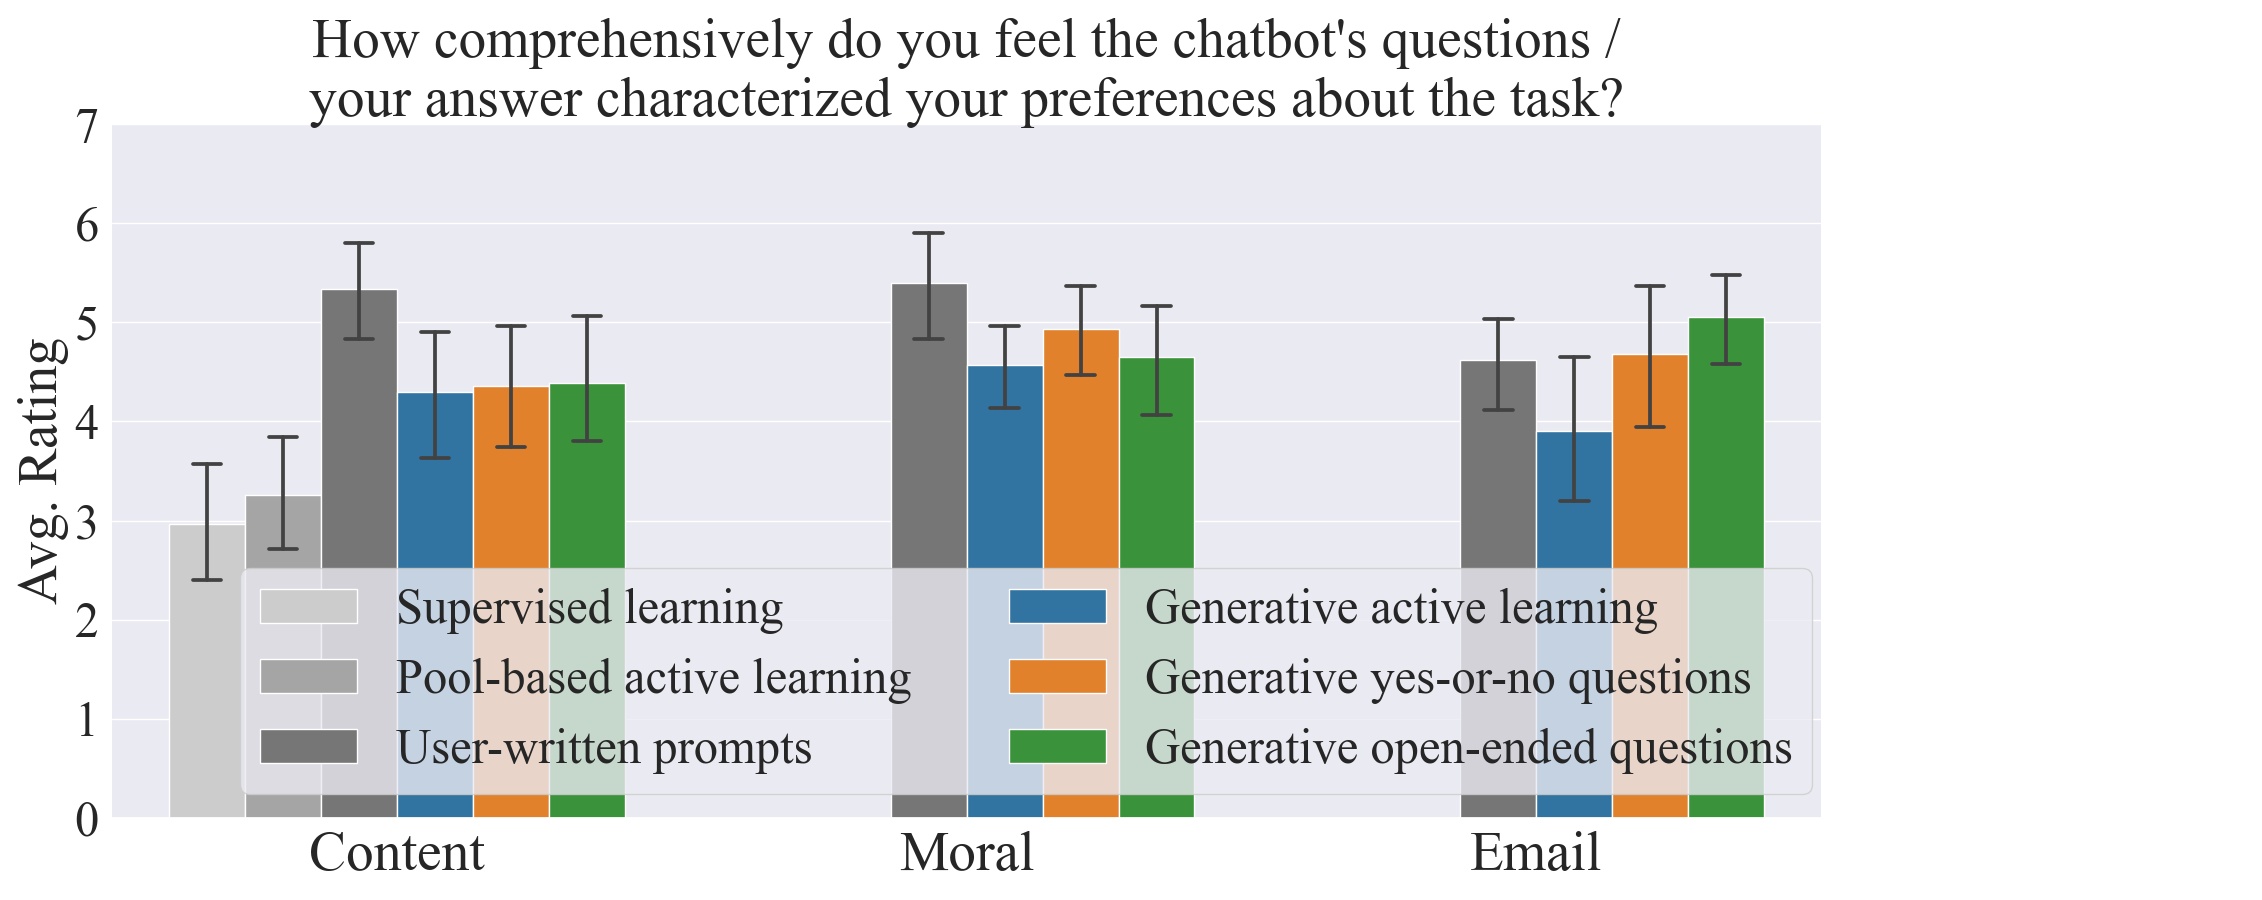
文章提出生成式主动任务探询(GATE)框架,使语言模型通过开放式提问和生成边缘案例主动挖掘用户的模糊偏好,并据此预测用户决策。在内容推荐、道德推理和邮箱验证三个领域的实验中,GATE 的准确率优于或相当于用户自写提示、监督学习和主动学习,且用户心理负担更低,为复杂偏好对齐提供了新工具。

利用语言模型挖掘人类偏好 [译]

宝玉的分享 宝玉的分享 · 2023-10-30T00:00:00Z
  • <<
  • <
  • 1 (current)
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。

1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
友情链接: MOGE.AI 九胧科技 1tok 菜鸟教程 Remio.AI DeekSeek连连 53AI 神龙海外代理IP IPIPGO全球代理IP 东波哥的博客 匡优考试在线考试系统 开源服务指南 蓝莺IM Solo 独立开发者社区 AI酷站导航 极客Fun 我爱水煮鱼 周报生成器 He3.app 简单简历 白鲸出海 T沙龙 职友集 TechParty 蟒周刊 Best AI Music Generator 模力方舟 Gitee AI

小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码