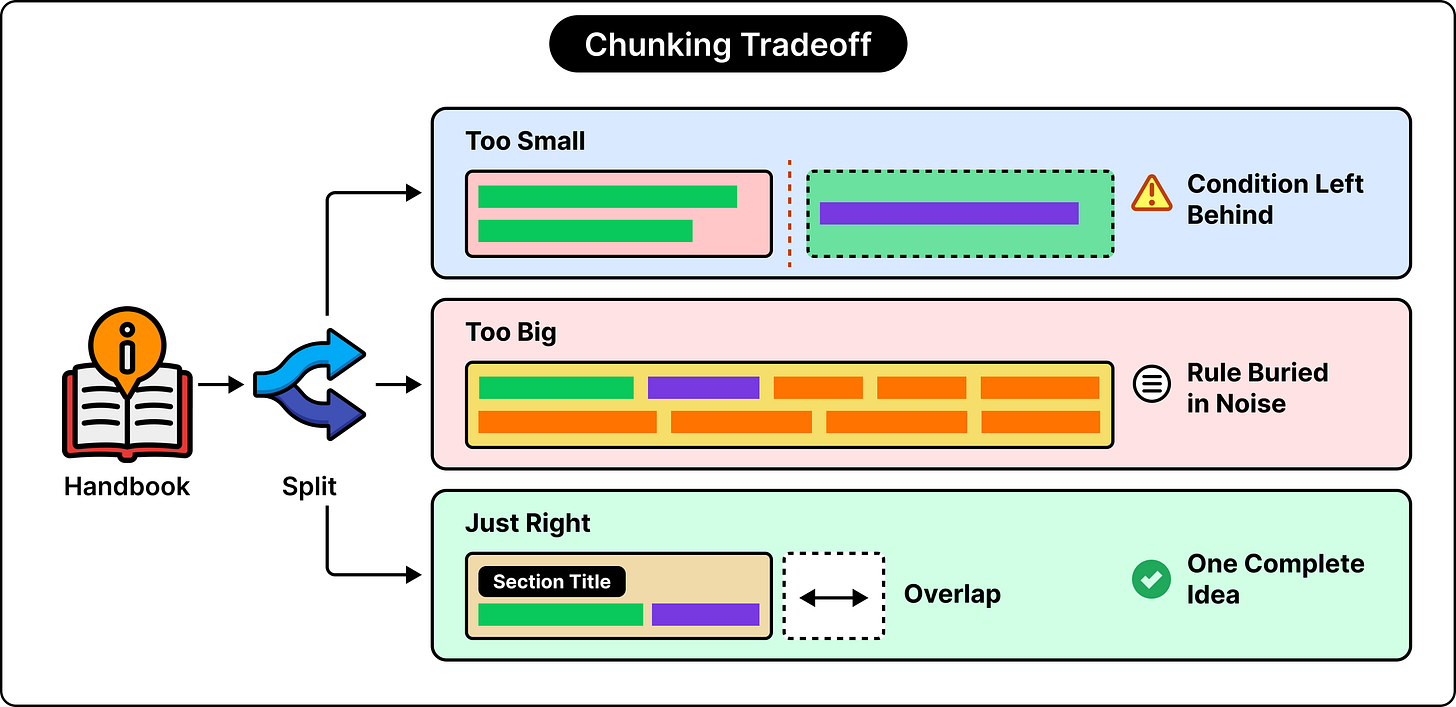
大语言模型回答企业私有文档问题需依赖检索增强生成(RAG):先将文档切分为保留完整语义的块,用嵌入模型转为向量,通过余弦相似度等度量检索;数据量大时采用IVF或HNSW近似搜索,在速度与召回间权衡;还需元数据过滤确保政策版本正确,并配合重排序与混合搜索以找到有效证据。
文章讨论企业AI检索中的权限控制问题。核心观点是:权限不应作为事后过滤器,而应在“上下文组装”阶段结构性执行,即根据用户身份决定模型能看到哪些数据。文章以AWS、微软等平台为例,指出仅靠元数据过滤存在泄露风险,并强调需在系统间传递用户身份,确保授权在每一步被检查。
元数据过滤通过叠加结构化约束(如价格、状态、租户ID)于向量相似性搜索,确保结果既相关又合规,显著提升准确性(如从0.12升至0.61)。预过滤与后过滤影响召回和延迟,混合查询结合关键词与向量搜索增强效果。统一引擎(如Redis)避免数据同步问题,保持一致性,适用于RAG和多租户场景。
本文介绍向量搜索中的过滤技术。以电商搜索为例,说明仅靠语义搜索不够,需结合元数据过滤才能精准匹配。Qdrant采用可过滤向量索引,通过添加特殊链接解决预过滤和后过滤的缺陷。文章还讲解了滚动查询、嵌套过滤、载荷索引及多租户等用法,并建议浮点数用范围过滤。
完成下面两步后,将自动完成登录并继续当前操作。