
大语言模型如何在干草堆中找到一根针
内容提要
大语言模型回答企业私有文档问题需依赖检索增强生成(RAG):先将文档切分为保留完整语义的块,用嵌入模型转为向量,通过余弦相似度等度量检索;数据量大时采用IVF或HNSW近似搜索,在速度与召回间权衡;还需元数据过滤确保政策版本正确,并配合重排序与混合搜索以找到有效证据。
延伸解读
分块策略:在精确与上下文之间权衡
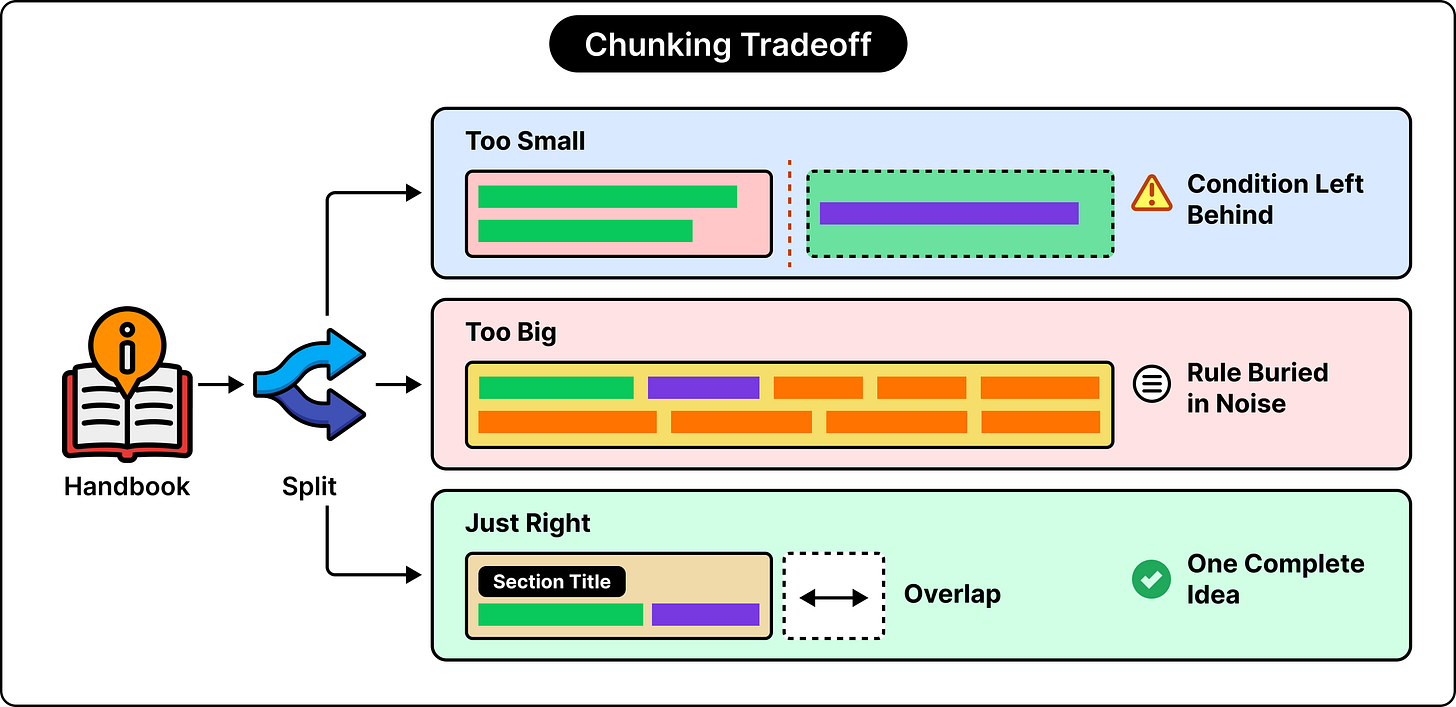
文章指出,将文档切分为块时,小块可能聚焦问题但遗漏例外条件,大块保留例外却混入无关政策。例如,若把“取消航班后住宿可报销”与“仅当航空公司未提供住宿时适用”拆开,助手可能给出错误答案。因此,块应尽量保留完整语义,并利用章节标题和有限重叠来维持上下文。这提醒我们,分块不是简单的技术切割,而是影响检索质量的关键设计决策。
相似度分数的真实含义
文章强调,相似度分数如0.85并不表示有85%的概率正确回答问题,它只描述向量表示之间的数学关系。一个高分段落可能主题相关但属于错误地区政策、已过时或缺少例外条件。因此,相似度只是相关性的证据,而非答案正确性的保证。在实际应用中,需结合元数据过滤、重排序等额外检查,才能将检索到的证据转化为可靠回答。
近似搜索的代价:速度与召回率的权衡
当数据量增大时,精确搜索(Flat)成本过高,IVF和HNSW通过分组或图导航减少比较次数,但都引入近似性,可能漏掉真正最近的向量。文章指出,没有固定的数据量阈值来决定何时切换索引,硬件、维度、查询量、内存和延迟要求都会影响选择。HNSW在内存允许时是强候选,但并非自动最优。调参时需用代表性问题和实际性能测量来评估召回率与延迟的平衡。
元数据过滤与版本管理:确保答案时效性
文章以报销限额从₹5,000提高到₹7,000为例,说明若新旧版本同时可检索,助手可能返回矛盾信息。元数据过滤可限定地区、业务单元和生效日期,但预过滤和後过滤各有局限,图搜索中过滤还可能影响导航路径。更新时,需协调新旧块的替换,避免出现检索空窗或重复。版本标识和明确的活跃版本规则有助于使变更可预测,而更换嵌入模型则需更大规模的重新嵌入规划。
Q&A
大语言模型回答企业私有文档问题时,为什么需要检索增强生成(RAG)?
语言模型本身不知道公司私有文档的内容,必须由应用提供信息。对于大量文档,检索可以选出可管理数量的相关段落,再交给模型生成答案并引用来源,这种模式就是RAG。
文档切分成块(chunk)时,如何平衡精确度和上下文?
块太小可能遗漏例外条件,块太大可能包含无关政策。好的块应尽可能保留完整语义,利用章节标题和有限重叠来维持上下文,使检索到的段落能独立理解。
嵌入向量和相似度度量在检索中起什么作用?
嵌入模型将文本转为向量,使语义相近的文本在向量空间中靠近。相似度度量(如余弦相似度、欧氏距离、点积)用于比较查询和文档向量,找出邻近段落。度量选择应匹配嵌入模型的设计。
为什么不能对每个向量进行精确搜索?IVF和HNSW如何解决?
精确搜索(flat index)需要比较所有向量,计算量随向量数线性增长(O(n)),成本太高。IVF通过聚类分组,只搜索部分组;HNSW构建分层图,通过导航路径快速找到近似最近邻。两者都以近似换效率,需权衡速度与召回。
元数据过滤在检索中有什么作用?预过滤和后过滤有何区别?
元数据过滤用于限定符合条件的文档子集,例如地区、版本、生效日期,确保检索到正确的政策。预过滤先筛选再排序,后过滤先检索再剔除。预过滤不一定更快,取决于过滤选择性和搜索引擎实现。
当政策更新时,如何保持检索系统正确?
嵌入文本变化需要重新生成嵌入,但可复用未变块。仅元数据变化通常无需重新嵌入。更新时需协调版本,避免删除旧块造成空缺或插入新块造成重复,可用版本标识和显式活跃版本规则。更换嵌入模型则需重新嵌入所有文档。
重排序和混合搜索如何提升最终答案质量?
重排序器比较候选段落与问题的文本,选出最相关的几个。混合搜索结合语义检索和关键词检索,既能匹配语义相近的表述,又能保留精确匹配(如政策编号)。两者结合可优化提供给LLM的证据。
