作者用同一篇文章数据分别构建SQL表与RDF图,让三个开源模型通过MCP查询记忆。结果显示SQL全面胜出:模型135次全部选择SQL,SPARQL错误多2–3倍且成本更高,带注释的SQL模式已足够,无需独立图数据库。向量检索方面,Lance在搜索前执行过滤,召回率1.00,索引更小更快;pgvector无过滤时更快,但过滤后会丢失结果。DeepSeek还曾构造SQL注入读取数据。
pg_vectorsearch 是新的开源 PostgreSQL 扩展,其 PRISM 索引内存占用仅为 HNSW 的四分之一,可在 6 毫秒内检索 1 亿条向量,构建时间不到 2 小时。
本文讨论AI数据库选型,需同时兼顾向量检索与事务数据。评估标准包括分支隔离、无服务器扩展、混合搜索、ACID保障和统一访问。文章对比了Pinecone、Weaviate、pgvector、Milvus、Qdrant、Redis、MongoDB Atlas、Chroma及Databricks Lakebase等方案:专用向量库适合大规模检索,pgvector适合已有Postgres环境,Lakebase则整合事务、搜索与分析。选型应依据检索模式、现有技术栈、并发延迟及治理需求。
Databricks 内部应用 Slide Hub 基于 Lakebase Postgres 实现混合搜索,结合向量检索与 BM25 关键词检索,无需独立搜索系统。基准测试显示:8 CU 以下时数据库为瓶颈,8 CU 以上时应用为瓶颈;缓存与索引比例决定命中率,接近 1.0 时延迟稳定。建议索引用 quality 模式、候选数设为 200,生产环境最小 0.5 CU 以避免冷启动。
本文介绍向量数据库Milvus的安装与使用,包括Milvus Lite嵌入式模式和Docker部署Standalone模式,并通过完整实例演示创建Collection、插入数据、向量检索、条件过滤、标量查询和删除操作。同时介绍Milvus CLI命令行工具,涵盖连接服务、数据库与Collection管理、索引创建、加载释放及数据插入、查询、检索、删除等操作。
向量检索擅长按语义找相似文本,但无法证明事实关联。当答案依赖多跳关系(如漏洞库→服务→客户→合同→通知政策)时,应引入Graph RAG:将业务记录建模为节点和有向边,显式记录USES、SUPPORTS、GOVERNED_BY等关系。图回答“什么相连”,原文回答“政策怎么说”,二者缺一不可。遍历需限制边类型、跳数、租户边界与时效,缺失边应如实报告而非推断。
Constella 提出可替换查询模型的检索方案:文档用 Stella 编码一次,查询可用 Zero、Nano 或 Stella 编码,共用同一向量库,无需重新嵌入。Nano 保留 Stella 约 91% 的平均得分,Zero 更快但精度较低。在 15 个 BEIR 数据集上,Nano 查询速度约为 Stella 的 12 倍,Zero 约 480 倍。适合离线搜索、高并发 API 和边输入边搜等场景。
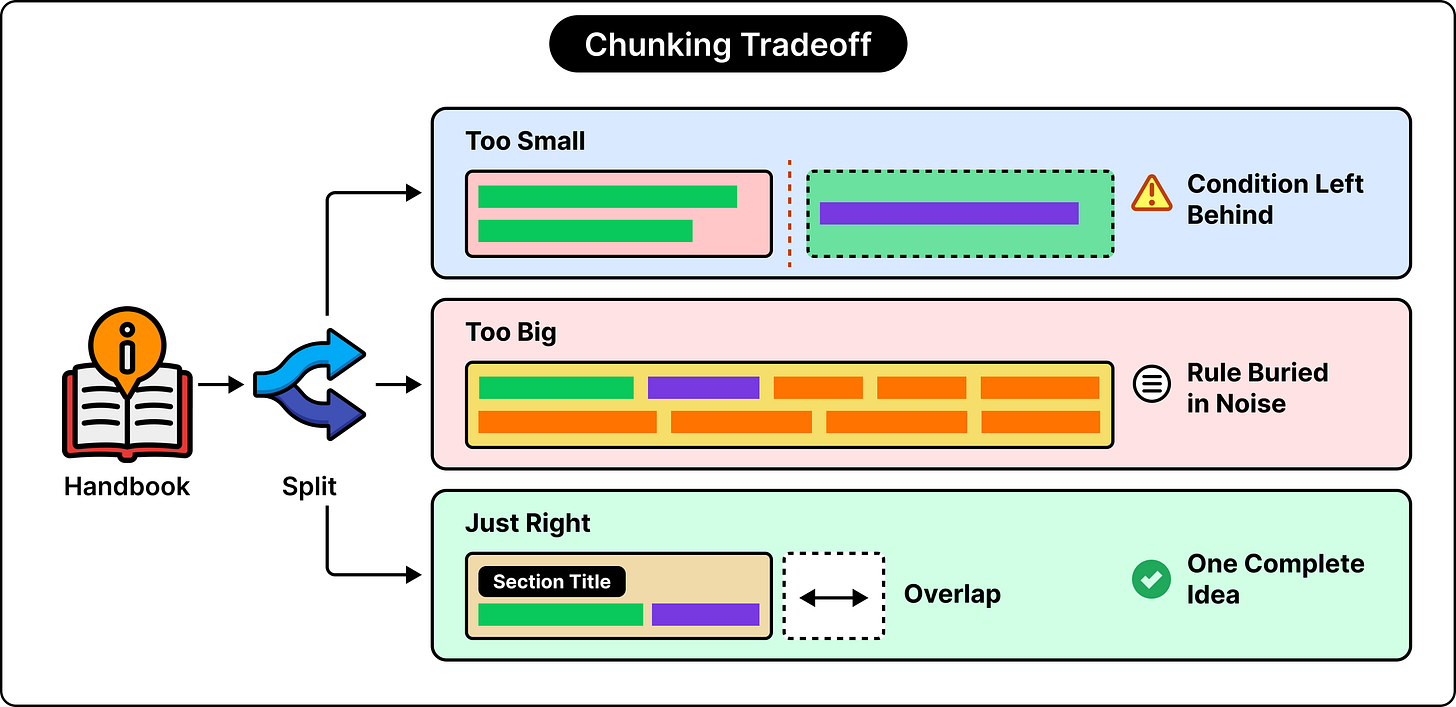
大语言模型回答企业私有文档问题需依赖检索增强生成(RAG):先将文档切分为保留完整语义的块,用嵌入模型转为向量,通过余弦相似度等度量检索;数据量大时采用IVF或HNSW近似搜索,在速度与召回间权衡;还需元数据过滤确保政策版本正确,并配合重排序与混合搜索以找到有效证据。
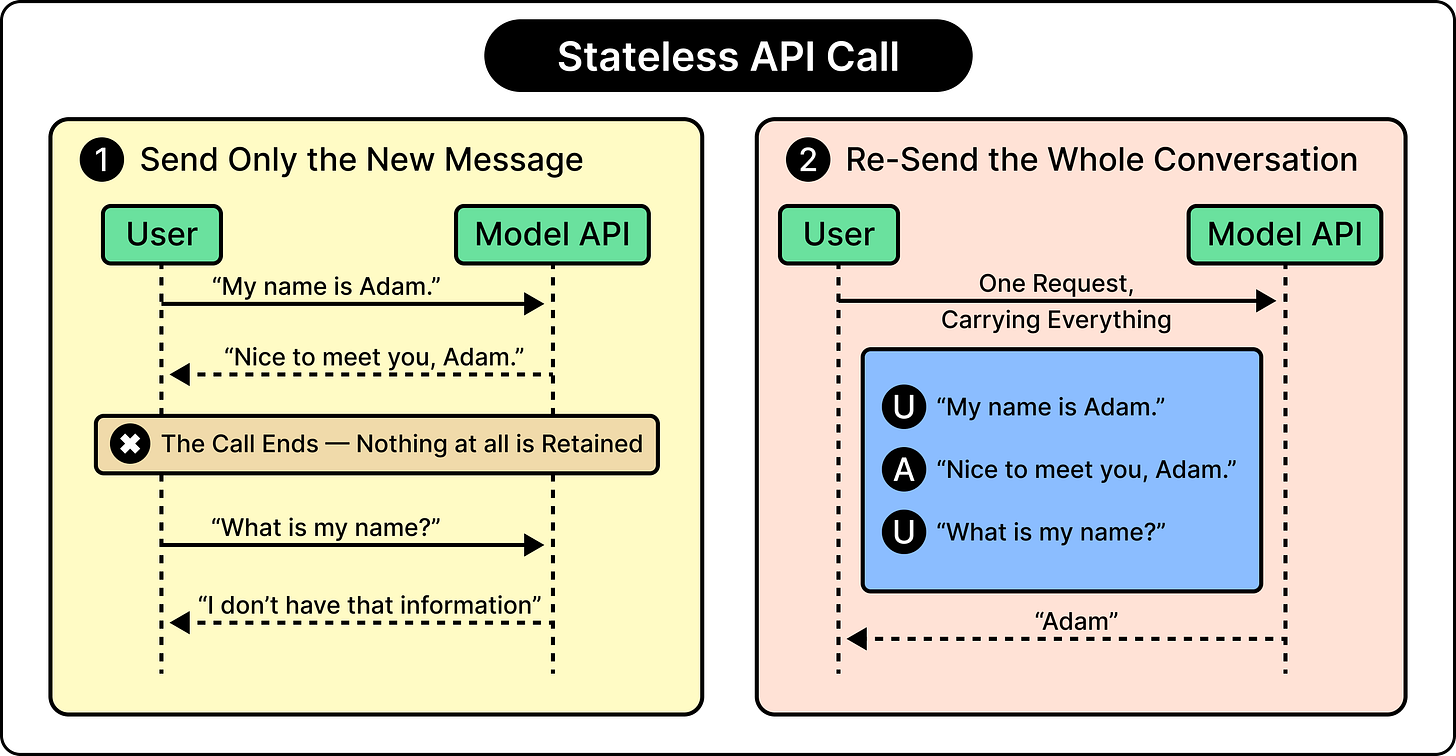
大语言模型无持久记忆,每次API调用均为无状态。对话中的“记忆”实为应用层在每次请求时重新发送历史消息、摘要或检索结果。上下文窗口是容量有限、成本随对话增长的临时工作记忆。为扩展记忆,应用常用滑动窗口、对话摘要、结构化提取、向量检索和用户画像等技术;跨会话记忆仍需将信息重新注入上下文。
RAG仍然存在,但传统的“切片—向量化—Top-K”流水线不应再作为默认方案。Claude Code等转向Agentic Search,通过目录和grep按需查找,效果更佳。在长上下文时代,小知识库可直接放入上下文;向量检索应回归普通工具定位,与全文检索、元数据和权限控制配合使用。PostgreSQL可统一存储与检索,避免跨系统一致性问题。核心是根据语料、成本和延迟进行选型,而非盲目依赖向量检索。
标准RAG仅靠文本分块和向量搜索,无法处理多跳问题或全局总结。GraphRAG通过构建知识图谱,提取实体和关系,结合向量检索与图遍历,实现结构化推理。本文介绍用Python和Neo4j实现GraphRAG,包括定义模式、构建管道和查询,虽成本高但能提升企业AI的推理能力。
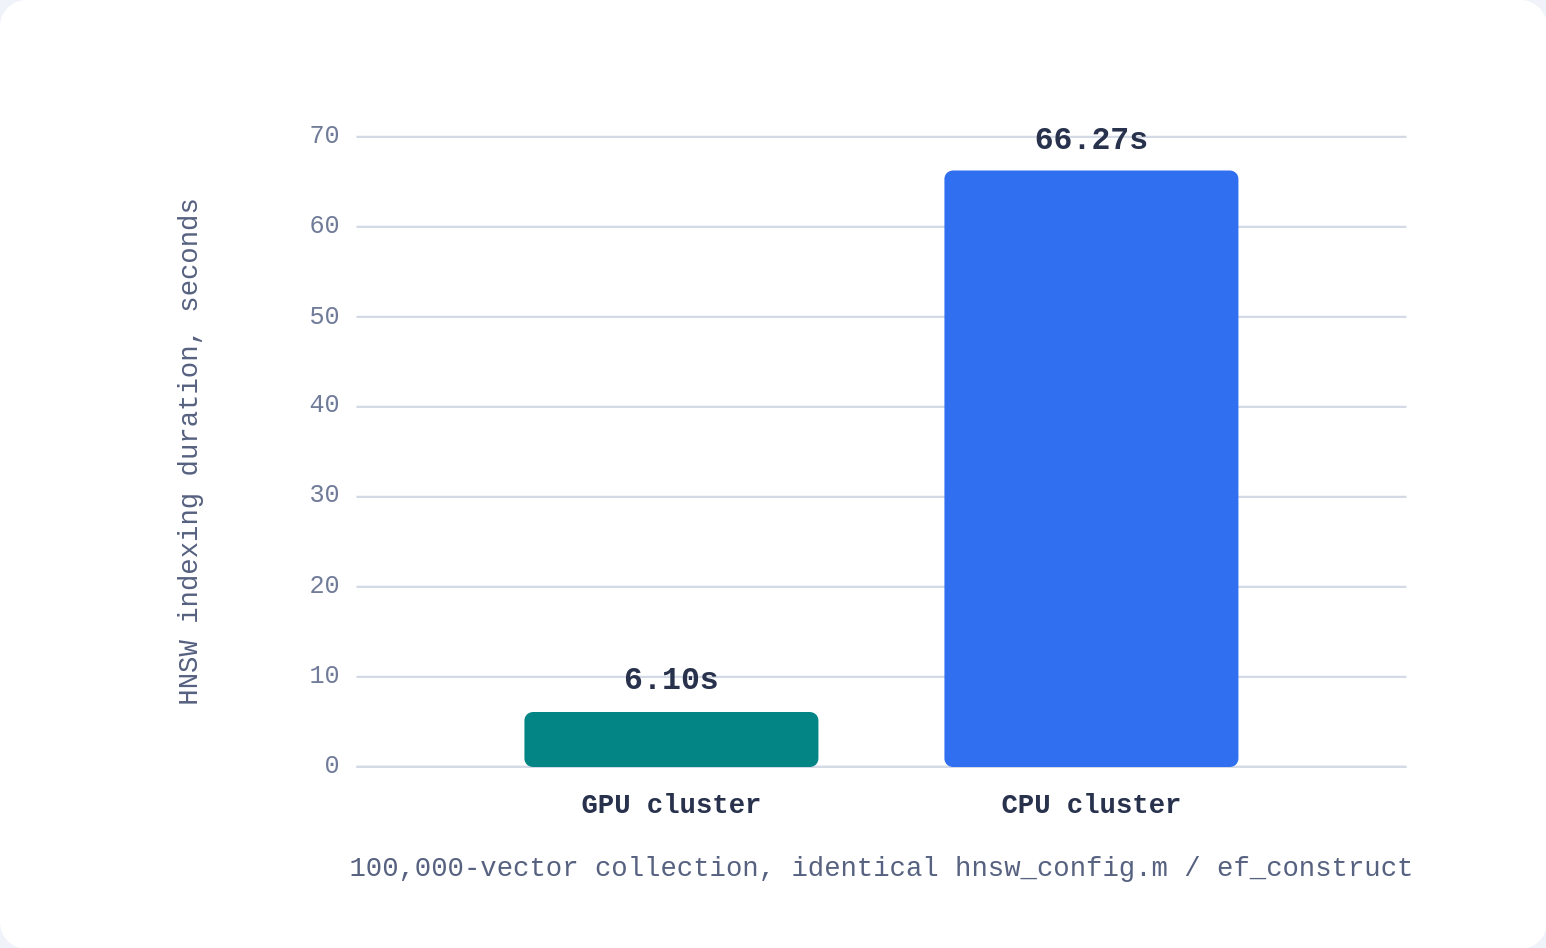
Qdrant 自 v1.13 起支持 GPU 加速 HNSW 索引,可显著缩短向量集合重建索引时间。以 10 万条向量对比:GPU 建索引约 6.1 秒,CPU 约 66.3 秒,约快 10 倍;查询吞吐相近,但 CPU 因索引与查询争抢资源,延迟峰值更高。GPU 适合频繁重建索引或常换嵌入模型的场景,否则闲置 GPU 成本不划算。
本文介绍近似最近邻搜索(ANN)在向量检索中的应用,涵盖暴力搜索、KD-Tree、LSH、HNSW及量化方法,并讨论FAISS索引选型、向量数据库架构及RAG场景实践。强调高维向量检索需平衡精度与速度,常用HNSW或IVF-PQ索引,并注意基准测试陷阱,以Recall@K评估质量。
RAG通过外部知识库检索辅助大语言模型回答,但用户提问与文档表述差异大时,直接嵌入查询效果不佳。HyDE技术先用LLM生成假设性文档,再嵌入该文档而非原始查询进行检索,使向量比较从“问题对答案”变为“答案对答案”,提升检索质量。文章还介绍了HyDE的实现、防幻觉机制及生产环境中的超时、PII保护等保障措施。
黑洞足迹是一款个人地址记录APP,结合AI大模型和向量检索,支持添加图片文字描述、自动分类标签,并通过RAG搜索历史地址。未来计划关联相册、开放MCP接口,方便查询聚餐地点、旅行城市等。技术用Deepseek API、Cloudflare和地图SDK,鼓励用户开发自己的APP。
本文总结了数据库研究的七条主线及2026年的选型决策矩阵,强调AI-Native数据库仍在组件替换阶段,向量检索和HTAP等领域发展迅速。提出12个开放问题,指引未来研究方向,建议工程师关注向量检索和实时增量视图等实际应用。
本文讨论了向量检索引擎Knowhere的架构与索引类型,包括HNSW、DiskANN和IVF-PQ等算法的应用。强调了在训练、构建、加载和查询四个阶段的参数管理,指出Flat索引是金标准但不应作为默认选择。文章还探讨了索引生命周期与段的关系,以及插件契约的实现步骤,提出了多索引参数组合的开放问题。
本文讨论了对象存储在Milvus 2.6.x版本向量检索引擎中的应用。对象存储用于保存日志快照、索引文件和查询结果,布局从按字段拆分转向按段整合,以减少API调用次数和延迟。文章还探讨了数据处理路径、索引对象与数据对象的生命周期差异,以及与湖仓对象布局的对比,强调了优化存储布局的重要性。
本文讨论了Milvus 2.6.x的数据处理架构,重点介绍了Growing和Sealed段的查询机制。Growing段由Streaming Node处理,实时更新;Sealed段由Query Node加载历史数据。Query Delegator负责生成查询计划并合并结果。Segcore作为段级执行层,与Knowhere索引内核协同工作,实现高效的向量检索。文章还探讨了查询过程中的数据加载、索引管理及动态更新与不可变索引之间的平衡。
本文讨论了Milvus 2.6.x版本向量检索引擎中通过多级归并树实现高效搜索的方法,重点介绍了查询路径、Query Delegator的作用及一致性模型对搜索延迟的影响,并强调了分布式搜索的复杂性和一致性管理的重要性。
完成下面两步后,将自动完成登录并继续当前操作。