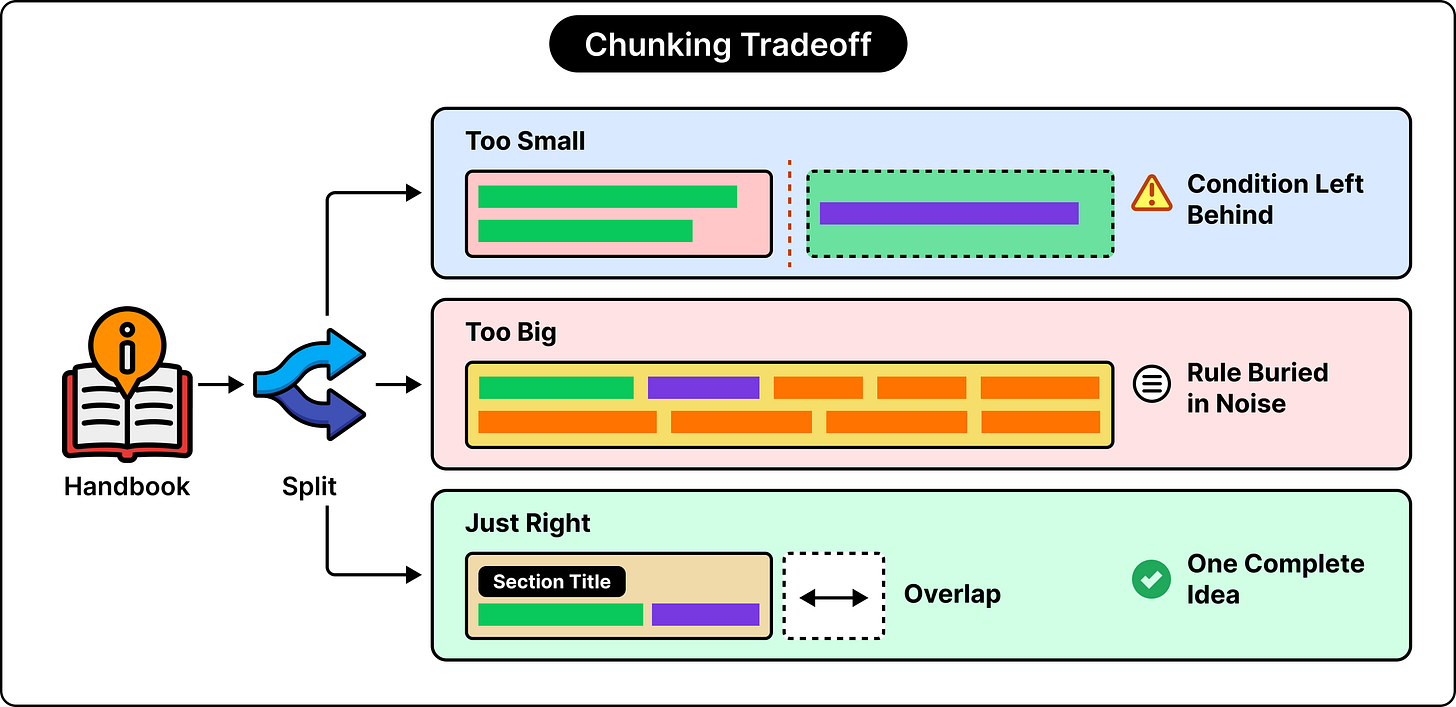
文章介绍了决策模型Jev在分类任务中的实验,测试了重排序、减少重复结果、查询理解和语义分块。重排序中Jev优于交叉编码器,但迭代法收益有限;结合MMR可兼顾相关性与多样性;查询理解需谨慎过滤,短查询易误判;语义分块在QASPER上IoU提升13%。建议RAG优先用其分块,产品搜索结合MMR,查询理解潜力大但需更多验证。
搜索效果差时,不应只升级重排序模型。大规模重排序成本高、延迟大,且候选池本身没有好结果时重排序也无能为力。更优方案是将检索设计为多阶段漏斗:先用低成本词法、向量或混合检索生成大量候选,再逐步收窄,最后才用机器学习重排序。该思路同样适用于RAG,需权衡召回率、相关性、延迟与成本。
大语言模型回答企业私有文档问题需依赖检索增强生成(RAG):先将文档切分为保留完整语义的块,用嵌入模型转为向量,通过余弦相似度等度量检索;数据量大时采用IVF或HNSW近似搜索,在速度与召回间权衡;还需元数据过滤确保政策版本正确,并配合重排序与混合搜索以找到有效证据。
本文基于五个数据集,系统分析了向量搜索中七个关键设置、检索深度、融合参数、重排序器及量化重打分的影响,指出默认参数常导致性能下降,如RRF的k值调整可显著影响结果。建议先检查基础设置,再针对检索不足、排名错误或延迟增加等问题,采取数据驱动的调优策略,以科学提升搜索质量。
本文介绍RAG流水线中的重排序(reranking)层,旨在解决检索结果中相关文档排名靠后的问题。文章比较了交叉编码器、双编码器和LLM重排序器三种模型类型,强调选择需权衡延迟、成本和语言覆盖。生产实践中,建议采用混合检索提升召回率,并注意校准阈值、控制成本,Redis Iris可集成这些功能以优化性能。
Burrows-Wheeler变换是一种重排序算法,通过聚合重复字符串来提高压缩效率。虽然不减少数据长度,但能显著提升后续压缩算法(如Gzip)的效果。该算法的排序逻辑独特,从字符串末尾开始比较,最终实现有效排序。
BGE系列模型包括多语言文本嵌入模型BGE-M3和重排序模型BGE-Reranker-v2-M3,支持高效推理。TEI框架简化了模型部署,适用于自然语言处理任务。结合TEI和vLLM可构建高性能AI应用,提升检索和生成的准确性与效率。
大型语言模型在重排序任务中的表现不如专用重排序模型rerank-2.5,后者在成本、速度和准确性上均有优势。研究显示,rerank-2.5比LLM便宜60倍、快48倍,且准确率提高15%。最佳效果需结合强大的初步检索与专用重排序器。
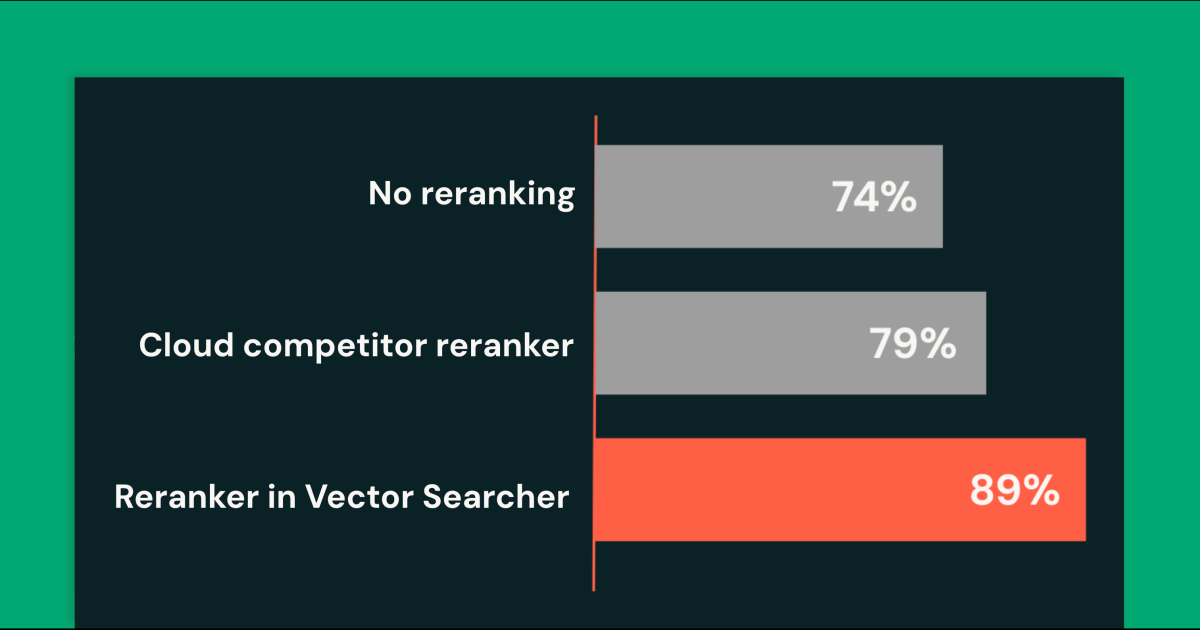
许多组织在构建AI代理时面临的主要挑战是上下文而非模型。Mosaic AI的重排序功能提高了检索准确性,平均提升15个百分点,确保代理获取最相关的数据,从而提升回答的质量和一致性,适用于高质量的RAG代理系统。用户通过简单的参数设置即可快速实现高质量检索,显著改善代理性能。
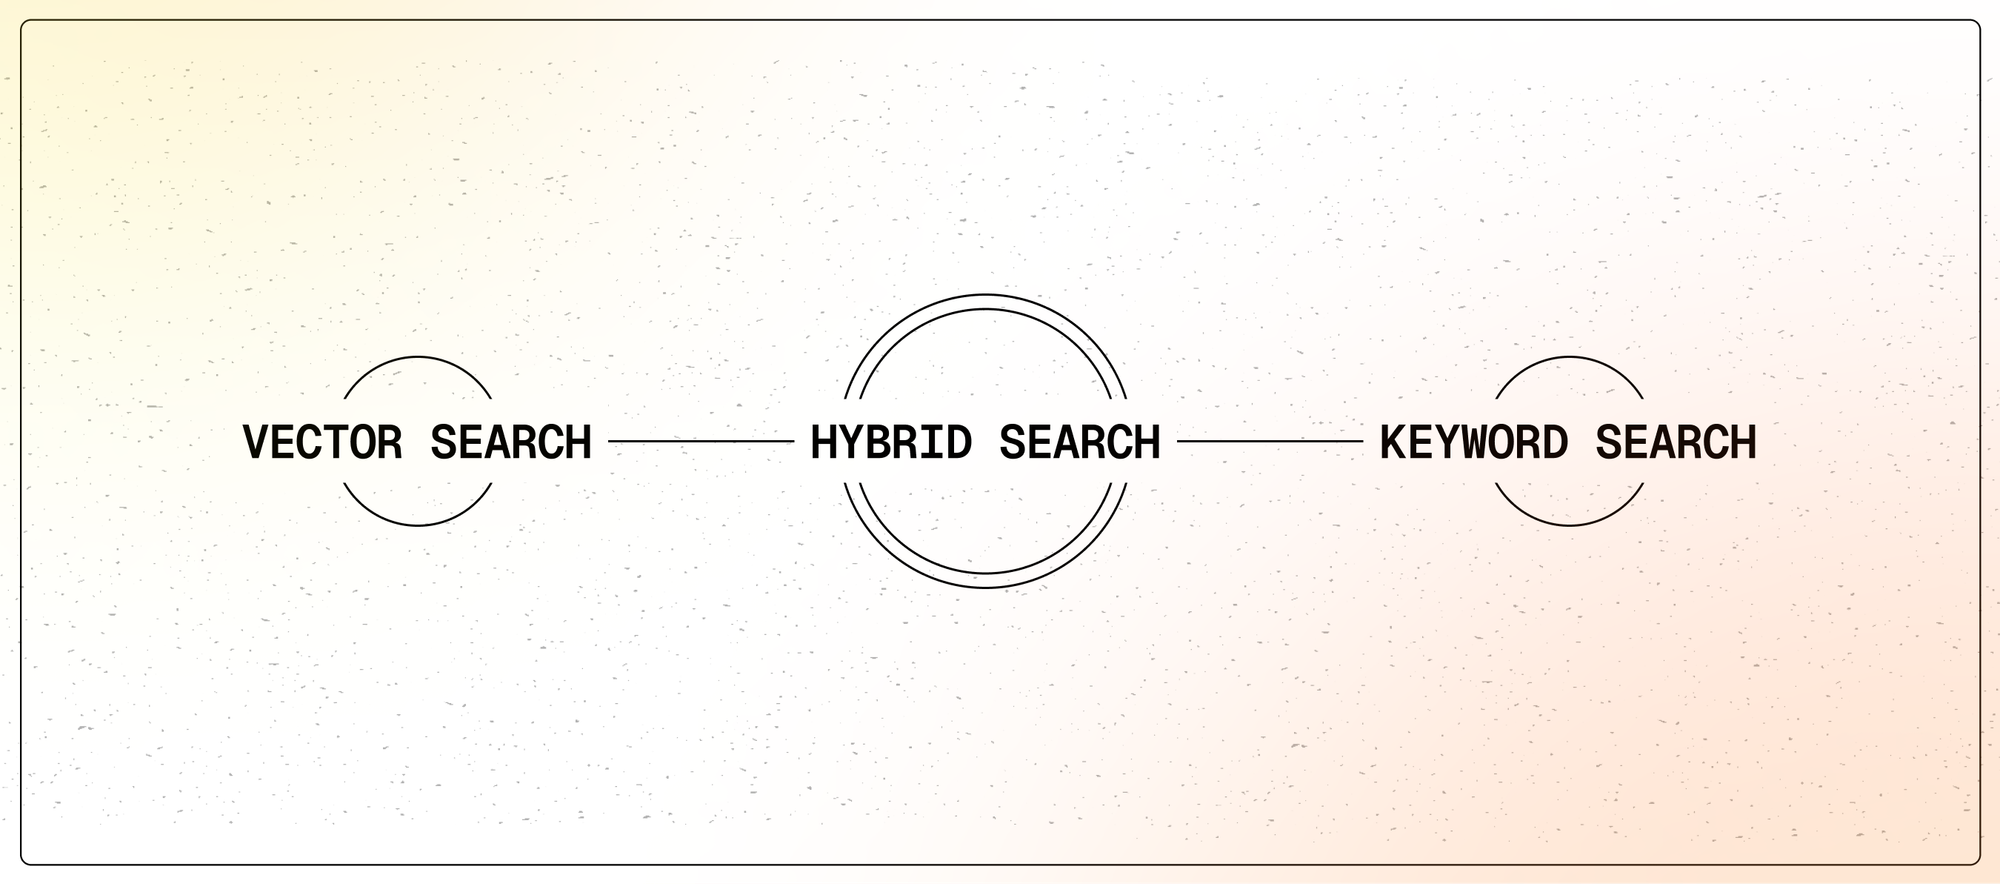
文章讨论了向量搜索在AI中的局限性,强调混合搜索与重排序的重要性。虽然向量搜索能提供相似性,但用户更关注相关性。通过结合多种搜索技术,混合搜索能更有效地满足用户需求,提高搜索结果的准确性和相关性。
该研究提出了一种基于图的重排序方法(GRADA),旨在应对检索增强生成框架中的对抗文档攻击。实验结果表明,该方法将攻击成功率降低至80%,且仅造成微小的准确度损失。
本文介绍了构建检索增强生成(RAG)系统的高级技术,包括查询扩展与重构、混合检索(稠密与稀疏方法)以及多阶段检索与重排序。这些技术通过生成多种查询变体、结合稠密与稀疏向量的优点,以及初步快速检索与后续精确重排序,显著提升了RAG系统的性能和应用效果。
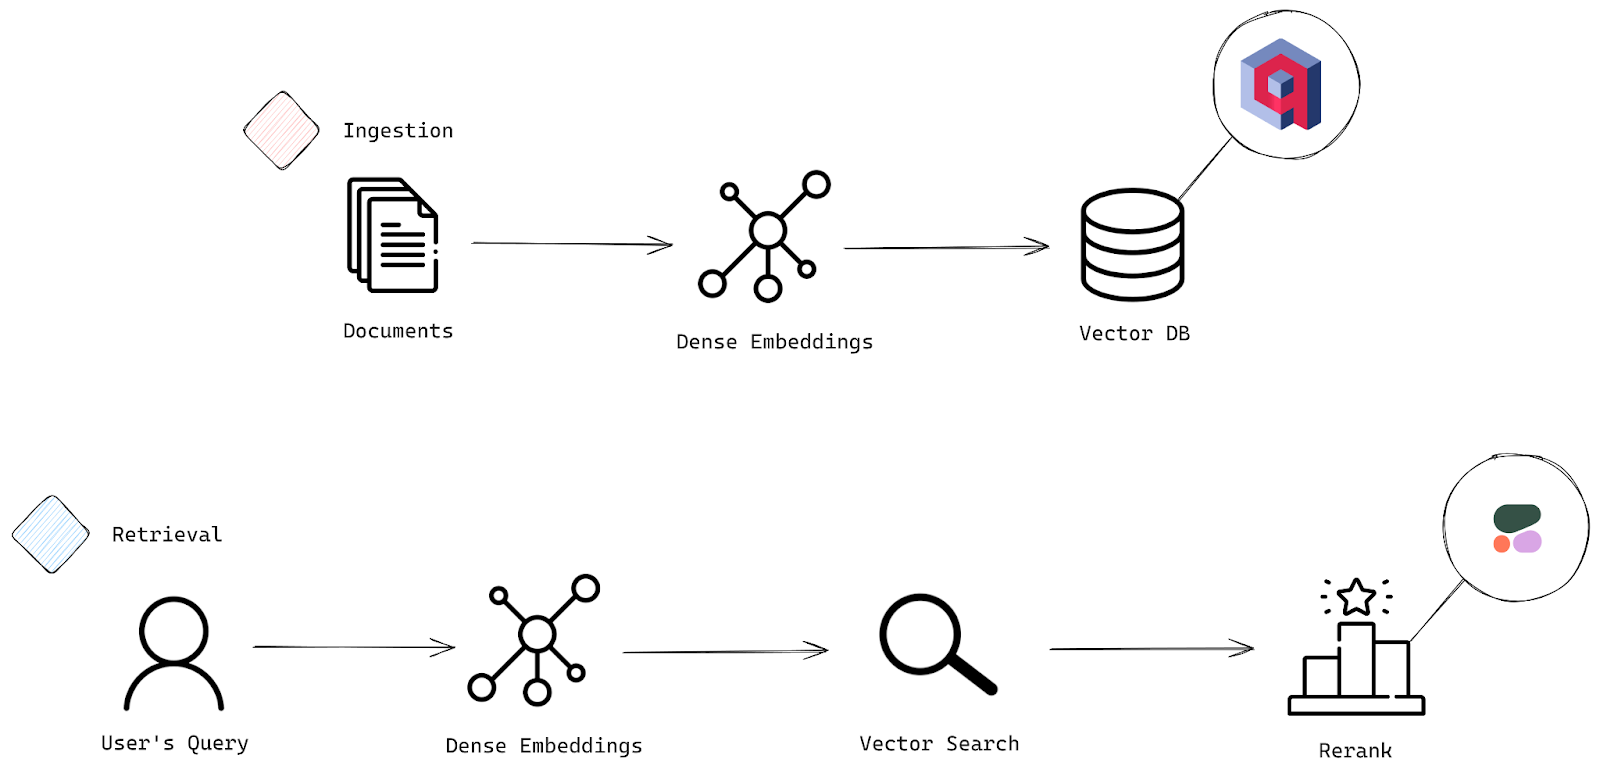
本文介绍在Qdrant向量数据库中结合重排序提升RAG检索精度:先通过向量检索获取高召回候选,再用Cohere Rerank或ColBERT等模型按相关性重新排序以提高精确率。文中以Cohere为例演示创建集合、生成嵌入、检索与重排的完整流程,并指出重排可显著改善约72%查询的顶部结果。
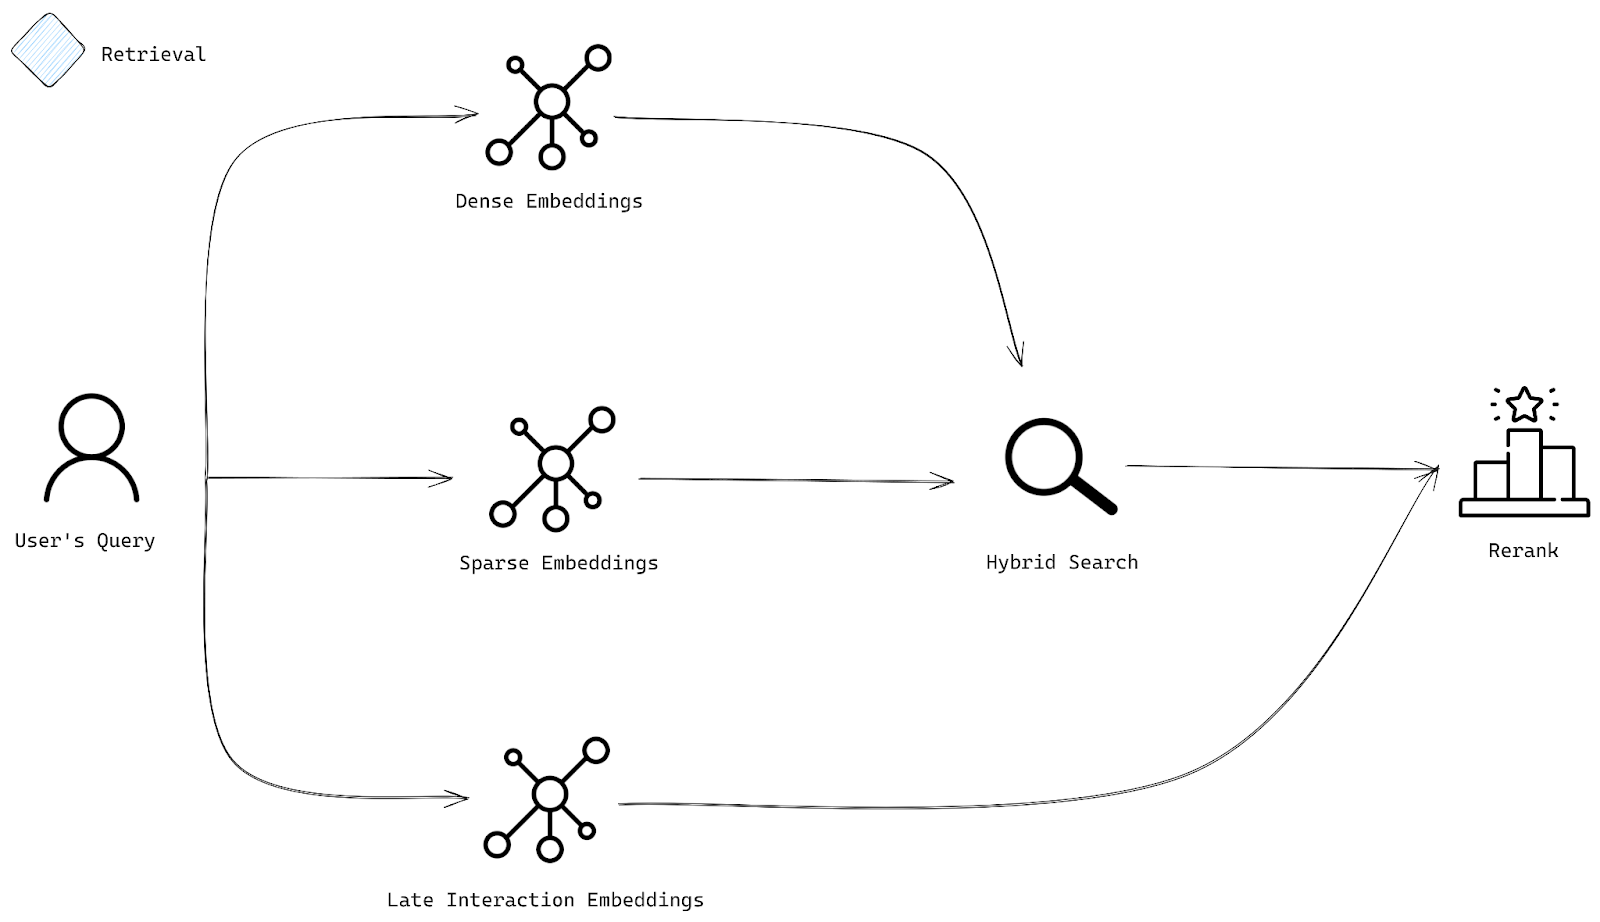
本教程介绍在 Qdrant 中构建混合搜索并结合重排序:使用稠密嵌入进行语义搜索、稀疏 BM25 进行关键词搜索,再用 ColBERT 后期交互模型对候选结果重排序。数据以三种嵌入存入集合,检索时并行预取稠密与稀疏结果,最后用多向量模型精排,可显著提升相关性,但需权衡成本与延迟。
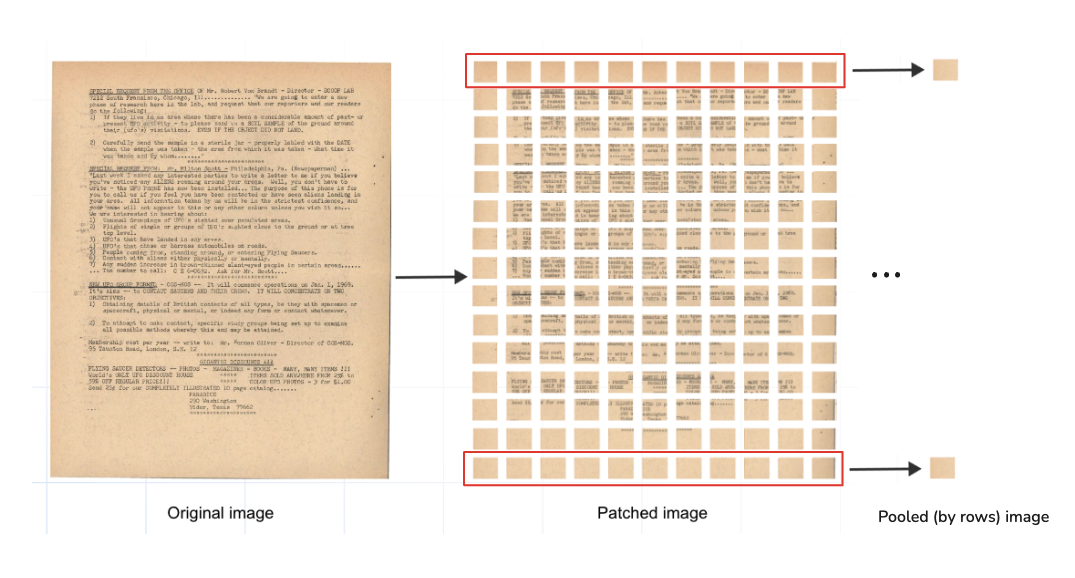
ColPali在文档检索方面取得显著进展,通过结合池化和重排序策略,检索速度提高了13倍,同时保持高精度。实验中,池化将每页的1030个向量减少到38个,使用轻量级向量快速检索前200个候选,再通过高分辨率向量重排序,最终得到前20个结果。未来将探索更多优化方法。
该研究提出了一种将重排序视为贝叶斯优化问题的方法,以降低机器翻译系统中候选列表重排序的计算成本,减少评分次数,同时保持与基线相当的翻译质量,从而提高资源利用效率和潜在翻译质量。
本文探讨了融合检索在RAG系统中的应用。融合检索通过整合多个信息流,提升检索的上下文相关性,从而改善LLM生成的响应。与传统RAG不同,融合检索在处理多个文档时采用重排序和聚合等复杂机制,以提高输出质量。重排序优化文档顺序,使最相关的信息更易提取。
本文介绍了混合检索和重排序技术在提升RAG系统文档召回效果方面的作用。通过实验数据评估和测试结果分析,突出了混合检索+重排序在不同场景下的优势。混合检索结合了向量检索和关键词检索的优点,弥补了它们的缺陷。重排序通过重新排序候选文档列表,改进语义排序的结果。混合检索+重排序被认为是改进文档召回相关性的有效方法。文章还提到了Azure AI对这些技术进行的实验数据评估。
该文综述视觉定位与地点识别研究,涵盖EigenPlaces多视角聚类、PlaceFormer和TransVPR等Transformer方法、连续描述符回归及语义外观技术,通过改进相似性标签、重排序和特征聚合,提升识别精度并降低计算与存储开销。
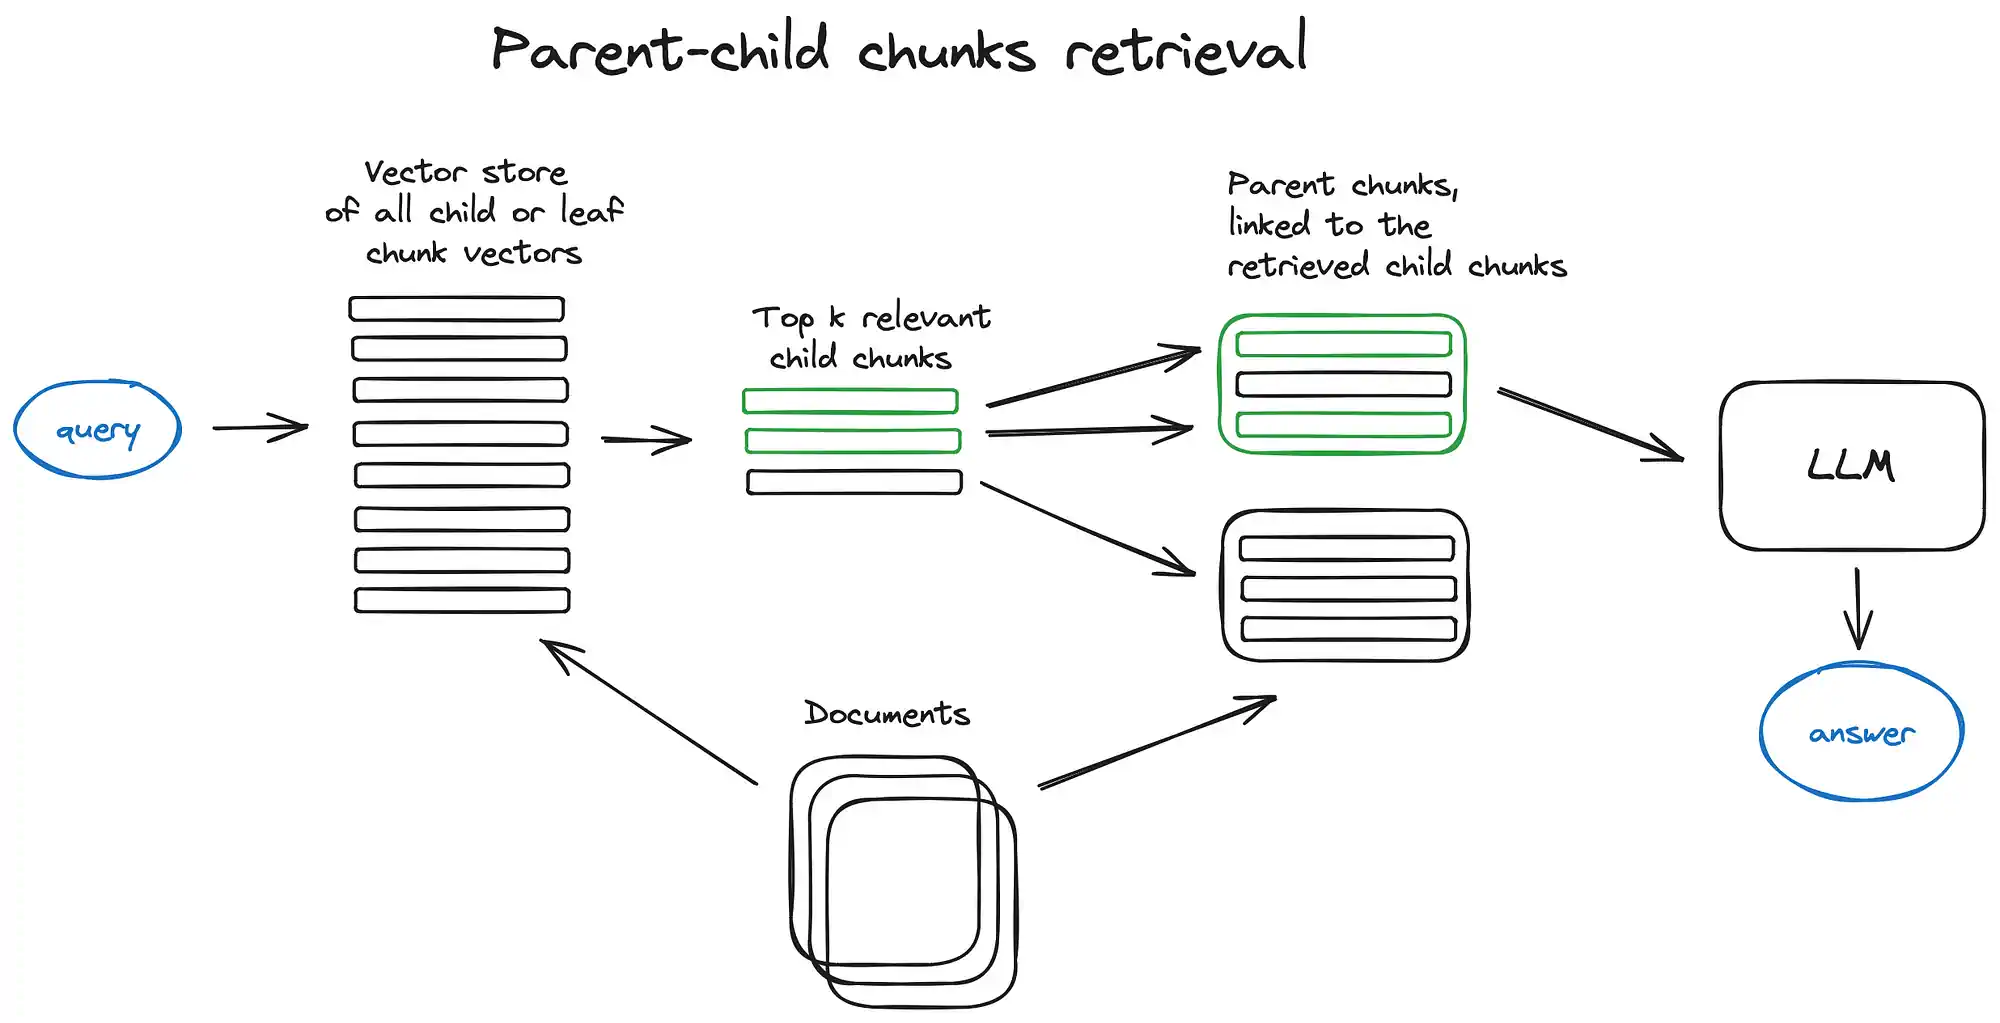
本文系统梳理高级RAG(检索增强生成)技术:先介绍标准流程——分块、向量化、索引、检索并生成答案;再详解进阶方法,包括分层索引、假设性问题与HyDE、句子窗口与父文档等语境增强、融合检索、重排序过滤、查询变换与路由、聊天引擎、多文档智能体及响应合成;最后讨论编码器、排序器与大语言模型微调及RAG评估指标。
完成下面两步后,将自动完成登录并继续当前操作。