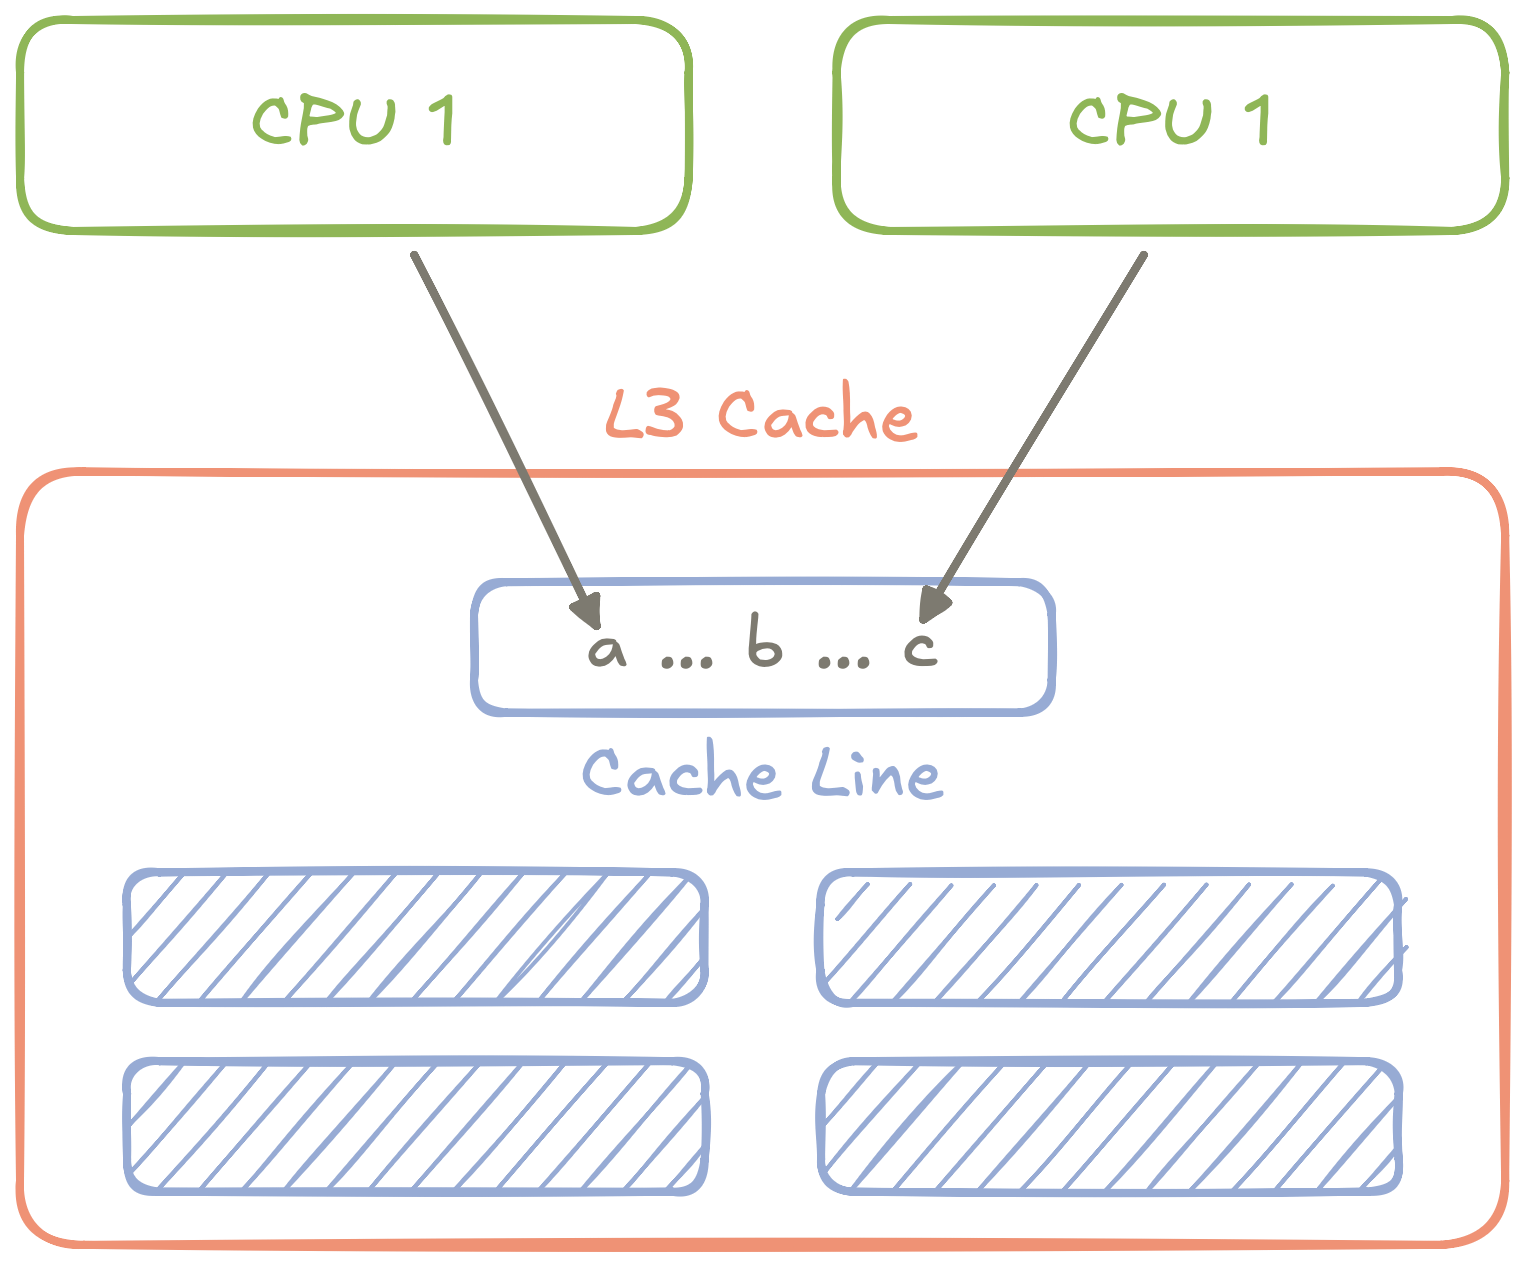


现代硬件性能强大,但软件往往未能充分利用。机械同情是指开发与硬件相适应的软件,其原则包括可预测的内存访问、缓存行意识、单写者原则和自然批处理。这些原则有助于优化AI推理服务器和分布式数据平台。通过理解CPU的内存存储和访问方式,开发者可以提升性能,避免虚假共享等问题。优先考虑可观察性和明确性能目标是有效优化软件的关键。
在CSAPP缓存实验中,学生编写C程序模拟缓存内存,参数包括缓存组数、每组行数、块大小和内存地址位数。程序处理内存访问,采用LRU替换策略,最终统计命中、未命中和驱逐次数,加深对计算机系统核心概念的理解。
CSAPP缓存实验要求学生编写C程序模拟缓存内存,定义缓存的参数包括组数、每组行数、块大小和内存地址位数。程序处理加载、存储和修改数据的内存访问操作,并采用LRU策略进行缓存替换。通过构建模拟器,学生加深了对计算机系统核心概念的理解,并为优化实际代码奠定基础。
朋友在使用HyperMesh2025时遇到分段错误,可能由内存访问违规、软件兼容性或系统资源不足引起。解决方法包括检查兼容性、释放内存、删除临时文件、修复或重装软件、检查更新和审查错误日志。尽管服务器配置高,仍需关注电脑配置是否足够。
ACCESS_ONCE() 是 Linux 源码中的宏,确保编译器不会合并或重新获取对标量类型的访问。它通过将变量转为 volatile 类型,防止编译器优化引发错误。READ_ONCE() 和 WRITE_ONCE() 适用于非标量类型,主要用于进程与中断处理之间的通信,确保内存访问顺序性。
在GSoC 2025项目中,Pedro Lobo为LLVM IR引入了新的字节类型,解决了内存访问问题,改进了memcpy和memcmp等内置函数,提升了优化能力,且对性能影响极小。
CUDA核心转储是一种有效的调试工具,用于解决内存访问问题。通过设置环境变量,可以在发生非法内存访问时生成核心转储文件,帮助开发者准确定位问题,尤其在复杂的CUDA图中。建议使用特定的环境变量组合以优化调试体验。
现代计算机的性能瓶颈已转向内存访问,缓存无关算法在所有层级缓存上实现最优性能,无需了解缓存参数。通过递归分解问题,缓存无关算法自动适应缓存大小,适用于矩阵运算和优先队列等场景,尽管常数因子较大,但其理论价值在于揭示了不依赖硬件参数的通用最优策略。
C# 14引入了Span<T>和ReadOnlySpan<T>,支持隐式转换,简化数组和字符串等数据结构的操作。这些类型安全高效,避免堆分配,适合高性能内存访问。建议在需要可变性时使用Span<T>,否则使用ReadOnlySpan<T>。
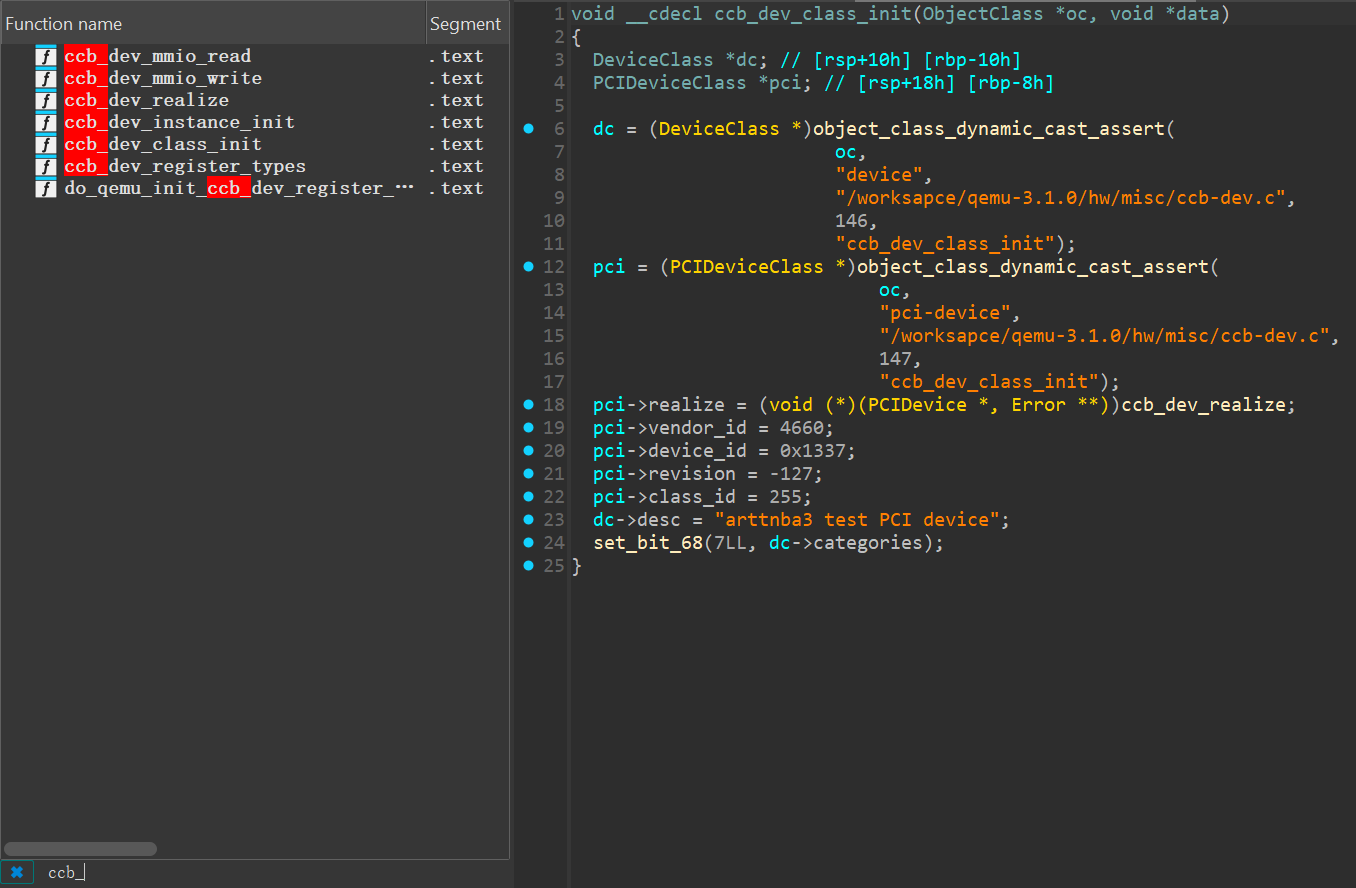
本文探讨了QEMU虚拟机逃逸的基本概念和技术细节,重点分析了如何利用有漏洞的PCI设备实现虚拟机对宿主机内存的访问。文章详细介绍了PCI设备的结构、MMIO和PMIO的访问方式,以及通过特定代码进行内存映射和输入输出操作,从而实现对宿主机的控制。
C#中的Span<T>类型显著提升数据处理性能,尤其在重构foreach循环时。它提供高效的内存访问,避免不必要的内存分配,性能提升可达300%。使用时需注意数据生命周期的安全性,掌握Span<T>是提升C#开发性能的关键。
大型语言模型(LLMs)在自然语言处理领域取得了突破,但因运行成本高而难以广泛应用。本文提出了一种新颖的后训练压缩方法SeedLM,通过伪随机生成器的种子编码和压缩模型权重,利用线性反馈移位寄存器生成随机矩阵,结合压缩系数重构权重块。SeedLM减少内存访问,提升内存密集型任务的速度,且无需校准数据,适用于多种任务。实验表明,SeedLM在4位和3位压缩下的零-shot准确率与最先进方法相当,并在FPGA测试中显示出显著加速效果。
变压器架构在人工智能任务中广泛应用,尤其是大型语言模型。注意力层是性能瓶颈,需优化。分析显示,预填充阶段计算密集,解码阶段则内存密集。优化注意力层可提升性能,减少内存访问是关键。
本文讨论了Bochs在x86_64长模式下的内存访问流程,特别是TLB(翻译后备缓冲区)的设置。强调在不允许通过主机指针直接访问页面时,TLB应设置TLB_NoHostPtr位,未设置该位的直接访问请求会导致TLB未命中。
本文讨论了Bochs的代码阅读和黑客技巧,重点介绍了CPU的基本循环、内存访问流程及多处理器配置的实现。还提到如何使用宏定义简化函数调用,并解释了指令执行和内存操作的细节。
DMA(直接内存访问)是一种高效的数据传输方法,允许数据直接从一个地址空间复制到另一个地址空间,实现外设和内存之间的快速数据传输。DMA消除了CPU参与数据传输的需求,使其能够专注于更复杂的任务。DMA可用于各种数据传输场景,如外设到内存、内存到外设、内存到内存和外设到外设。DMA参数包括源地址、目标地址、数据传输大小和传输模式。DMA通道可以配置不同的优先级,并可为各种事件生成中断。DMA可以显著提高微控制器系统中的数据传输效率。
该项目旨在将LLVM值映射到源级表达式,以提高代码优化效率。通过分析通道识别加载和存储指令,成功生成与内存访问相关的源表达式,帮助开发者理解内存访问模式。尽管在处理复杂结构时遇到挑战,项目为LLVM社区的贡献奠定了基础,未来计划支持复杂数据类型和多种源语言。
文章讨论了从CPU层面优化程序性能的重要性,强调实现效率而非仅依赖算法优化。分析了内存访问效率、CPU缓存和数据结构设计,指出嵌套结构体和频繁内存访问会降低性能。建议使用局部变量减少内存访问次数,并优化数据结构以提高缓存命中率。此外,比较操作和switch语句的优化也被提及,以提升代码执行效率。
完成下面两步后,将自动完成登录并继续当前操作。