Databricks推出Lakehouse//RT,专为AI代理和实时分析的高并发查询设计,可直接在湖仓上运行,无需复制数据或搭建独立实时层。它通过提升单节点并发、加快查询完成速度、按节点小步扩容,避免成本随查询量同比例增长。Aurasell、VisionHeight和nOps等客户报告查询提速、成本大幅下降且架构简化。
信创已从可选项变为央国企及关键行业采购的必选项,2027年前是阶段性履约节点。文章从政策、供应链安全、合规审计、工具链四方面分析原因:政策将国产化率与投标资格绑定;供应链安全要求自主可控;合规上国产化便于闭合证据链,但不等于更安全;研发工具链若遗漏会导致验收不通过。建议按盘点、对齐口径等步骤推进,具体比例以主管部门通知为准。
玩美移动为日本趣天平台提供AI肤质分析与AR美瞳试戴功能,覆盖超3000万注册用户。自2026年8月起,用户可在美瞳商品页通过手机摄像头实时预览上眼效果,AR引擎可精准追踪面部运动并渲染虹膜。美妆频道还上线AI肤质分析,用户上传一张照片即可检测水分、毛孔、痘痘等10项肌肤维度并给出评分。
企业BI存在数据分散、报表耗时、洞察不足等问题。AI可通过自然语言问答简化数据获取,辅助跨指标分析,并生成可分享的数据叙事与预警。成功采用需以可信数据为基础,统一指标定义,落实权限安全,确保结果可验证,保留人工监督,并持续监测准确性与应用价值。现代BI平台为AI分析提供治理基础。
ReSharper C++ 2026.3 新增类布局工具窗口,可可视化类、结构体和联合体的内存布局,显示字段偏移、大小、填充及虚表指针,便于发现浪费空间。格式字符串分析扩展至 std::format、std::print 和 {fmt} 库,并支持 C23 printf 格式符、Unreal 日志宏及构造函数格式属性。重构改进包括构造函数 Change Signature、Extract Method 放置选项和 Introduce Using Directive。此外更新 Clang-Tidy 至 LLVM 23,新增 CUDA 检查,支持更多 C++23/26 特性,并优化 Visual Studio 集成。
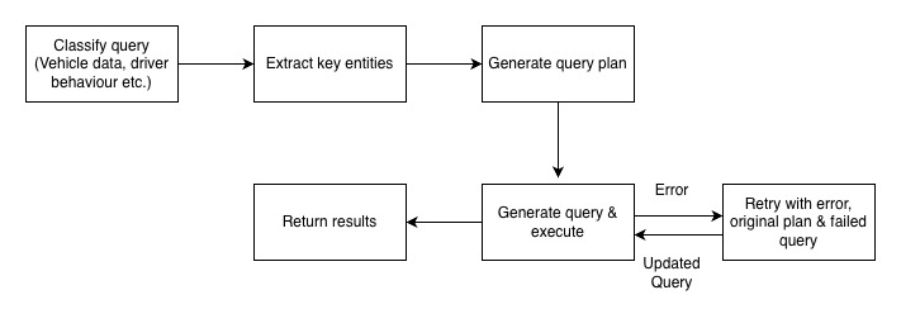
Novus Hi-Tech与AWS团队合作,基于Strands Agents SDK和AWS托管AI服务构建多智能体系统FleetGPT,将车队物联网数据转化为实时安全干预,支持自然语言查询、自动事件调查和多语言AI语音呼叫司机。成效包括道路行为违规减少46%、每千公里疲劳驾驶警报下降55%、燃油效率提升3–6%、警报验证从数分钟缩短至数秒。未来将扩展预测性风险评分和图表生成能力。
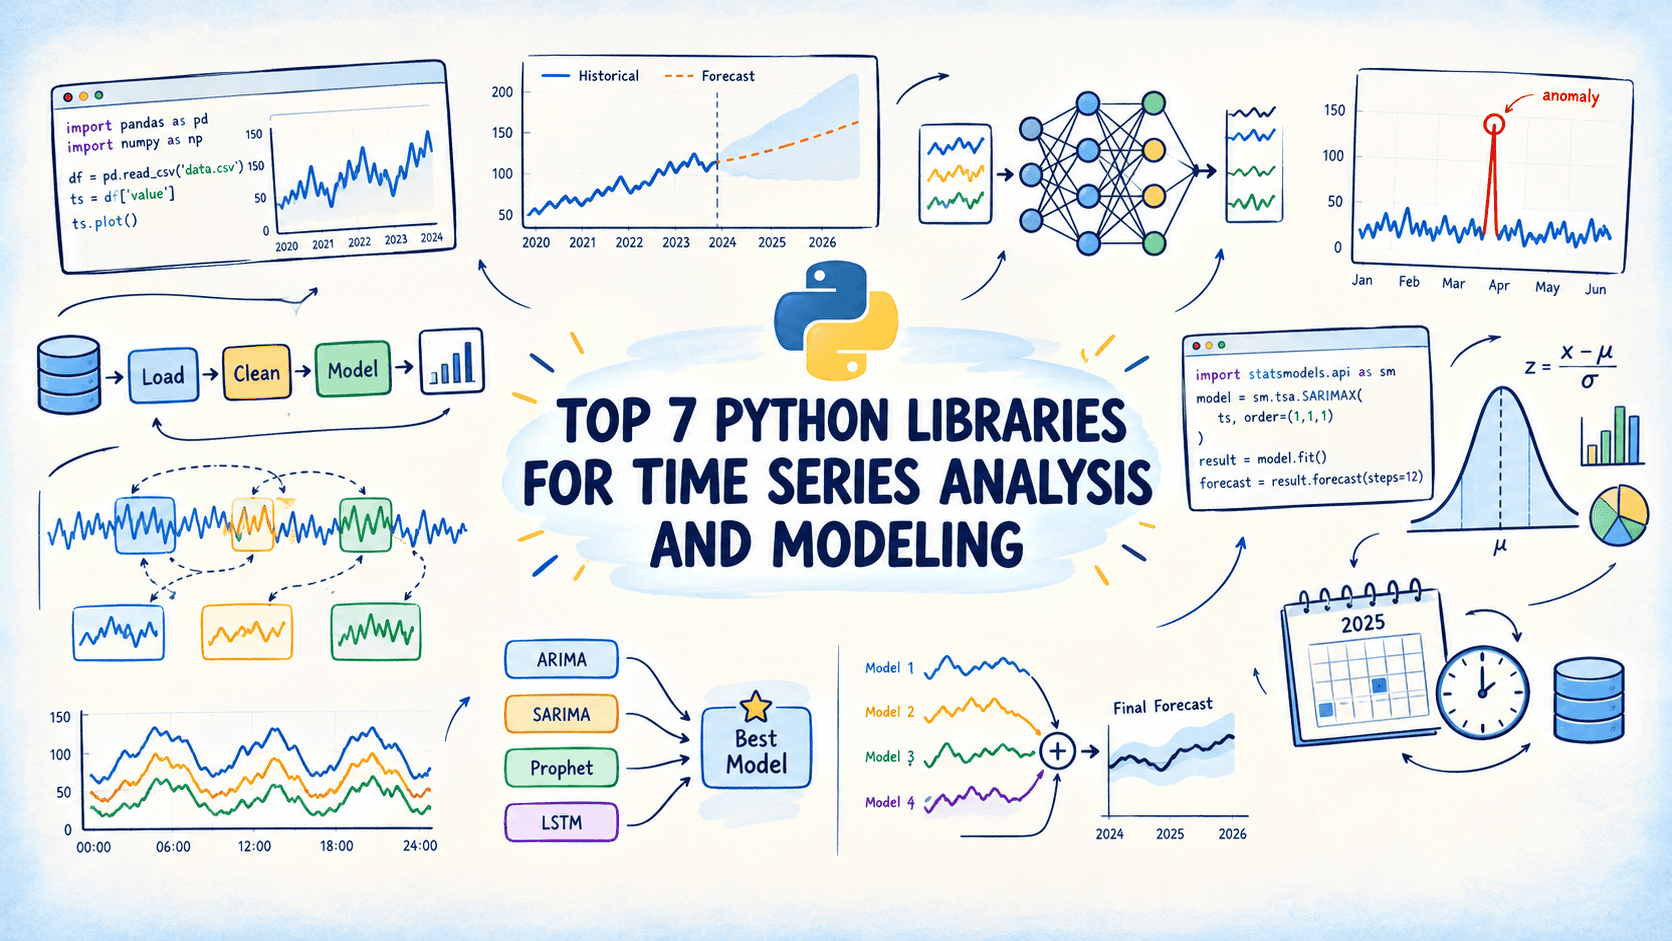
文章介绍了七个Python时间序列库:statsmodels用于可解释的ARIMA等统计建模;pmdarima自动搜索ARIMA阶数;sktime提供统一的机器学习接口与防泄漏交叉验证;Darts支持概率预测、多序列全局模型及异常检测;stumpy通过矩阵轮廓发现模式和异常;PyOD汇集60多种异常检测算法;NeuralForecast提供30多种深度学习预测架构。建议在同一数据集上对比使用这些库。
本文介绍MongoDB副本集内存不足时,除分片外的替代方案的概念验证。
该文标题为“WordPress表设计分析”,但正文仅包含作者、发布时间、阅读评论数及转载授权说明,未提供任何实质性表设计分析内容。
本文介绍基于Amazon Nova与S3 Vectors构建的无人机炸机分析系统。针对分钟级视频中仅2至3秒关键瞬间难以定位的问题,采用“先定位、再理解”的两段式多模态RAG:用Nova MME做跨模态语义检索,用OpenCV关键帧补充运动异常候选,双路合并后交由Nova 2 Lite精读并生成报告,再经MCP网关与Quick Suite编排输出。方案强调重检索、轻生成,并指出反馈闭环与工程化能力是后续改进重点。
开发者通过AI分析发现,百度网盘iOS版在用户禁用运动与健身权限后仍能触发摇一摇广告,原因是其广告框架包含NoShake变体,转而使用Core Location的CLHeading磁力计数据判断手机姿态变化。报告还指出存在零点击自动跳转问题:当特定参数满足时,等待约1秒后即使用户未点击也会自动执行广告点击。
本文介绍营销人员如何用Python处理营销数据:先讲变量、字符串、列表、字典、循环、函数等基础,再用pandas读取CSV和Excel、清洗数据、计算CTR、转化率、CPA、ROAS等指标,并用groupby汇总渠道与活动表现;随后涵盖可视化、RFM客户分群、漏斗与A/B测试、自动化报告与告警,以及机器学习预测流失;最后以构建营销智能系统为综合项目,强调数据质量、避免数据泄漏,并以业务问题为先。
Amazon Bedrock 推出 Request Metadata 功能,调用模型时可附加最多 16 个键值对元数据,不影响模型输出,但会记录到 CloudWatch 或 S3 日志,用于业务分析、日志过滤、追踪 ID 和成本分账。Converse 与 InvokeModel 系列 API 均已支持。文章介绍通过 CLI 和 SDK 添加元数据的方法,并演示如何用 CloudWatch Logs Insights 和 Athena 查询日志、按部门或项目统计 Token 消耗与估算成本,最后给出元数据命名统一、避免敏感信息等最佳实践。
Procore Analytics 2.0 采用 Databricks 与 OpenSharing 重构数据架构,取代受限于每日刷新和 API 瓶颈的旧版。新架构通过分层数据管道和 OpenSharing 向客户共享数百张治理良好的数据表,支持跨云、跨平台消费,并实现按用户和项目的权限控制。数据目录规模翻倍、构建时间减半,刷新频率不再受限,新产品数据可更快交付客户。
LakeAgent结合DataArts Studio,支持业务人员用自然语言发起订单分析:先检索相关资产与字段,再生成SQL对比两日历史样例,发现记录由59行增至66行,其中NOT SPECIFIED增5行、URGENT减2行;血缘追溯未查到来源,需补充资料。之后可延伸追问、自动生成含查询依据与见解的报告,并沉淀企业规则和定时任务,减少重复分析。
SCA应嵌入现有代码托管与流水线,而非单独采购扫描器。其核心产出是可核对的SBOM组件清单,字段完整才能匹配漏洞库。选型需关注六项:漏洞情报、可达性分析、SBOM格式、许可证合规、开发者体验与CI/CD集成。合规要求正使其从建议变为必须留痕。Gitee将SCA集成于研发平台,适合已统一代码托管的团队,私有化版本可满足代码不出内网的需求。
Databricks提出统一能源交易平台方案:通过Spark结构化流将市场数据毫秒级实时写入Lakebase运营数据库,支撑实时交易应用展示价格、持仓、盈亏与风险,并在接近限额时即时预警;同一份受Unity Catalog治理的数据同时用于机器学习训练与部署、历史分析与自然语言查询,避免运营与分析双系统导致的数据不同步、治理重复和模型交接复杂等问题。
系统由关联个体按规则协作产生新能力,子系统是更大系统的一部分;模块按逻辑拆分以分离职责,组件按物理拆分以复用;框架关注规范,架构是软件系统的顶层结构,明确个体及运作规则。
文章主张将实时分析作为湖仓一体的原生能力,直接在受治理数据上实现毫秒级查询与高并发,避免为ClickHouse、Druid、Pinot等专用引擎复制数据、维护额外管道和分散治理。评估实时需求应看数据新鲜度、查询延迟和并发量。Databricks的Lakehouse//RT由Reyden引擎驱动,无需独立服务层,支持每秒高达1.2万次查询,并统一治理。
Databricks首次入选2026年Gartner分析与商业智能平台魔力象限,即获"远见者"称号,创下该报告20多年来新厂商最高首秀成绩。文章认为传统BI已过时,未来属于将分析与AI融合的数据平台。Databricks通过湖仓一体、Genie及AI/BI,让智能体基于完整受治理数据自主行动,推动BI从静态仪表盘转向动态主动洞察。
完成下面两步后,将自动完成登录并继续当前操作。