文章探讨NoSQL时代数据库分类的困境:NoSQL已从键值、列族、文档、图四类扩展至向量、时序、空间、面向对象等八类,仍难穷尽(如ZooKeeper);按CAP原则分类不准确,因许多新型数据库的AP/CP属性取决于用法;OLTP/OLAP分类也难以覆盖NoSQL。作者最终放弃树形归类,认为NoSQL时代呈扁平化百家争鸣特点,并总结了按数据模型、部署方式、处理方式和存储方式的常见分类及适用场景。
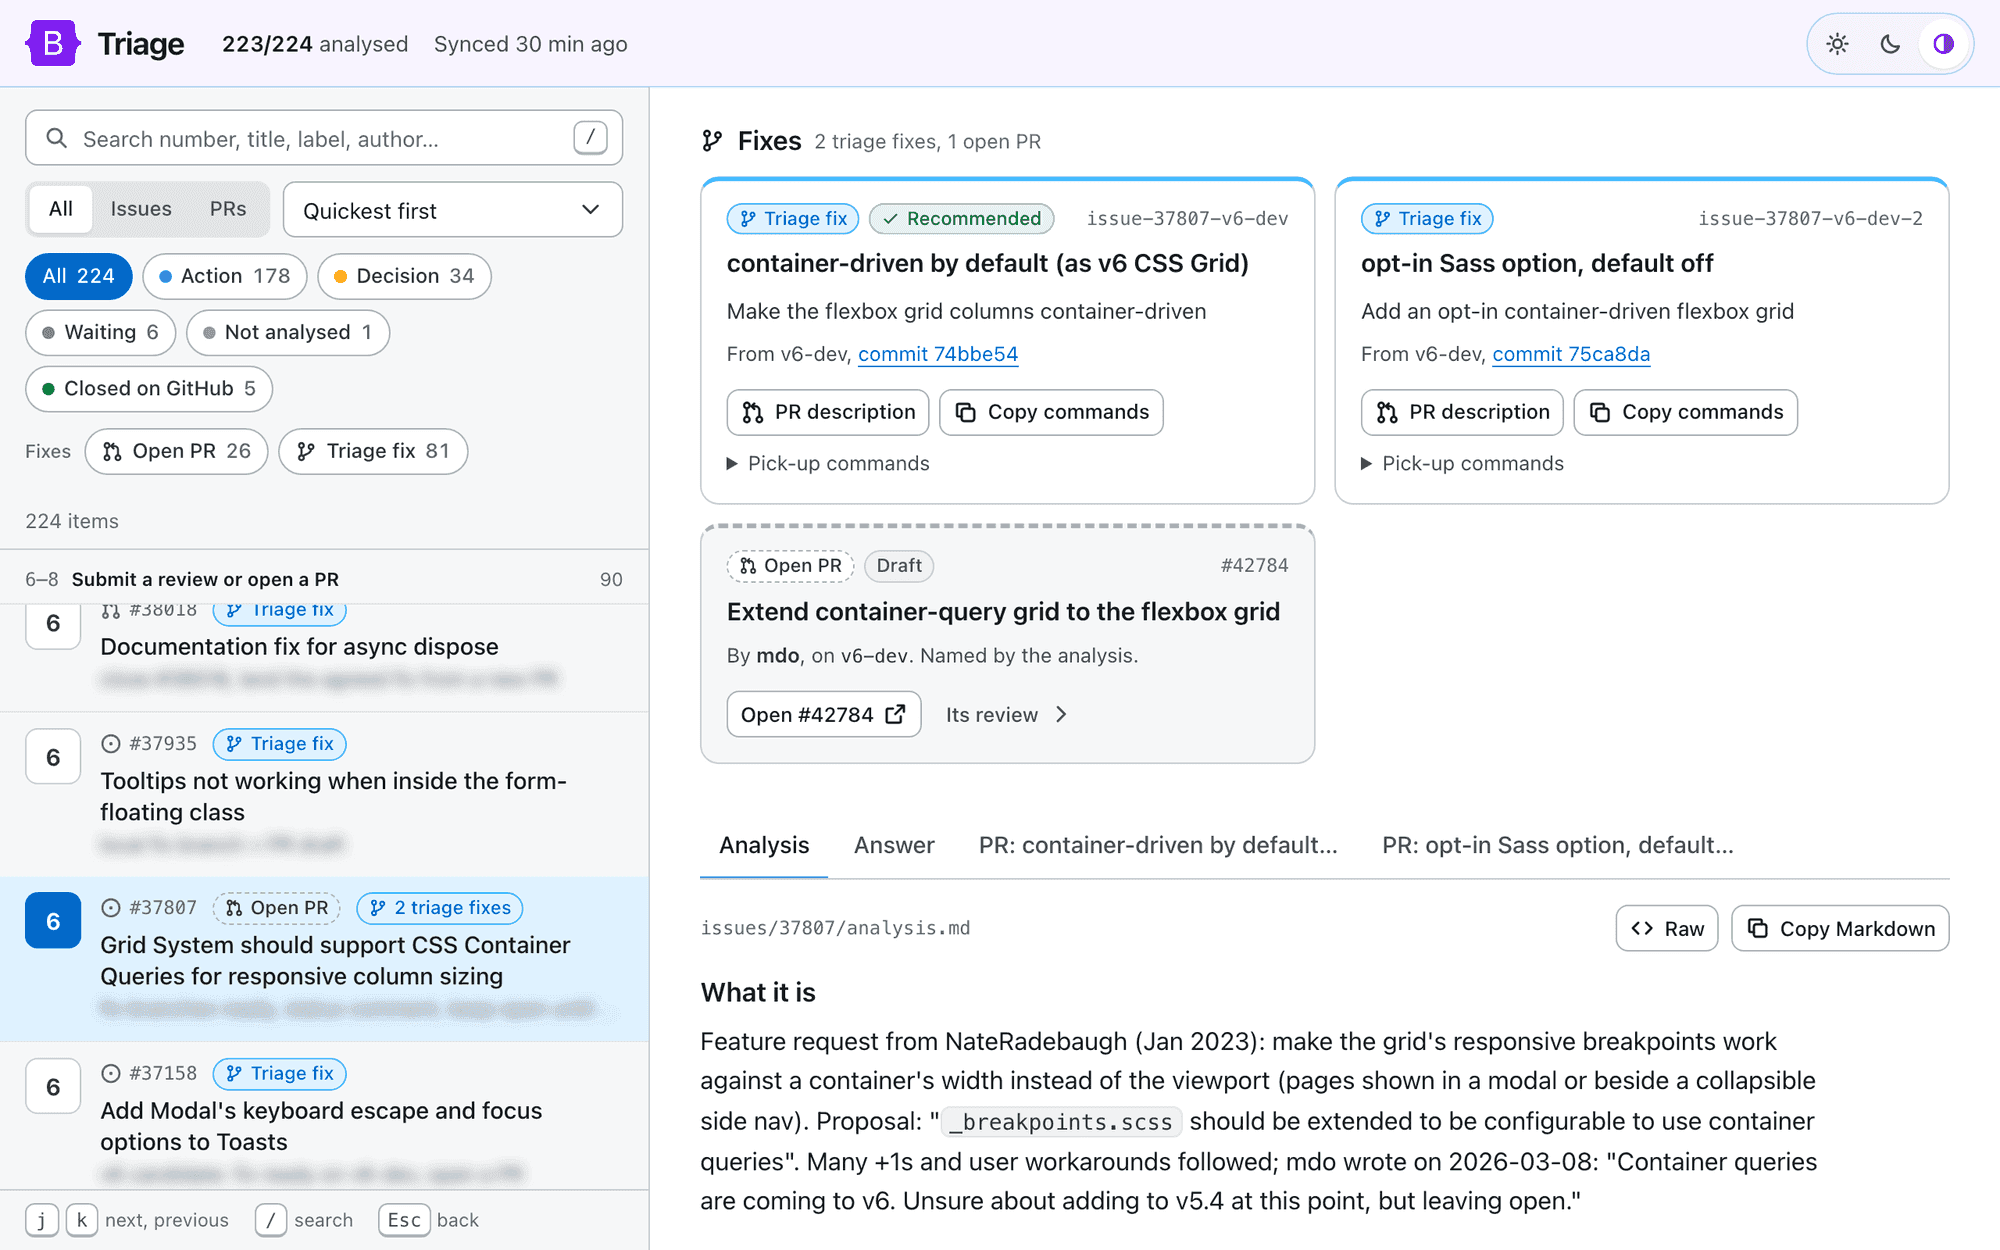
Bootstrap 维护者利用 LLM 代理构建内部工具 twbs/triage,自动分析开放 issue 和 PR,生成分析、回复草稿和修复分支,最终由维护者决策。首轮处理 200 多项,发现已修复问题、待合并 PR 等,并统一标签。代理将贡献者内容视为数据而非指令,不运行其代码,仅作起点,不替代贡献者。
Scikit-LLM 是一个 Python 库,将预训练大语言模型封装为 scikit-learn 风格的 fit() 和 predict() 接口,无需重新训练模型。文章以 IT 支持工单分类为例,演示少样本分类:仅需 3 至 5 个带标签示例即可引导模型准确分类新文本,效果优于零样本分类,尤其适合领域特定任务。
2026年推理算力将占AI负载超70%。国内AI算力平台分三类:大模型API平台(火山方舟、阿里百炼、模力方舟、硅基流动)适合应用开发;GPU租用平台(AutoDL、智星云、阿里云PAI)适合训练微调;一体化云厂商(华为云、七牛云)适合国产化与全链路需求。选型应先定场景,再比价格,后验生态。
Jev模型在OpenRouter分类请求中占27%份额,超过DeepSeek V4 Flash。它不生成文本,仅返回结构化判断,延迟低且成本为对手六分之一。创始人Diogo Almeida针对RLHF模式坍缩问题,用RLCD训练出概率校准的决策模型。但开源小模型可蒸馏其能力,纽约大学测试显示其在14/18个任务上落后于大模型。
Jerry Liu 开源 DocJev,将 PDF 分类与拆分分为两步:先用本地 LiteParse 免费 OCR 提取文字,再由 TypeSafe Jev 引擎按 YAML 规则决策。15 页公文包 138 毫秒完成分类,比 GPT-5.6 Luna 快约 6 倍且成本更低。40 份公文分类全部正确,8 个公文包拆分正确 7 个。支持导出独立 PDF,需 Python 3.11 及 API 密钥。
Jev Engineering 提出将 Agent 中“做选择”的决策从大模型剥离,交由专门的 Jev 分类模型处理,大模型仅负责推理与生成。Jev 支持 Choice、Score、Noul 三种输出,用于路由、排序和门控,并通过漏斗筛选、批量决策、置信度阈值和上下文打分压缩来降本增效。实测成本约 42 美分对 44 美元,相差百倍,但准确率仍有差距,需按场景验证。
knitr 作者集中清理了积压十余年的 GitHub 问题,修复并合并大量议题。主要改进包括:Quarto 下 current_input() 正确返回 .qmd;purl() 支持 YAML 参数;verbatim 块忽略全局 echo=FALSE;ffmpeg 失败时报错;read_chunk() 改用语法树检测;多设备绘图与 dpi 处理更准确;代码块引用可内联使用。作者还谈及赞助现状并感谢支持者。
Jev与Laya代表两类决策模型:Jev为闭源API,支持类型化输出与64K上下文,端到端延迟236毫秒起,无需微调;Laya为开源底座,单卡前向仅32.8毫秒,但零样本准确率仅0.362,需微调且窗口仅512 token。二者定位不同,选择取决于标注成本与API成本。核心启示是决策层与生成层应分离。
开源项目 jeff 使用 4 亿参数 GLiFormer 模型在本地 GPU 进行文本分类,完整复刻 TypeSafe 的 jev API 协议,仅需修改 TYPESAFE_BASE_URL 环境变量即可零代码迁移,成本从每百万次 15.6 美元降至 2.6 美元。简单情感和情绪分类准确率几乎追平 jev,但 AG News 主题分类和反讽检测落后约 15 个百分点。推荐使用 Modal 平台的 L4 GPU 部署,每秒约处理 50 次请求。
2026年9月,前OpenAI研究员阿尔梅达发布决策模型Jev。在1565封商务邮件分类测试中,Jev准确率为96.4%,略低于Gemini的98.5%,但响应仅需70至500毫秒,成本极低。Jev采用并行采样与校准置信度,输出结构化判断,适合生产环境。文章指出,错误分布和可预测性比整体准确率更重要,Jev在速度、成本与工程可控性上占优。
大模型直接分类时,硬标签的Brier分数(0.259)不如抛硬币(0.25),因其本质是语言生成而非概率估计。将其输出作为特征输入逻辑回归,分数降至0.175;再加入19个维度特征和9个规则特征,最终降至0.127,F1达0.779,媲美竞赛最优模型。这表明大模型分类实为特征工程,可将调提示词转化为可调试的工程流程。
2026年9月,专用分类API jev以极低成本在分类任务上追平GPT-5.6-terra,成本相差百倍。编程智能体降低了服务切换门槛,却暴露出企业评估体系的缺失,促使其建设评测流水线。前沿实验室则通过后训练降低通用模型成本。最终胜负取决于未来成本曲线的斜率,但目前尚无真实场景的对比数据。
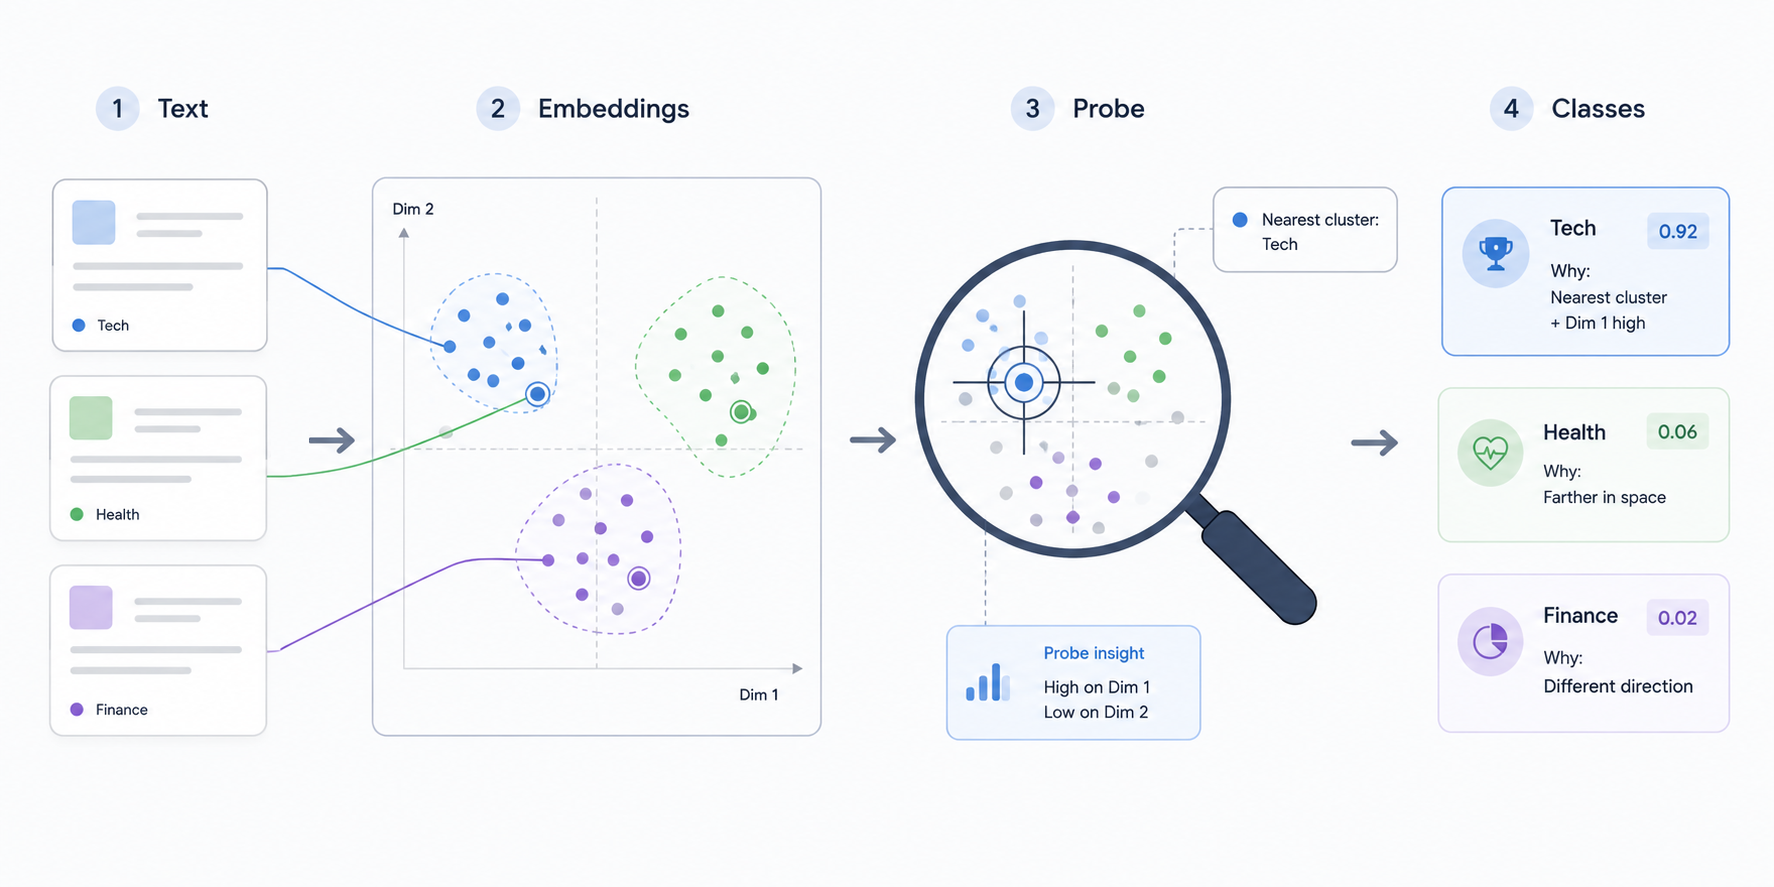
本文介绍如何利用Scikit-LLM和本地Ollama模型生成电影评论嵌入,训练逻辑回归分类器评估质量,并通过UMAP降维可视化语义结构,最后使用SHAP值识别关键嵌入维度,以提升LLM文本分类的可解释性。
本文介绍SSVC(利益相关者特定漏洞分类)作为CVSS的替代方案,通过决策树而非单一评分来指导漏洞处理。作者发布了Perl实现SSVC.pm,支持CISA等六种方法论,并演示了结合NVD数据计算CVE-2021-44228(Log4Shell)的实例,强调SSVC需结合环境因素做出针对性决策。
本文研究了将分类流映射(CFM)方法扩展到大规模语言建模。作者训练了17亿参数的流模型,通过自蒸馏实现仅需4步推理即可生成高质量文本,并保持接近数据级的熵。他们还提出了半离散设置下的似然界,用于标准语言模型基准评分,结果与离散扩散方法相当。文章还探讨了大规模训练中的挑战,并提供了损失加权和时间调度的实用建议。
Elastic 9.5正式发布,新增列式存储模式、向量数据库索引模式及自动校准,提升存储与查询效率。安全方面推出AI驱动的攻击发现与告警分类,助力实现“告警清零”。可观测性支持原生Prometheus与PromQL,简化迁移。Agent Builder增强监控与人工审批,Kibana支持AI生成仪表盘,整体提升数据管理、AI代理构建及安全运营能力。
Elastic 9.5正式发布,推出列式存储模式、VectorDB索引模式与自动校准,提升存储效率与向量搜索性能。新增Agent Builder增强、AI原生Kibana、原生Prometheus支持及安全功能Alert Zero,强化可观测性与安全运营,助力开发者构建AI智能体并简化数据管理。
《奥德赛》是全球首部全程用65mm IMAX胶片拍摄的电影,导演诺兰推荐1.43:1画幅的70mm胶片版。文章详解IMAX影厅分类:GT胶片厅最顶级,Laser GT可放1.43:1数码版,激光厅分CoLa和XT,Xenon最差。国内最高只能看1.43:1数码版,选厅需注意银幕比例和放映系统。
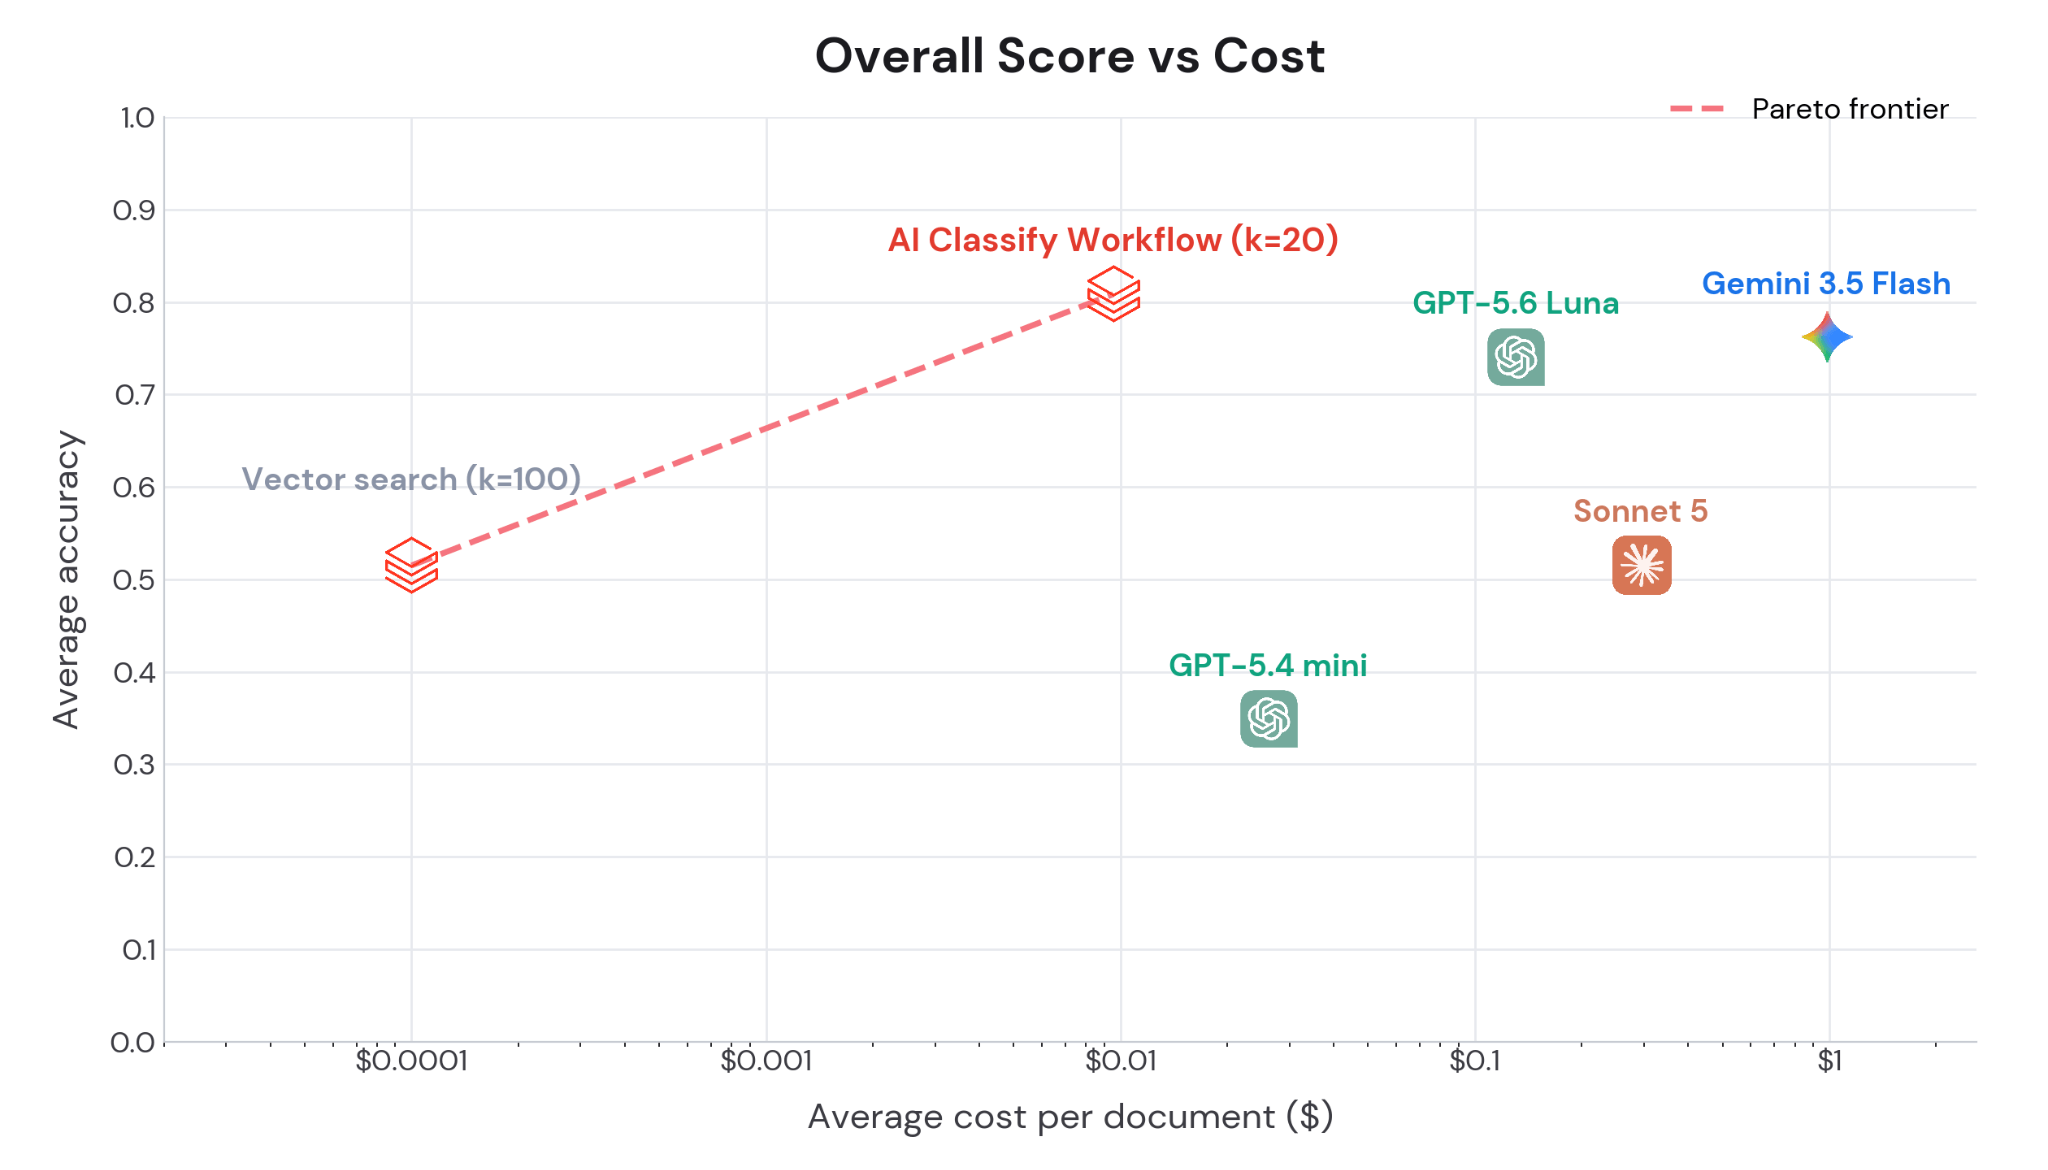
Databricks 测试了三种大规模文本分类方法:纯向量搜索、向量搜索结合AI Classify、直接调用前沿大模型。结果显示,向量搜索加AI Classify的工作流在35,000至100,000标签的基准测试中,准确率达0.81,比最强直接模型高5个百分点,成本仅为后者的百分之一,且无需重新训练,是成本与质量的最佳平衡。
完成下面两步后,将自动完成登录并继续当前操作。