Anthropic加强Claude推理数据保护以打击模型蒸馏,新措施使推理数据提取量下降90%~99%。措施包括保留思考功能、禁止编辑先前对话上下文、限制跨模型读取推理记录,并用分类器识别套取请求,已封禁数万账户。但保留思考机制需开发者调整集成,分类器可能误拦正常请求,误报率低于0.1%,被拦请求仍计费。
文章介绍了决策模型Jev在分类任务中的实验,测试了重排序、减少重复结果、查询理解和语义分块。重排序中Jev优于交叉编码器,但迭代法收益有限;结合MMR可兼顾相关性与多样性;查询理解需谨慎过滤,短查询易误判;语义分块在QASPER上IoU提升13%。建议RAG优先用其分块,产品搜索结合MMR,查询理解潜力大但需更多验证。
Jev是TypeSafe AI推出的模型,输入文本和问题即返回概率数字,具备零样本泛化与校准保证。Jimothy将Jev的判断蒸馏为本地小分类器,用Jev标注的数据训练,实现毫秒级推理、离线运行且无需API费用。风险在于教师偏差可能被学生放大、训练数据可能含噪声标签、概率校准未必可靠。因此它适合任务固定、错误成本低的粗分类,不适合风控、医疗等高风险场景。
开发者基于Jev模型构建了语音助手Toothless,利用本地轻量分类器实时判断每句话是否对机器说,无需唤醒词。Jev比同类模型快20至200倍,本地运行可降低成本并保护隐私,仅在判定对AI说话时才调用大模型。但语音转文字、说话人分离和停顿检测仍是难点,且需优先避免假阳性。
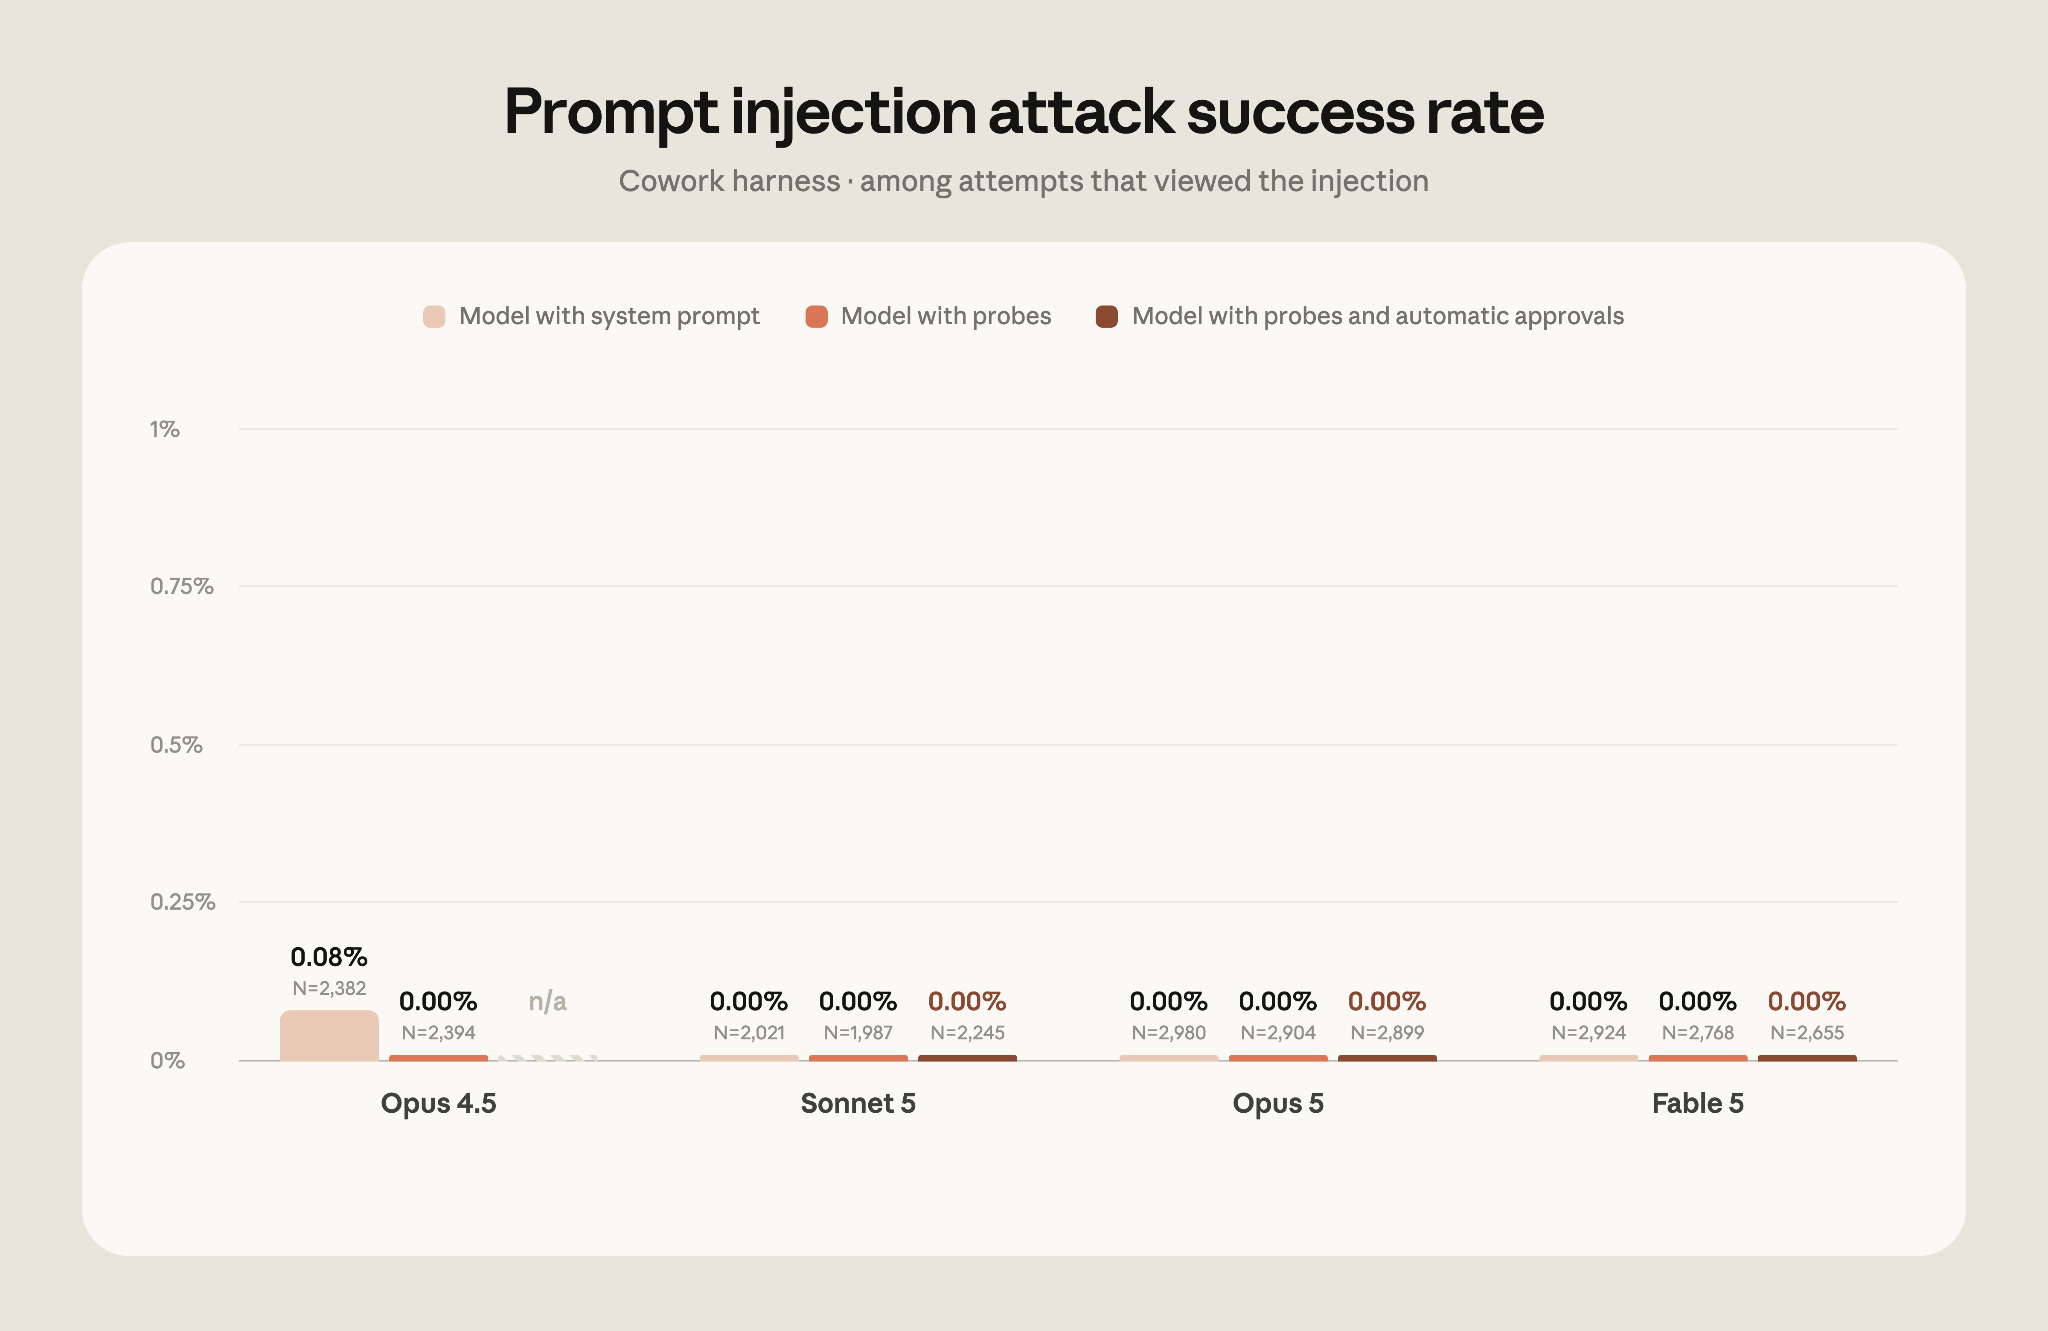
Anthropic宣布Claude in Chrome正式上线,支持所有付费计划,可自主执行浏览器操作。为防提示注入攻击,系统采用分类器验证每个动作,并训练模型识别攻击。测试显示,最新模型在防护下攻击成功率极低,仅Fable 5有0.3%低风险成功案例。用户可从Chrome商店安装,企业版可管理设置。
LinkedIn推出“疑似AI生成”按钮后,已有超百万人使用。此举旨在应对平台上大量AI生成内容,并配合新分类器减少此类内容曝光。平台还新增提示,告知用户其帖子被标记为疑似AI,以提供反馈并鼓励减少AI使用。
Claude Code将于8月14日起在Pro、Max和Team计划中默认启用自动模式,通过分类器拦截危险操作,减少用户确认提示。测试显示其安全性优于人工审查,能阻止89%危险命令,并有效防范提示注入攻击。企业版和API用户暂可选用,未来将全面推广。
Anthropic宣布Claude Code五天后默认启用自动模式,因人工审批权限请求仅3%被拒,且会话越长人类表现越差。自动模式分类器拦截率更高,经测试能拦住89%危险命令,而人类仅13.6%。分类器经对抗加固后漏检率从12%降至7%,并新增数据外泄硬性拒绝等能力。用户可通过Shift+Tab切换模式,管理员可设置组织级默认。
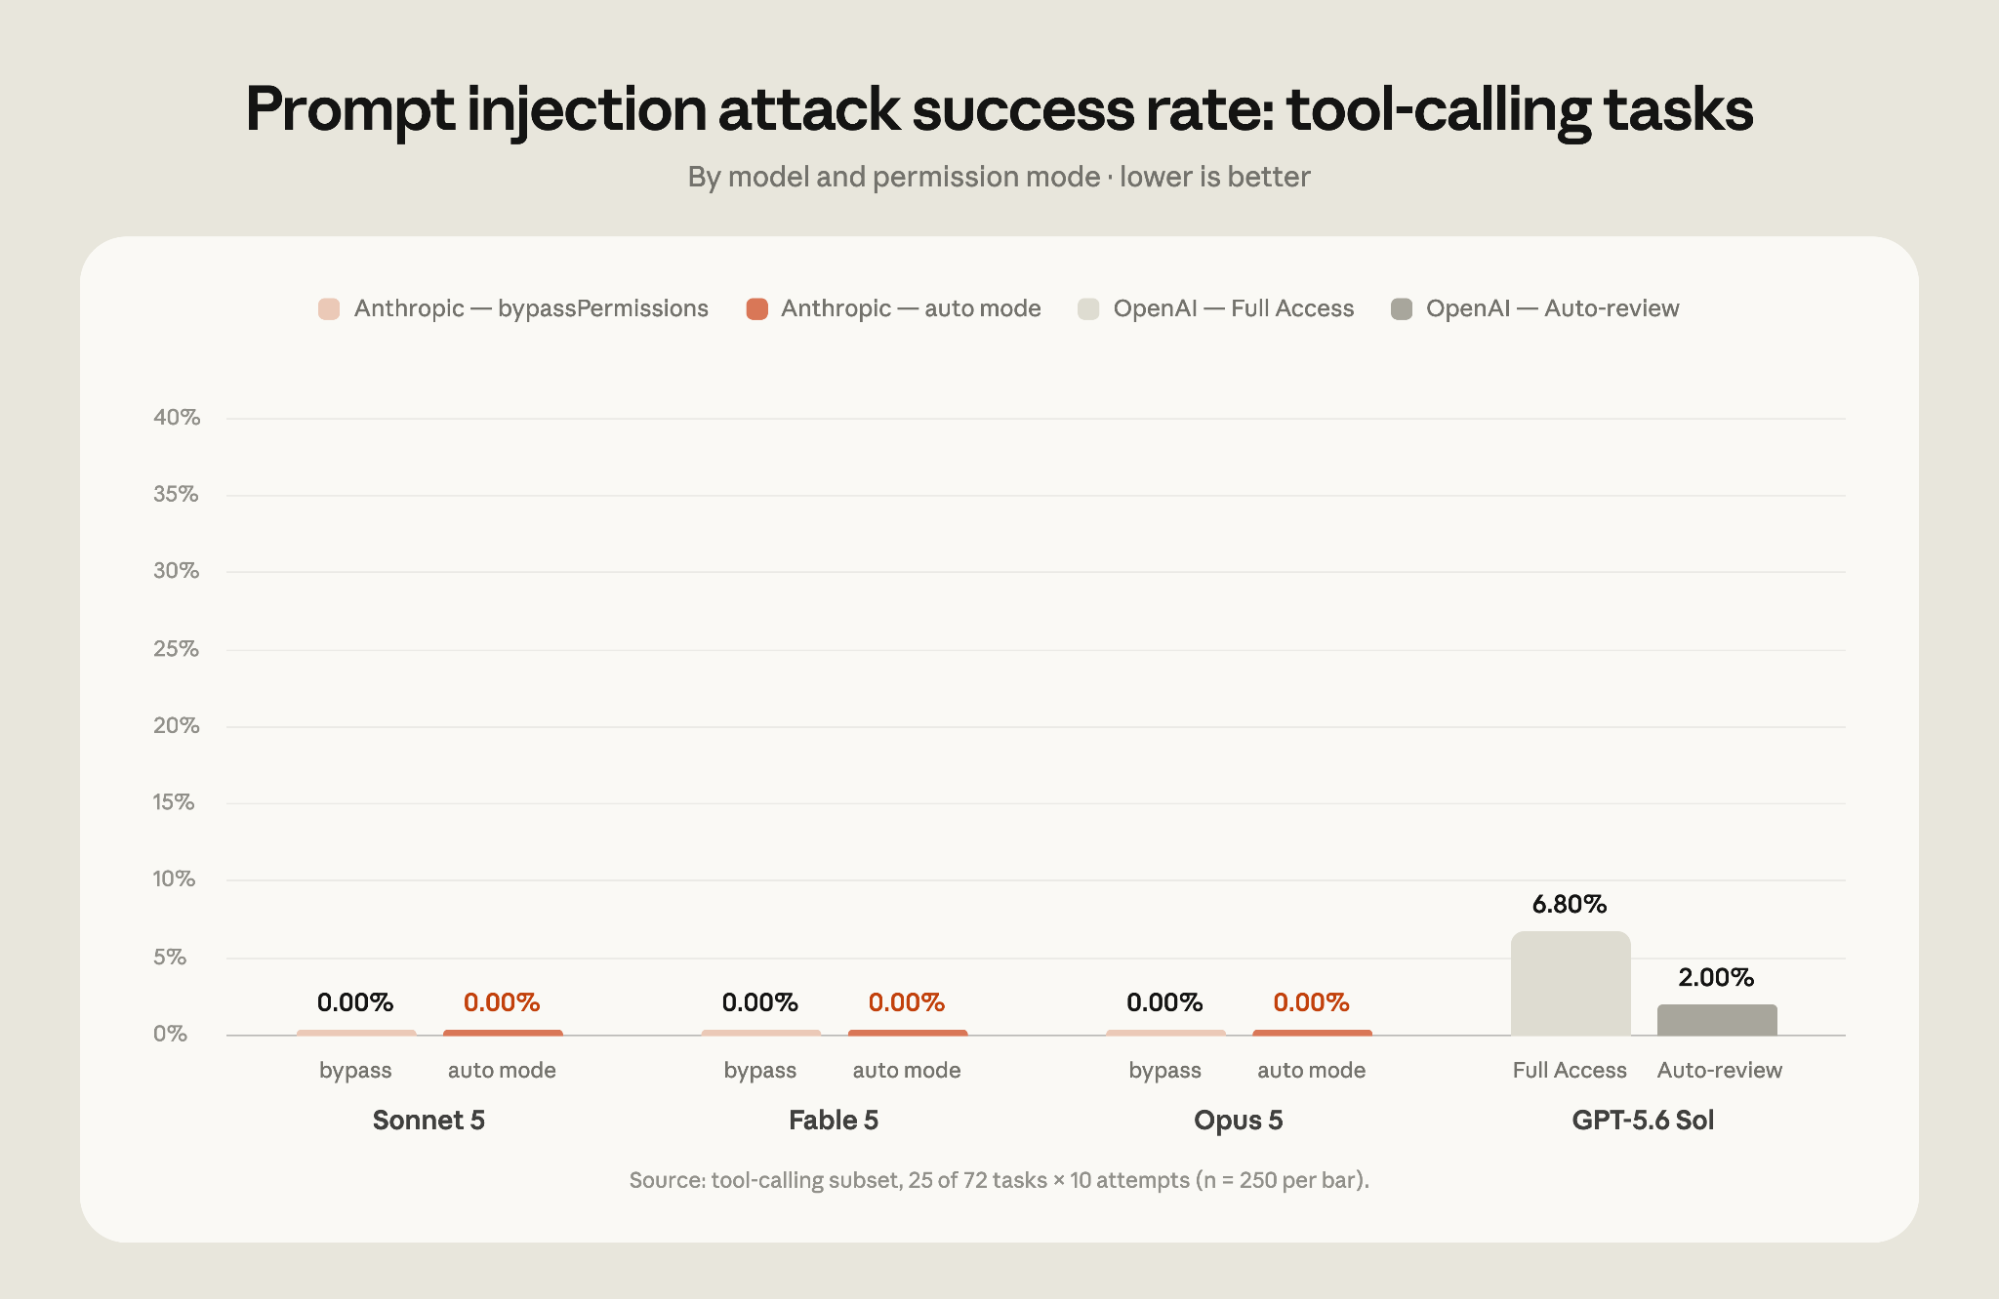
Anthropic宣布Claude Code的自动模式将于8月14日成为Pro、Max和Team用户的默认设置。该模式利用分类器模型识别危险操作,减少人工审批。研究显示,人类仅能发现13.6%的危险命令,而自动模式可捕捉89%。系统设有硬性拒绝规则,防止数据外泄,并增强提示注入防护。测试中,自动模式成功阻止所有攻击,优于OpenAI的GPT-5.6。此外,并行Claude Code会话现可互相通信,共享摘要以提高效率。
Claude Code推出自动模式作为默认设置,通过分类器评估命令并阻止潜在危险操作,平衡速度与安全。内部评估显示其比人工审批更有效,中断减少9倍。Nuro、Gusto和Garner Health等公司采用后,实现长时间自主运行、减少权限负担,同时通过定制控制保护敏感操作,提升开发效率。
LinkedIn新增“疑似AI生成”举报按钮,用户可标记非人工撰写的帖子。此举旨在减少平台上的AI垃圾内容,因检测发现41%的长文疑似AI生成。平台还将用分类器降低低质量内容展示,并测试提示用户帖子不真实,同时移除AI“增强”功能,改为仅校对不改变文风。
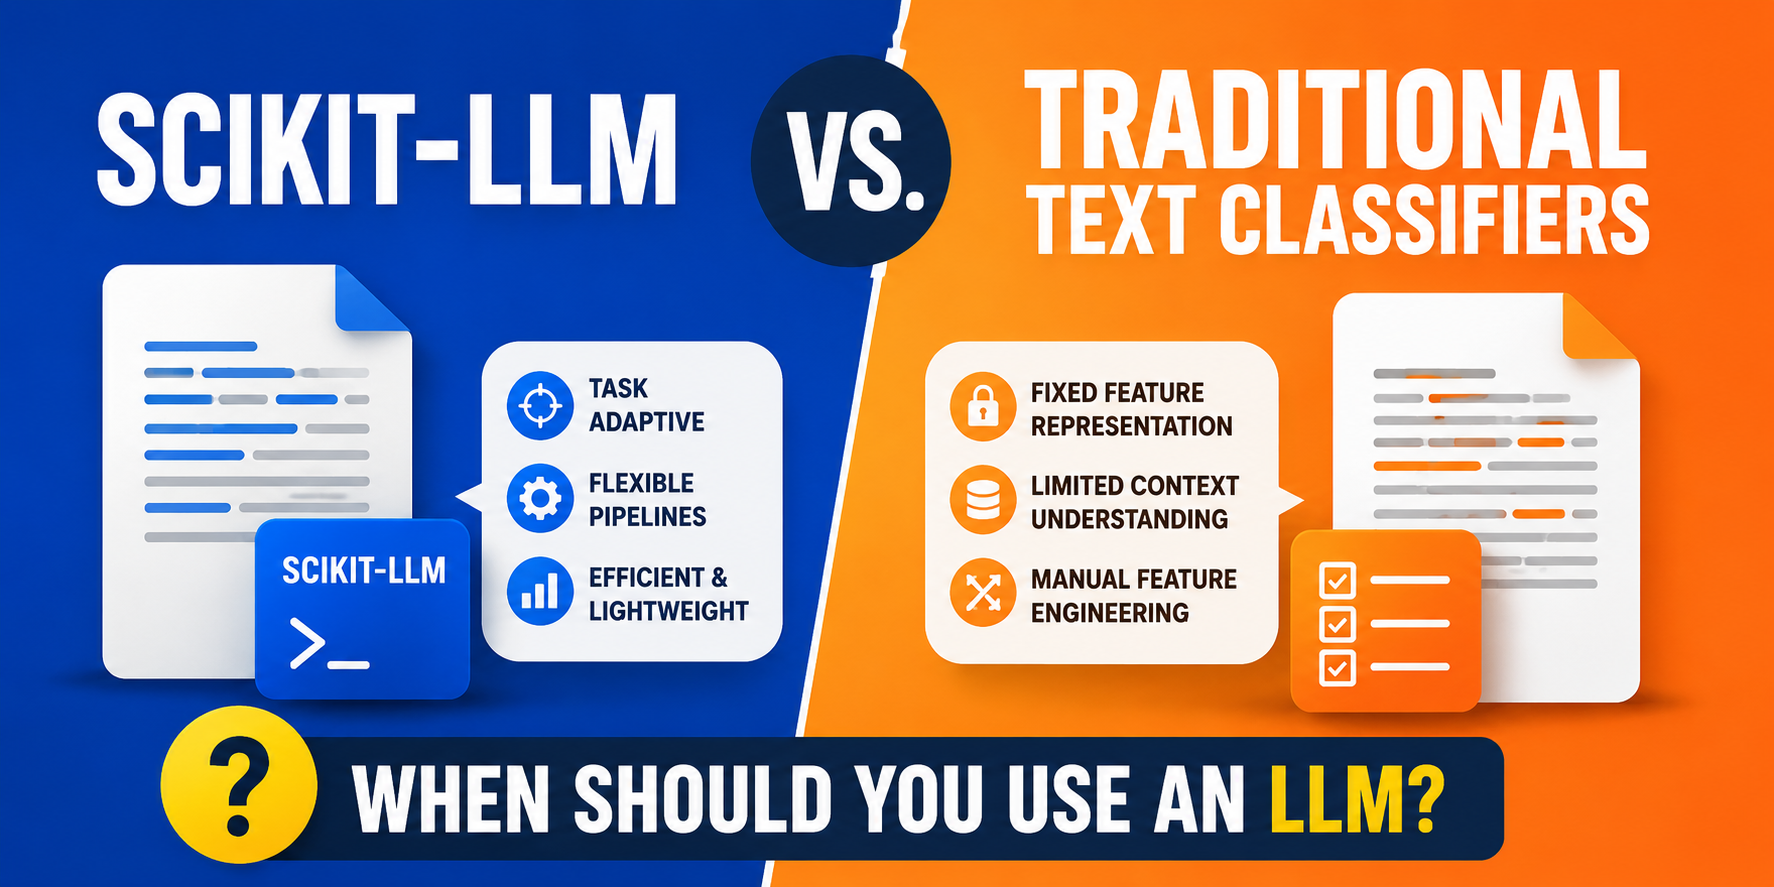
本文比较了三种文本分类方法:传统的TF-IDF与逻辑回归、基于BART的零-shot分类和使用scikit-LLM的零-shot分类。研究表明,scikit-LLM在分类准确性(0.86-0.87)和速度上优于其他方法,适合处理数据量小且需要深度语言理解的任务。
在数字时代,垃圾邮件成为安全威胁。开发者利用机器学习构建智能过滤器,本文介绍了一个无服务器垃圾邮件分类器项目,结合Scikit-learn和AWS服务,实现实时消息分类。该系统模块化且成本效益高,支持独立更新模型,展示了机器学习实验与实际应用之间的桥梁。
Claude Code的YOLO分类器通过双阶段审核确保安全。第一阶段进行快速检查,若发现可疑内容则转入第二阶段进行深入分析。系统设计强调不信任自身输出,确保操作安全,用户可定义规则以增强灵活性。
本文详细解析了Softmax损失的数学推导,重点在于线性分类器的梯度计算。通过前向传播和反向传播,推导出损失对logits、权重和偏置的梯度,并利用链式法则简化矩阵运算,帮助理解分类网络如何从错误中学习。
本文介绍如何从零开始使用朴素贝叶斯算法构建垃圾邮件分类器,包括数据预处理、特征提取和模型训练,最终实现超过97%的准确率。适合初学者,强调文本清理和模型性能评估的重要性。
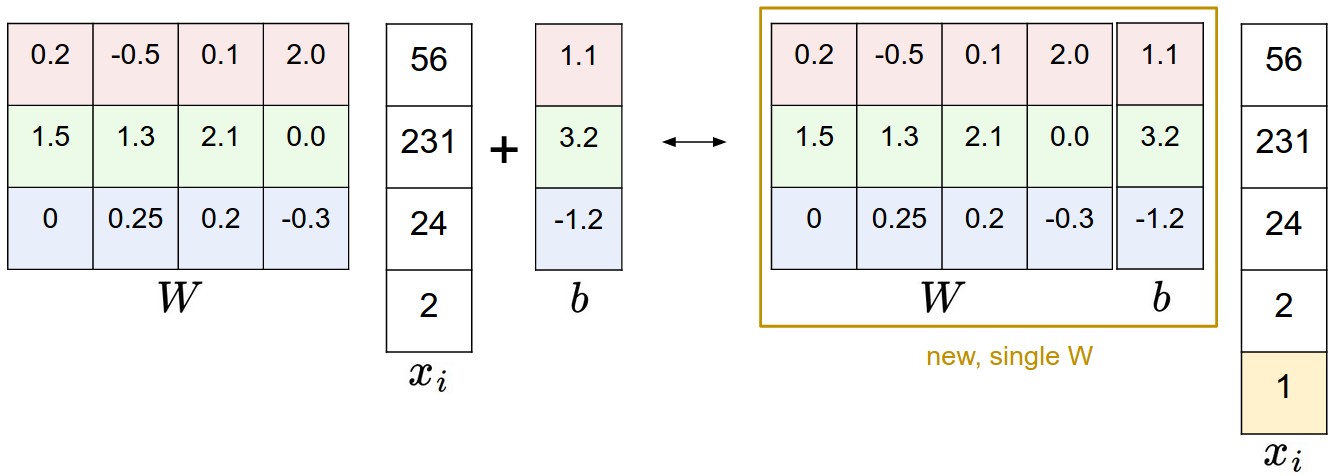
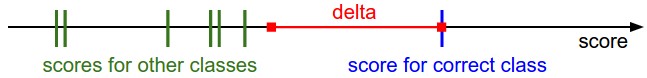
KNN算法存在缺陷,需要更强大的方法。新方法使用评分函数将图像像素映射为类别分数,并通过损失函数量化预测分数与真实标签的差异。我们采用多类支持向量机(SVM)损失,结合正则化,优化模型以提高泛化能力。Softmax分类器将分数视为未归一化的对数概率,并使用交叉熵损失进行优化。
KNN算法存在不足,需要更强的替代方法。新方法引入评分函数和损失函数,评分函数将图像像素映射为类别分数,损失函数则量化预测分数与真实标签的差异。通过正则化优化权重,以提升分类器的泛化能力,防止过拟合。
对葡萄牙学生表现数据进行四种分类器的超参数调优实验表明,调优未显著提升模型性能,反而略有下降。这表明默认设置在许多情况下已足够有效,强调了在机器学习中了解何时停止调优的重要性。
在混合质量数据集上进行大规模模型预训练时,数据过滤至关重要。分类器质量过滤(CQF)通过训练二分类器来区分预训练数据和高质量数据,保留高分文档。研究表明,CQF能提升下游任务表现,但可能会隐含过滤高质量数据,未必改善语言建模。与合成数据相比,CQF的效果存在显著差异,挑战了其对数据质量有效性的看法。
完成下面两步后,将自动完成登录并继续当前操作。