

AWS公开了π0机器人的微调流程,称动作误差降低约89%。但早期评测因训练回合混入评测导致误差虚高至96%,修正数据切分后才可信。文章强调,关键在于训练与评测回合严格隔离,且89%仅为离线误差,不等于闭环任务成功率。
KD-tree是一种用于多维空间搜索的数据结构,能够有效解决最近邻查询和范围查询问题。其构建时间为O(n log n),查询时间为O(log n),但在高维情况下性能会迅速下降,出现“维度灾难”。本文分析了KD-tree的构建和查询算法及其局限性,并与Ball tree等其他结构进行了比较,指出KD-tree在低维场景下表现优异,适用于点云处理和游戏碰撞检测等应用。
HAMi v2.9.0 正式发布,增强了异构设备的虚拟化和调度能力。新特性包括用户态虚拟化、生产就绪的 HAMi-DRA、增强的安全性和稳定性,以及对瀚博半导体设备的支持。HAMi-core 模式实现了显存与算力的细粒度共享,提升了资源利用率,已在招商银行验证。此外,该版本还更新了可观测性和安全性功能,推动了 DRA 生态联盟的发展。
软件工程中的关注点分离原则一直是重要指导思想。传统MVC架构按技术层划分代码,导致添加新功能时频繁切换目录。而垂直切片架构按功能模块组织代码,降低了认知负担,提高了模块的独立性和内聚性,使项目更易于维护和扩展。
RAG应用通过将信息存为向量,与查询匹配后传给大语言模型。切分策略包括固定大小、语义、递归、文档结构和基于LLM的切分。固定大小简单但可能破坏语义,语义切分流畅但需设阈值,递归灵活但复杂,文档结构完整但长度不一,LLM切分准确但成本高。选择需考虑内容、模型能力和资源。
本文探讨了序列到序列神经翻译模型在多语种新闻监测中的故事分割和聚类问题。通过滑动窗口机制和字符级操作,提出了一种有效的多任务学习方法。研究表明,低维向量在故事聚类和分割中具有潜力,并介绍了多语言上下文嵌入的在线系统,取得了最新成果。
在类 Unix 系统中,可以使用 Shell 命令如 split(按字节或行切分)、csplit(按模式切分)和 cat(合并文件)来高效处理文件。
该文综述视觉定位与多模态大模型进展,提出融合语义名词与无类别分割的实体级方法,在叙事定位、指称分割和全景分割上优于现有方案;并介绍GLaMM、LLM-Grounder、BuboGPT、TGDoc、LLM4VG、LEGO、SDG、GroundVLP等模型,覆盖图像、视频、3D与文档场景,显示零样本与多模态定位能力持续提升。
本文综述了解决未登录词(OOV)问题的多种方法,包括基于表面形式与上下文的词表示、上下文化词嵌入特征分析、神经机器翻译中的词向量改进、少样本回归分层注意力网络、结合BERT的神经主题模型、语音识别持续学习、声学增强语言模型后处理、数据扩增槽填充模型以及子词级词向量生成模型。多项实验表明这些方法优于现有技术。
该研究提出了一种名为MS-NeRF的多空间神经辐射场方法,以更好地理解神经网络对具有反射和折射性物体的存在的情况,从而实现了对现有 NeRF 方法的增强。研究结果表明,该方法比现有的单空间 NeRF 方法在渲染复杂光路的镜像对象的高质量场景方面表现显著优于现有的单空间 NeRF 方法。
本文介绍了一种名为DiffSegmenter的无需训练的新方法,用于解决开放词汇语义分割挑战。通过利用扩散模型生成注释数据或提取特征,DiffSegmenter能够促进语义分割。实验证明DiffSegmenter在开放词汇语义分割方面取得了令人印象深刻的结果。
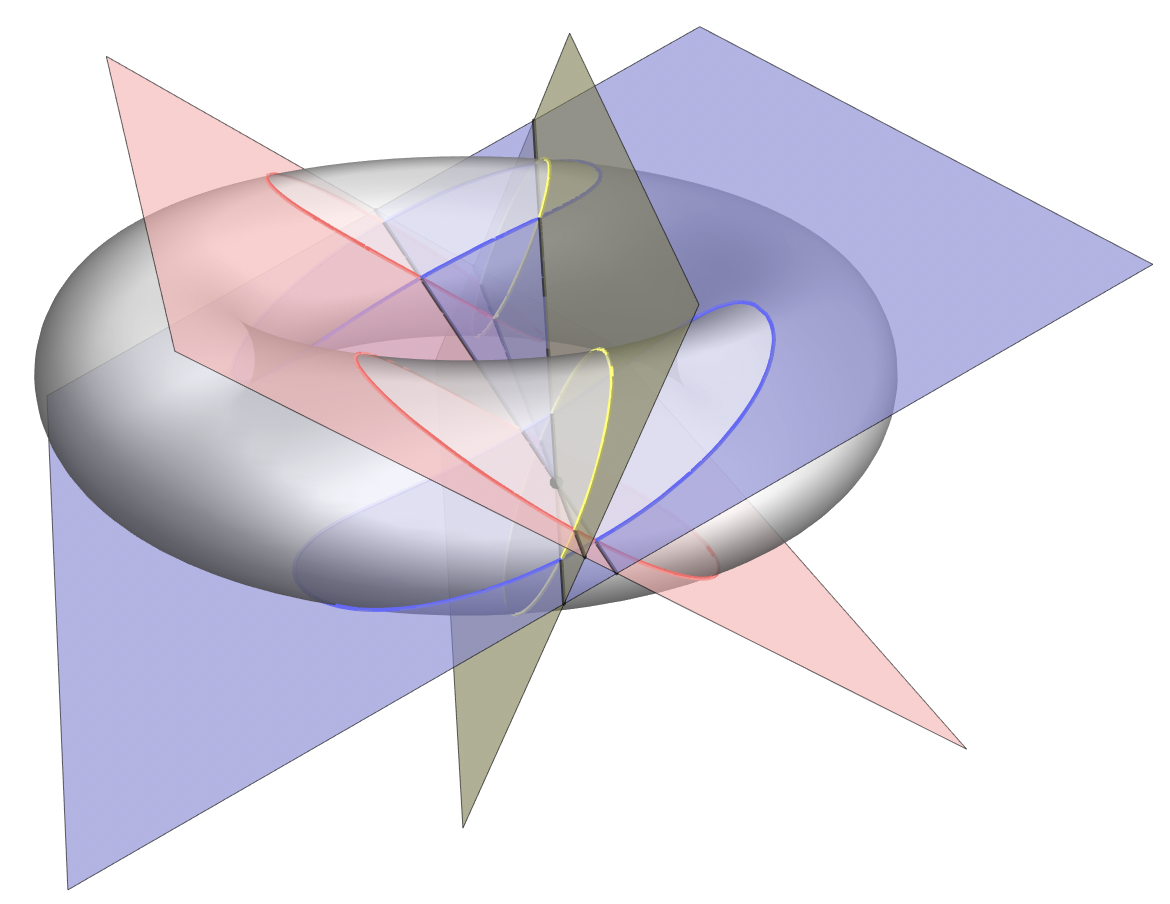
文章讨论了用刀切分不同形状(圆饼、方蛋糕、甜甜圈)时,最多能分成的区域数。3刀切圆饼最多7块,4刀切蛋糕最多15块,3刀切甜甜圈最多13块。切甜甜圈的区域数比切蛋糕少2块。
完成下面两步后,将自动完成登录并继续当前操作。