NVIDIA公布HSTU推荐部署流程,采用PyTorch AOTI编译、FlexKV缓存与Dynamo-Triton服务,八层模型满命中时延迟最高改善5.93倍,但收益取决于用户历史前缀复用率,50%命中时加速不足2倍。建议先验证输出一致性,再测试各命中率下的延迟、缓存失效与显存淘汰,并将推荐质量纳入验收,按每千次请求节省的GPU毫秒决策。
本文介绍vLLM推理优化:通过连续批处理让GPU持续忙碌,用PagedAttention分页管理KV缓存减少碎片,并利用前缀缓存跳过重复计算。还介绍GuideLLM测性能、lm_eval测质量,以权衡成本、准确率与性能。
本文总结Kimi K3模型结构对训练与推理系统的影响。KDA采用三种执行形态(FlashKDA、设备内上下文并行、状态回滚)处理固定大小状态;上下文并行通过可结合前缀扫描分解,避免直接加和;Block AttnRes优化内存通信;Stable LatentMoE融合GEMM与token中心解码;混合架构前缀缓存解耦粒度,支持512-token边界复用;视觉编码器动态并行并填充流水线气泡。核心是将固定权重累加转为数据相关选择。
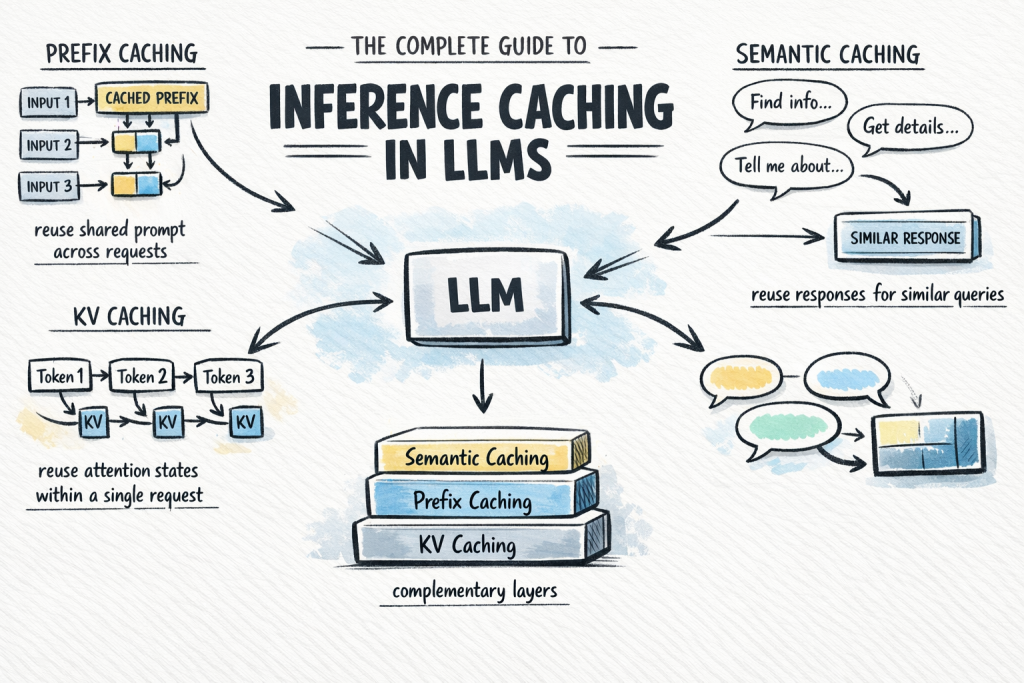
本文介绍了大语言模型中的推理缓存技术,强调其基本概念和重要性。推理缓存通过存储计算结果,减少重复计算,从而降低成本和延迟。主要有三种缓存类型:键值缓存(KV缓存)、前缀缓存和语义缓存。合理选择和组合这些缓存策略,可以显著提升生产系统的效率。
本文展示了如何通过前缀缓存优化大语言模型的文本生成,并比较了启用与未启用前缀缓存的生成结果,以验证文本生成的一致性和性能提升。
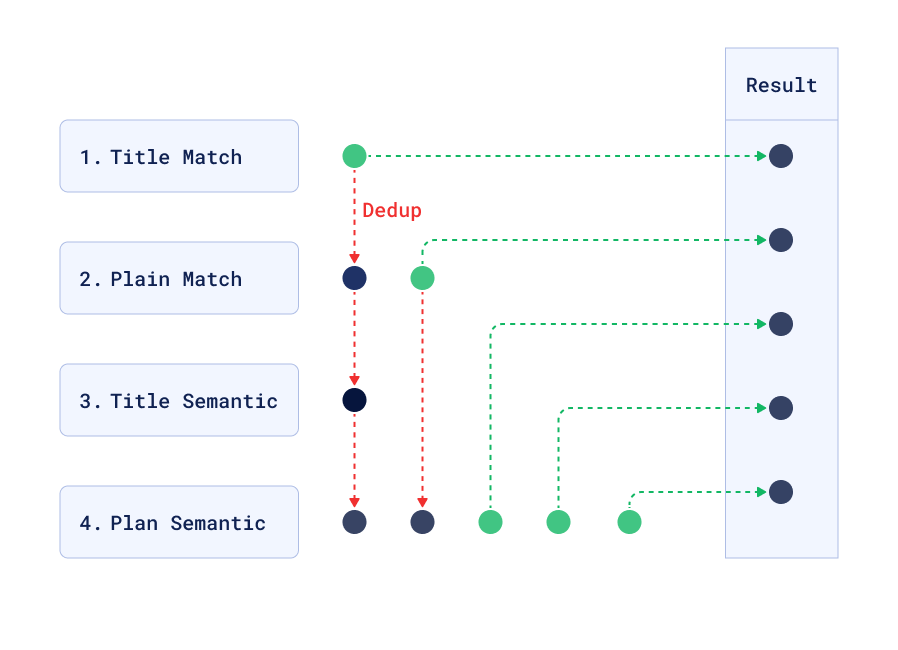
本教程介绍用 Qdrant 构建语义化“边输入边搜索”服务,包含三项优化:前缀缓存预计算短前缀向量,使短查询无需嵌入模型;批量查询按标题文本、正文文本、标题语义、任意语义排序;缓存与嵌入路径并发执行,缓存未命中也不增加往返。示例使用 Python、FastEmbed 和 MiniLM 模型,涵盖建集合、索引、缓存、查询与性能说明。
完成下面两步后,将自动完成登录并继续当前操作。