GigaBrain-0.7 是具身基础模型,采用三系统架构:系统1基于 VLM 主干与动作专家生成连续动作;系统2负责理解与长程任务规划;系统3用世界模型预测未来视觉状态并评估进展。模型在超 3.7 万小时、16 种机器人形态的轨迹及约 2.7 亿视觉语言样本上单阶段联合预训练,并通过软知识隔离保持视觉语言能力,实现理解、预测、行动与经验改进的统一。
高德发布首个基于开放世界行为的全身基座模型λ0,仅用人类行动数据即可让机器人学习移动、姿态与双手操作的全身协调。该模型采用无本体全身数据采集,效率约为主流方法的3.4倍,并构建了500小时的HumanVerse-500数据集。在仿真与真机评测中均达到SOTA,真机任务成功率较最强基线提升22.5%,支持零样本跨形态迁移,相关代码与数据已开源。
GigaWorld-Policy-0.5是一种以动作为中心的世界动作模型:训练时利用未来视觉动态提供密集监督,推理时仅解码动作、不生成未来视频,从而降低计算开销。它采用混合Transformer架构,将视觉动态建模与动作生成分配给不同专家模块,在RTX 4090上推理时延约85毫秒。预训练结合动作条件世界建模与WAM训练,并用AutoResearch流水线自动搜索训练配置。实验表明,该模型在保留未来视觉监督优势的同时显著提升了推理效率。
论坛SEO与博客不同,需通过主题集群积累权重。具体执行包括:内部链接按主题分桶并互链新老帖;用Topic Cluster搭建支柱页与簇页架构;完善结构化数据、分板块Sitemap、静态化等技术基础;引导外链,靠优质帖子吸引引用;用数据监控迭代。核心是激活存量内容,靠时间复利提升权重。
GitHub Computer Use 进入公共预览,可自动操作桌面 GUI,风险从错误回答升级为真实操作。文章主张在模型外设三维门禁:按应用、动作类型和数据敏感度决定自动、询问或拒绝;权限应绑定任务与有效期,敏感数据直接拒绝,执行前复核关键字段,日志最小化。
Flex-π 是华盛顿大学与英伟达提出的 60 亿参数世界-动作模型,旨在调和 VLA 与 WAM 之争。它用单一冻结 VAE 同时编码 RGB 与 3D 点图,用 DINOv3 提供物体语义,经 Mixture-of-Transformers 融合。训练时随机掩蔽视觉流并施加跨模态强制,使单一权重在推理时可灵活选择快慢路径,兼顾实时性与泛化,无需额外传感器或重训先验。
论文提出Show-Harness具身控制框架,使视觉语言模型通过离散语义动作单元直接操控机器人,无需微调即可零样本控制,少量微调可适配小模型;并提出GUMI界面,支持人类与智能体在统一动作空间采集示教数据,实现跨形态复用与协同采集。
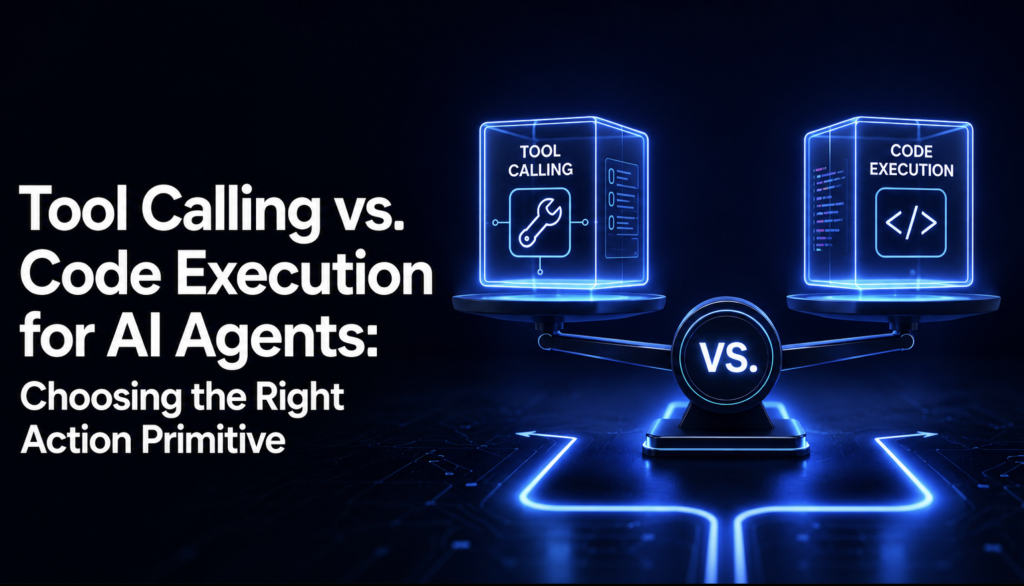
文章比较了AI智能体的两种动作机制:工具调用与代码执行。工具调用由模型逐次发起单个请求,结果返回上下文,适合单次、低延迟查询,便于审计;代码执行让模型编写脚本在沙箱中批量调用工具,仅返回最终结果,适合扇出与聚合任务,可减少token消耗并提升准确率。选择取决于调用次数、数据敏感性、延迟、基础设施与审计需求,多数生产智能体会按任务混合使用两者。
Figure、Dyna与亮源新创探索用人类视频预训练机器人。Figure的Index预训练将陌生家庭任务成功率从9%提升至56%,但未公开规模与闭环成功率的关系;Dyna验证人类视频规模扩大可持续提升真机表现;亮源新创用互联网视频验证迁移缩放定律。核心问题是人类经验能否成为可扩展的机器人预训练数据。
AWS公开了π0机器人的微调流程,称动作误差降低约89%。但早期评测因训练回合混入评测导致误差虚高至96%,修正数据切分后才可信。文章强调,关键在于训练与评测回合严格隔离,且89%仅为离线误差,不等于闭环任务成功率。
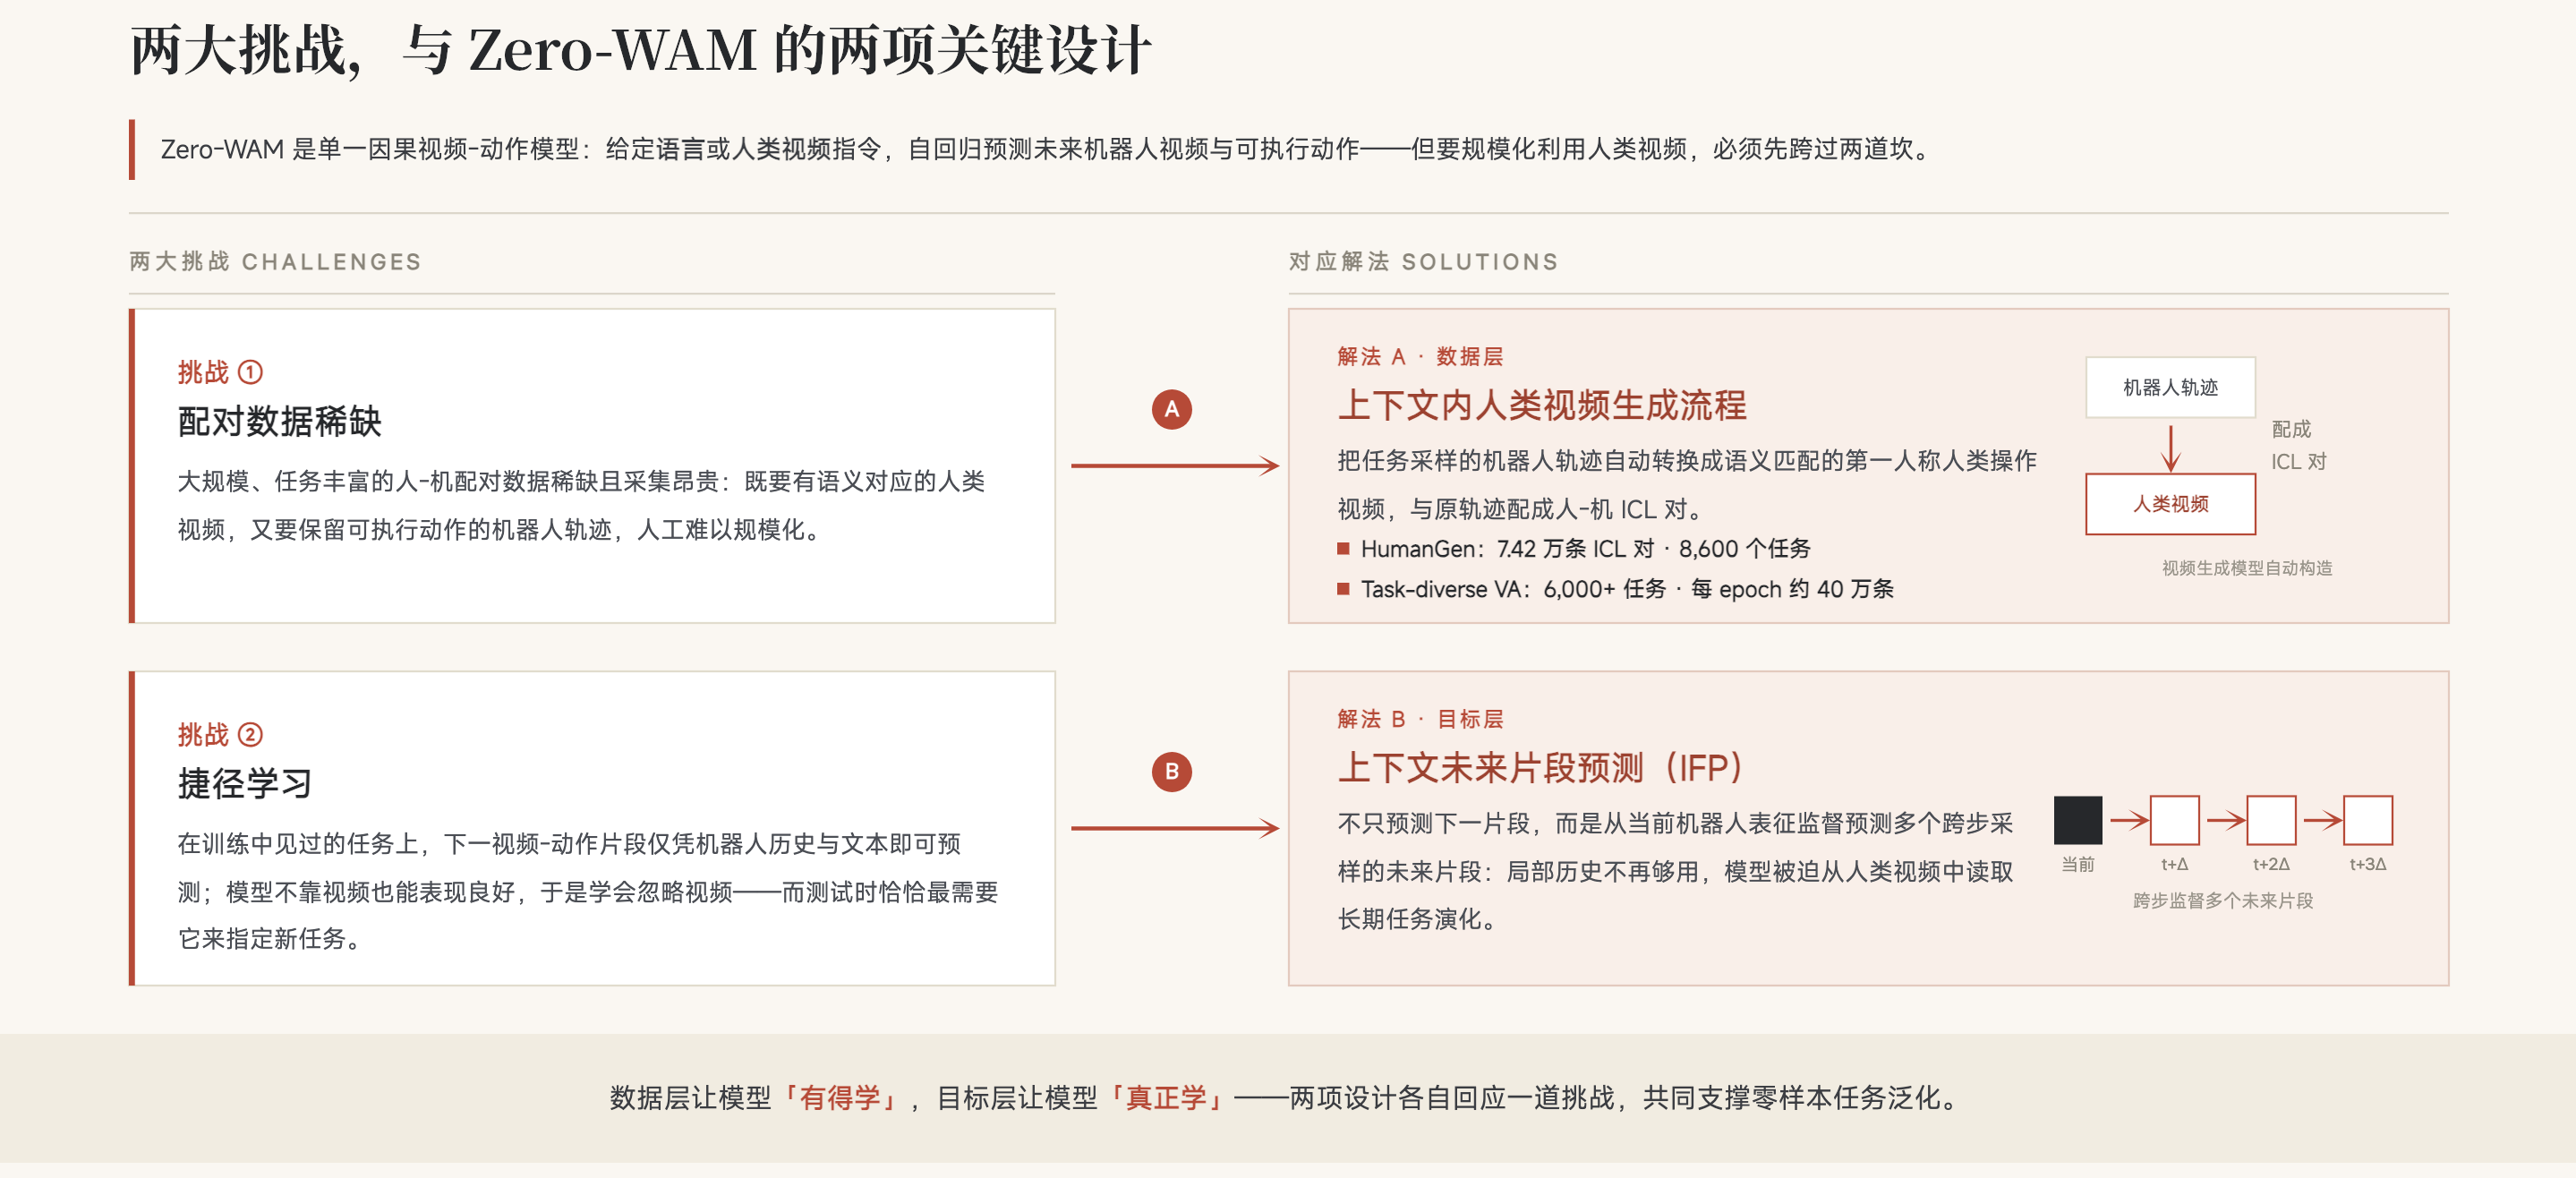
蚂蚁灵波与港科大联合提出Zero-WAM,一种因果视频-动作模型,通过上下文学习实现机器人零样本跨任务泛化。它利用人类视频作为任务描述,并构建HumanGen数据集(含8.6K任务、74.2K人机样本),提出上下文未来片段预测目标,避免模型走捷径,从而从视频中提取任务信息执行未见任务。
Facet-0是一种面向高精度接触操作的机器人基础模型,结合视觉-语言骨干与流匹配动作专家,联合预测动作及未来腕部扭矩,将接触视为可预测结果。基于ManuFacet-1K数据集训练,并通过Action–Wrench Critic评估交互价值,实现策略细化,提升装配可靠性。
BrowserSkill 通过 bsk CLI 和浏览器扩展,使 AI 能直接操作浏览器,在独立窗口中观察页面并执行点击、输入等动作。其录制功能可记录操作流程供 AI 学习,适合重复性后台任务。使用时需注意隐私,避免在敏感页面录制。
Generalist AI发布机器人基础模型GEN-1.5,支持一次性学习,机器人看3-12秒演示即可学会新任务,无需梯度更新或微调。模型能举一反三,结合不同演示,甚至从模拟器学后直接应用于现实。此能力源于大规模物理数据预训练,类似GPT-3的上下文学习,但成功率仅59%,提升至83%需额外微调。
本文介绍Tetragon v1.7.0的TracingPolicy选择器与动作机制。选择器内过滤器为AND关系,每个hook最多5个选择器,多个选择器采用first-match短路逻辑,默认动作为Post。matchArgs、matchBinaries等过滤器按路径或参数匹配,NoPost抑制事件但保留其他动作,Override和Sigkill在内核执行,GetUrl等动作在用户态执行。CEL-in-BPF有宏限制,最多8路表达式。
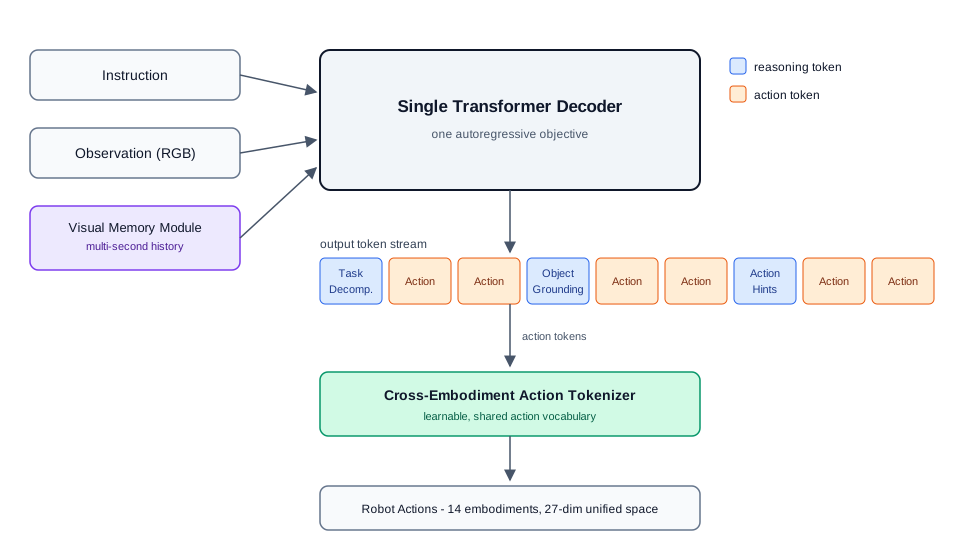
银河通用发布G0.5模型,采用单一自回归流同时处理推理与动作,替代主流VLA架构中VLM仅作编码器、另配动作专家的设计。该模型通过跨本体动作tokenizer、原生思维链和视觉记忆模块,实现推理与动作共享权重。真机微调成功率76.7%,优于π0.5和GR00T-N1.7,但BEHAVIOR基准绝对成功率仅31.4%,实验样本量小,评测协议多样,需谨慎看待。
本文介绍Claude Code的Cron家族工具(CronCreate/CronDelete/CronList),用于定时调度未来动作。核心是CronCreate,支持一次性或周期性任务,采用标准cron语法,仅限会话内有效,7天自动过期。设计强调复用行业约定、负载分散(避开整点)、诚实透明,与Task家族、Bash后台及Monitor工具分工明确,是唯一跨越时间的工具原语。
ω-0是一种用于人形机器人并行行走与操作的世界动作模型,通过潜在预测而非视频生成来学习全身协同控制。它联合训练未来视觉潜变量与全身动作潜变量,避免依赖大型视频生成器。模型利用人类数据预训练,并构建ω-HOME数据集,在11个家庭任务上实现统一模型控制,展现平滑的全身协调能力。
该论文提出w-0模型,联合预测未来视觉与全身动作,解决人形机器人并发运动操作难题。在11个家庭任务上优于9种基线,发布40小时w-HOME数据集。模型分三阶段训练,结合VLM与V-JEPA,支持多视角输入。局限是硬件耦合、延迟高、缺安全机制,未来需验证跨平台泛化。
MiniCPM推出具身智能模型系列,包括15亿参数的机器人操作模型和0.9B参数的目标跟踪模型,实现端到端映射与实时跟踪。HyperAI官网更新了9个数据集、8个教程等资源,涵盖数学推理、视觉推理等领域,并精选社区文章和百科词条。
完成下面两步后,将自动完成登录并继续当前操作。