GigaWorld-Policy-0.5是一种以动作为中心的世界动作模型:训练时利用未来视觉动态提供密集监督,推理时仅解码动作、不生成未来视频,从而降低计算开销。它采用混合Transformer架构,将视觉动态建模与动作生成分配给不同专家模块,在RTX 4090上推理时延约85毫秒。预训练结合动作条件世界建模与WAM训练,并用AutoResearch流水线自动搜索训练配置。实验表明,该模型在保留未来视觉监督优势的同时显著提升了推理效率。
该文章介绍香港大学Taku Komura教授团队在动作生成领域的研究。其2016年论文获SIGGRAPH时间检验奖,首次用深度学习学习人类运动先验,生成自然动作。团队后续扩展至场景交互,开源项目AI4Animation获8000+星。研究正应用于物理AI,用消费级设备低成本采集人类操作数据,训练世界模型,推动具身智能走向真实生活。
星海图提出的G0.5模型将视觉语言模型与动作生成统一为单一自回归序列,通过共享权重实现推理与动作的耦合,提升机器人控制效率。该模型采用可学习的动作分词器和视觉记忆模块,优化动作生成过程,减少离散化负担,能够在零样本条件下分解任务,直接生成动作,增强对复杂场景的适应能力。
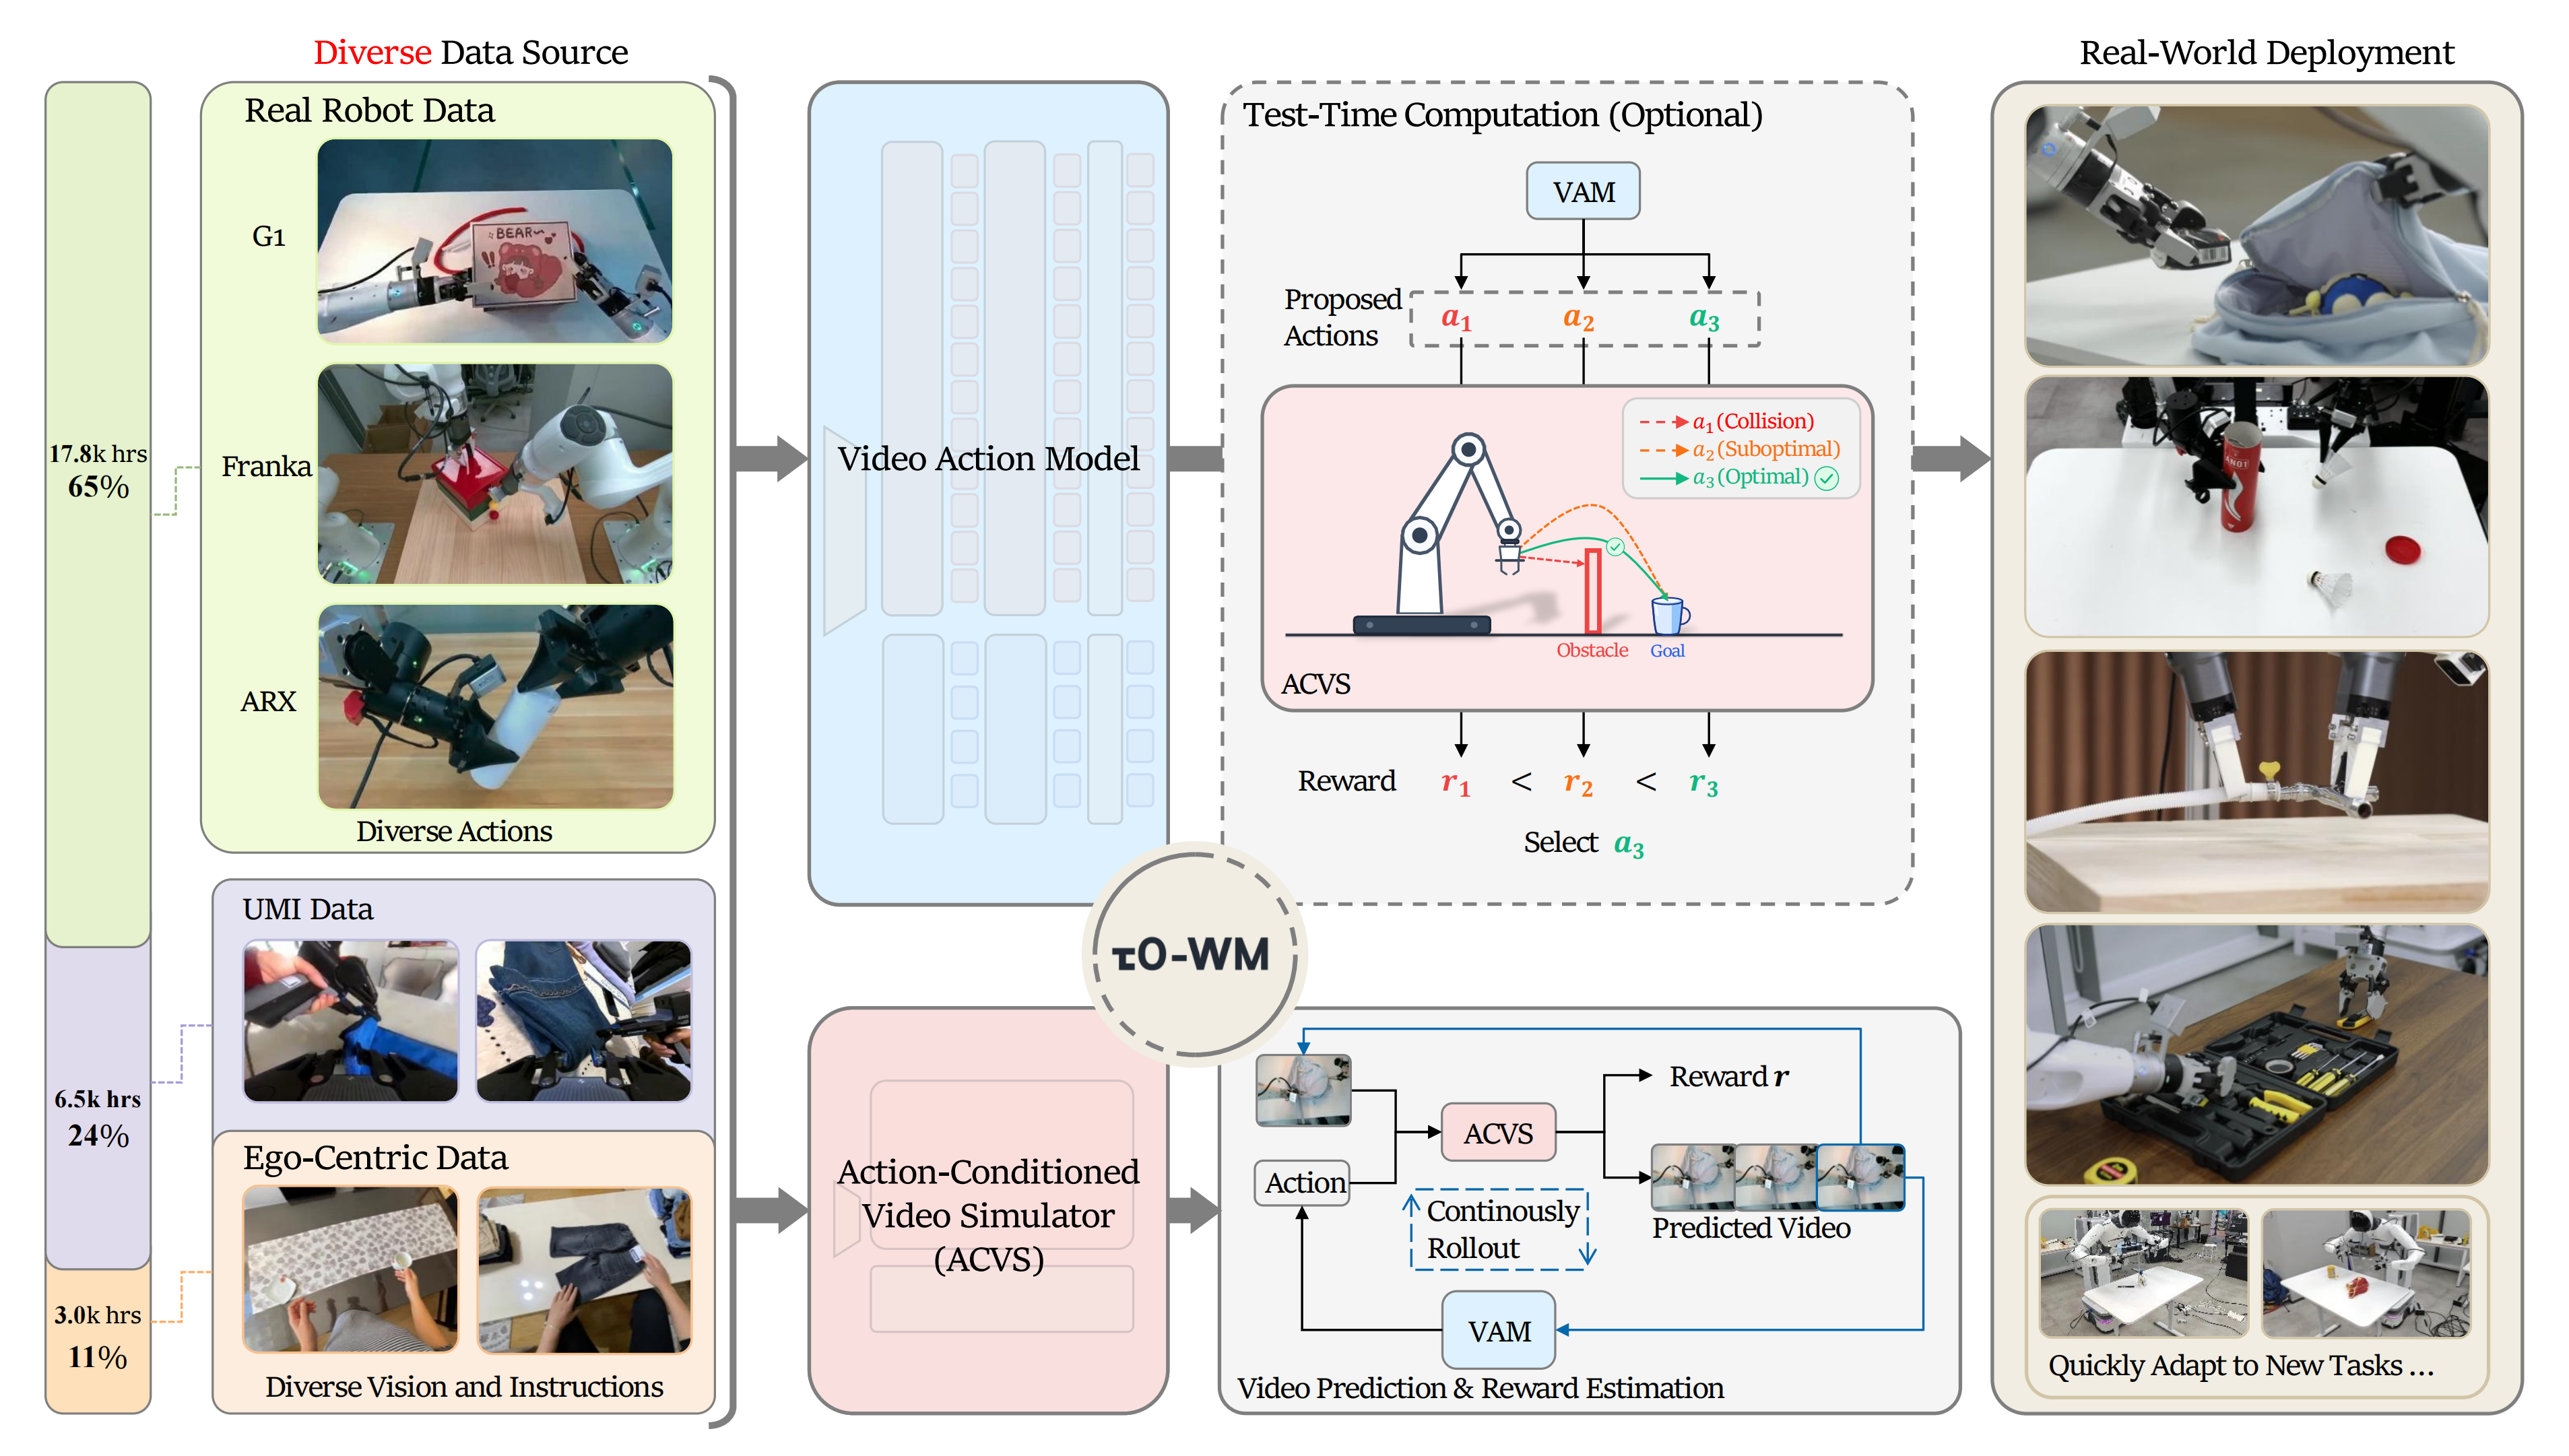
研究者提出了一种名为τ0-World Model(τ0-WM)的统一视频-动作世界模型,旨在提升机器人操作的预测能力。该模型结合视频预测、动作生成和任务评估,利用27,300小时的多样化数据进行训练。τ0-WM通过共享的预测网络,提供视频动作模型和动作条件视频模拟器两个接口,优化机器人在执行前的决策过程。
GraspVLA是一种基于十亿级合成抓取数据集的机器人抓取模型,结合视觉语言模型和动作生成机制,提升了抓取技能的泛化能力。该模型通过渐进式动作生成方法,实现了仿真到现实的迁移,展现出优异的零样本性能。
北大和人大团队在通用人形机器人动作生成领域取得突破,推出百万规模数据集MotionLib和动作生成模型Being-M0,实现复杂人类动作向多类型机器人迁移,提升跨平台适配能力。
本研究提出R-Lodge模型,解决生成舞蹈模型中表现一致性不足的问题,通过舞蹈校准技术和递归序列表示学习,显著提升舞蹈动作的一致性。
研究团队提出了一种新型多模态语言模型,能够同时处理音频和文本输入,并生成相应的动作。该模型统一了人类动作的言语和非言语语言,尤其在数据稀缺情况下展现出优异的动作生成和理解能力。
本研究提出了一种新的粗到细自回归策略学习框架(CARP),旨在提高机器人视觉运动策略学习的效率和灵活性。该框架通过多尺度表示学习和细化预测两个阶段,显著提升了动作生成的精度和流畅性,推理速度提高了10倍,并实现了竞争性的成功率。
文章介绍了OmniH2O人形机器人,通过语音指令和预训练的文本到人体动作生成扩散模型(MDM)来控制动作。MDM利用文本提示生成多样化动作,体现文本到动作的多对多映射。其目标是在特定条件下合成人体动作,支持多种输入。扩散建模采用马尔可夫噪声过程,并使用几何损失正则化生成自然连贯的动作。
本研究提出了一种轨迹感知主要流形框架,旨在恢复流形骨干并生成样本。通过内在维度正则化,该框架实现了紧凑的流形表示和少样本图像生成。实验结果表明,该方法在分类准确性和样本生成方面表现优越,尤其在复杂文本描述下的动作生成任务中。
本文介绍了基于扩散模型的人体动作生成方法,重点在于细粒度控制、语义对齐和高质量合成。研究提出的新算法GMD和LGTM显著提升了文本驱动的动作生成效果,尤其在复杂描述下表现优越。通过层次化和多阶段流程,解决了语义差异问题,实现了更准确的动作生成。
本研究提出了基于扩散模型的动作生成框架ReMoDiffuse,通过结合检索机制改善去噪过程,提升文本驱动动作生成的多样性。相关模型如MoDiff、MotionDiffuse和CrossDiff在运动合成和预测方面表现优异,能够生成复杂的人类运动,适应实时命令,展现出强大的鲁棒性和生成质量。
本研究介绍了CameraCtrl模型,通过精确控制相机姿态提升T2V模型的可控性和泛化性。结合三维相机运动和多模态变压器,能够有效生成视频。提出的协作视频扩散(CVD)框架通过跨视频同步模块提高了不同相机轨迹下视频的一致性。此外,CoMo模型在动作生成和编辑方面表现优异,VideoComposer模型实现了合成视频的条件控制。研究还提出了Direct-a-Video和COMD模型,增强了用户对对象和相机运动的控制能力。
本文探讨了基于文本描述生成3D人体动作的方法,提出了多角度注意机制和TEMOS框架,利用变压器实现高质量动作生成。实验结果表明,该方法在多个数据集上优于现有技术,能够根据文本条件生成多样化的动作序列。
本文介绍了一种基于文本描述生成多样3D人类动作的方法,提出了TEMOS框架,利用变分自编码器生成高质量动作序列。研究表明,该框架在多个基准测试中表现优越,结合语言结构和上下文推理模块,提升了动作生成的精确度和多样性。
该研究提出了多种基于扩散模型的视频和动作生成方法,包括可控运动扩散模型(COMODO)和RAVE视频编辑技术,显著提高了生成质量和多样性,适用于人机协作和视频编辑等场景。
该文综述了基于深度学习的动作生成与编辑研究,涵盖利用预训练GAN分解视频动作、人到机器人动作重定向、自监督自编码器LIA潜空间线性导航生成图像、扩散模型合成数字人运动、MoStAtt机制增强视频动态、无监督局部潜子空间保持图像真实感、骨架动作生成、数据驱动运动风格转移、概率框架生成角色动画以及自监督生成多样自然人体动作等方法。
该文综述多种音频与动作生成模型:神经合成器实时生成乐器音频;DiffWave、FastDiff等扩散模型实现高保真语音合成;DDSP结合信号处理与深度学习;MIDI-DDSP提供层次化音乐控制;MoDiff、MoDi用于动作生成;DeepMoD发现偏微分方程。
该文综述扩散模型在多领域的应用:6D物体姿态估计通过逆扩散实现2D-3D对应;GMD有向扩散模型提升文本驱动人体动作生成;PIDM解决人体图像转换;视频生成用隐式条件建模运动,优于GAN方法;EMDM加速高质量动作生成;MoVideo结合深度与光流实现文本/图像到视频生成;DragDiffusion实现点式图像编辑;DDPM生成多样化风格化人体运动;统一条件框架提升低光去噪、去模糊与JPEG恢复;DDVM用于单目深度与光流估计,性能领先。
完成下面两步后,将自动完成登录并继续当前操作。