本文介绍 Koog 的 Agent 记忆与恢复机制:ChatMemory 按 sessionId 续接多轮对话,默认存于内存,可通过自定义 Provider 共享或持久化;预处理器支持截窗与过滤,但并非无损。历史压缩采用摘要或事实提取缩短上下文,需保留 system 消息与工具调用关系。Persistence 保存执行检查点,支持跨进程恢复,但要求状态可序列化,且不会自动撤销工具副作用,需借助 RollbackToolRegistry 补偿。LongTermMemory 按当前问题检索长期知识,属 1.3.0-beta 版本。
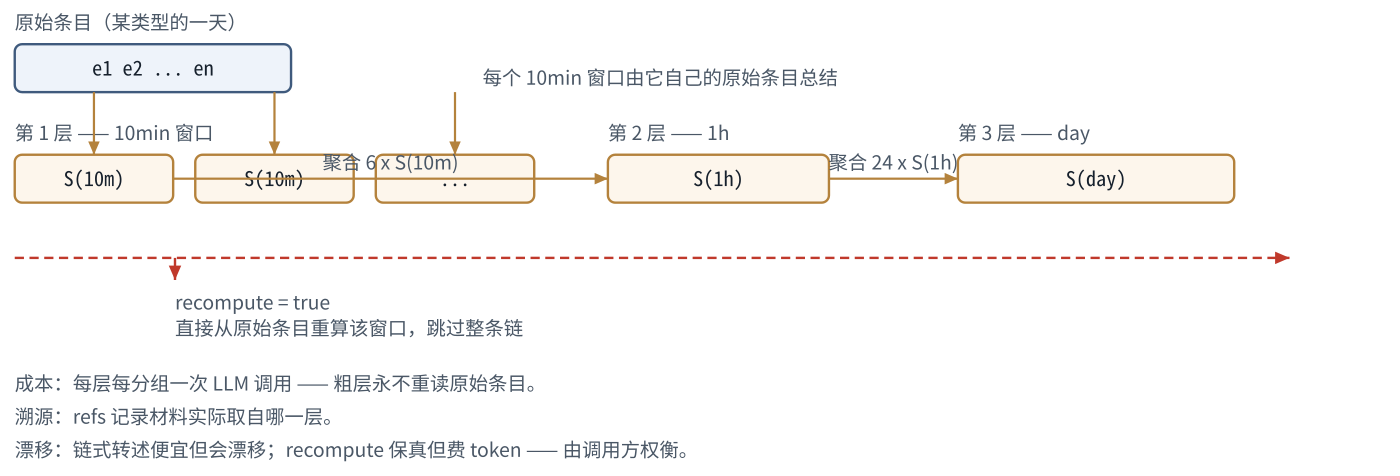
忆时塔(Chronomem)是一种介于扁平存储与一次性压缩之间的Agent记忆架构:记忆按时间分层堆叠,越久越粗;底层原始条目append-only永不删除,上层摘要带引用可审计下钻。其核心是区分精确回想(沿引用链下钻,服务端零LLM)与语义回想(读LLM摘要,有损压缩),并强调摘要本身是时序条目,可递归自底向上总结。系统以MCP服务形式提供,含五道护栏控制成本。
本文介绍五种降低大模型Token消耗的提示词优化技巧:用结构化约束替代冗长指令;少样本示例控制在三到五个;对长文档动态裁剪上下文,仅保留相关段落;利用提示缓存复用固定前缀;将思维链推理与最终答案分离,丢弃推理过程。这些方法可显著降低成本并提升响应速度。
Nathan Barry用gzip做文本续写实验,结果不通顺,但说明预测下一个token与压缩本质相通。作者提醒:gzip不能替代LLM,其能力仅来自局部统计,缺乏推理泛化。工程启发是:许多任务未必需要大模型,可先用压缩率、编辑距离等轻量方法检测异常,再按需升级,避免过度依赖GPU和外部API。
维格纳曾惊叹数学能精准描述物理世界,如今类似悖论出现在大语言模型上:仅靠预测下一个词,模型内部却涌现出符号推理结构,其表征能与人类分类对齐。研究显示,模型追求极致压缩,人类则保留冗余细节。若语言只是随机拼贴,就不该包含重建思维结构的信号,但它确实包含了。
LightNav-0是一种基于Qwen3-VL-4B构建的紧凑通用具身导航模型,无需任务特定预测头。它通过双通道指向接口(可供性点与物体点)表达空间意图,并利用残差向量量化动作分词器将意图映射为10个SE(2)航点,实现精确连续控制。模型采用时间感知视觉历史压缩、具身推理中期训练、监督微调与强化学习,单一模型即可支持指令跟随、开放词汇物体导航和视觉跟踪,训练数据覆盖2K+场景、4K+小时。
fastalp 是纯 Rust 实现的 ALP 浮点无损压缩算法,面向时序数据库与 IoT。相比 C++ 原版,端到端压缩提速 2.58 倍,解压达 25.3 GB/s,压缩比提升 60%,准常量数据可达 744 倍。核心优化包括三级剪枝、单遍寄存器解码、精确除法、自适应 Delta 及硬件舍入,支持零堆分配与 no_std。
日本团队利用超分辨显微镜发现,活跃基因所在的真染色质并非教科书描述的松散开放状态,而是压缩成直径约200纳米的团块。粘合素不维持这种压缩,而是隔离团块;缺失粘合素后压缩仍存在,但核小体乱窜、基因串门、共爆发增加。压缩由静电驱动,隔离依赖粘合素,颠覆了“压缩即沉默”的传统模型。
Cloudflare实习生Aashi Patel开发了Cache Transcoding系统,利用Zstandard压缩算法在Pingora中编码缓存资产,将可压缩文本平均缩小至原大小的三分之一。该系统以少量CPU开销换取存储和带宽节省,测试中处理了超百万请求,验证了架构可行性,未来将优化压缩级别和参数。
Codex项目近期合并多项PR,放弃上下文压缩机制,改为通过历史记录和持久笔记继续任务。模型可主动开启新窗口,丢弃旧内容,新窗口通过笔记恢复任务状态,需细节时查询历史。此举避免压缩导致的信息丢失和算力浪费,提升长任务执行效率,但功能仍在开发中。
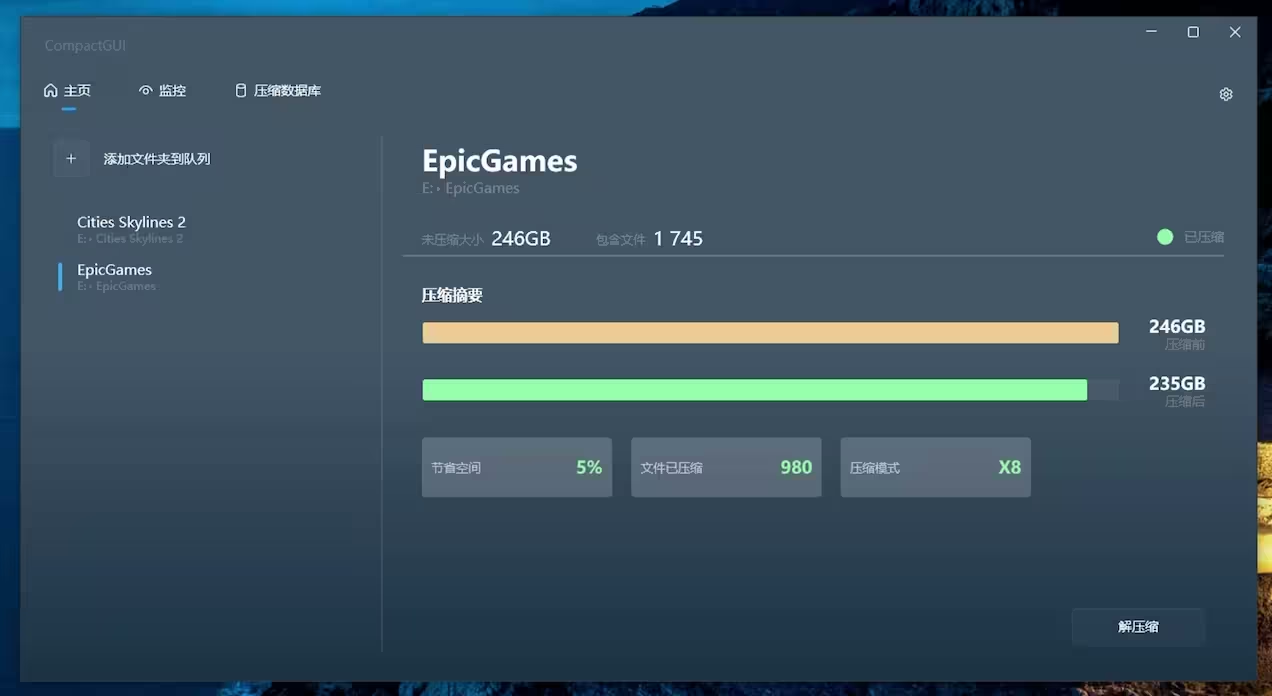
CompactGUI是一款利用Windows NTFS压缩功能的图形界面工具,可压缩现有文件节省空间,如压缩Epic游戏文件夹节省5%空间。压缩后游戏可直接运行,对现代CPU影响极小,甚至可能缩短加载时间,尤其在机械硬盘上。新版4.0测试版重新设计界面,支持中文,需下载相关运行库。
本文介绍GeekAgent开发第5天实现历史压缩功能。当对话历史超过4000字符阈值时,自动将旧消息摘要为一条系统消息,保留最近6条完整消息,防止上下文溢出且不丢失关键信息。提供自动触发和手动/compact命令两种入口,压缩过程显示黄色进度提示。通过实测验证,压缩后模型仍能准确回答旧对话中的事实。
本文介绍Hermes Agent的长会话架构,核心是稳定Prompt前缀以命中缓存、分层压缩上下文(保留头尾总结中段)、用SessionDB存储快照,并通过SQLite租约机制防止多进程并发写坏历史。压缩失败时有回退或暂停策略,确保长期会话的可靠性与可恢复性。
本文探讨AI智能体记忆管理的核心矛盾:压缩与递归。RNN式压缩有损细节,导致长任务中遗忘;RLM式递归保留细节但索引膨胀,成本高。实验显示,智能体在长周期任务中因记忆管理缺陷,仅追平人类82%进度。RLM通过可搜索索引处理千万级Token,但高百分位成本飙升。文章指出,最优平衡点尚未找到,记忆管理或需在“记不住”与“查不到”间抉择。
本文介绍Ceph BlueStore写路径,涵盖queue_transactions()到aio完成的流程,重点分析直写与deferred两条分叉路径。直写适用于大块新分配,数据先落盘再提交元数据;deferred用于小写或覆盖,先提交KV再异步落盘。文章还讨论min_alloc_size配置、checksum计算时机、压缩处理及deferred路径的带宽竞争问题。
压缩与预测在数学上等价,大语言模型本质是超级压缩器。通过上下文预测下一个符号,概率越高所需比特越少,如字母U在Q后概率飙升,压缩效率大增。LLM训练目标交叉熵损失即最小化比特数,与压缩原理一致。虽压缩能力极强,但因模型庞大、计算成本高,无法替代gzip等实用工具。
向量量化通过码本和索引压缩高维数据,码本由K-Means训练,索引用k位表示,压缩比高但精度受码本大小限制。乘积量化将向量分割为子向量,分别量化,牺牲压缩比换取精度控制,码本存储不变,索引存储增加N倍。两者适用于数据转移瓶颈场景。
本文面向重度使用Claude Code/Codex的工程师,解析上下文窗口、压缩与缓存三概念及其因果链。上下文是模型单次可见的输入输出总和,有硬上限且随token增多质量下降;压缩在窗口将满时用摘要替换历史,会永久丢失细节;缓存通过精确前缀匹配复用计算,失效仅增加成本与延迟,不影响正确性。实践建议:会话开头定好模型,中途只追加不修改,任务间用/clear,压缩趁缓存热时进行。
K3缓存大因参数多(2.78万亿)及24层无压缩层,保细节;V4缓存小因全层压缩,靠工具补缺。两者取舍精度与速度,无绝对优劣,反映技术路线与资源选择差异。
开源社区通过REAP修剪专家、GGUF量化、混合精度等技术,将7530亿参数的GLM-5.2模型压缩至消费级硬件可运行,体积削减80%,成本从7万美元降至1.5万美元,智商保留82%。KV缓存优化提升上下文至74万token,Moet方案实现2位权重运行。开源创新推动AI模型个人化,挑战高价硬件垄断。
完成下面两步后,将自动完成登录并继续当前操作。