Yac 3.0 发布,重点优化缓存读写性能:新增 inline 机制,短 key 的 value 直接存入 slot,省去分配和拷贝,double 也可内联;读路径改用 versioned snapshot,降低读多写少场景的协调开销;引入基于 epoch 的 CRC,仅在无法确认数据稳定时校验;自研序列化器支持 array 和 stdClass,其余回退 PHP 原生;新增 Yac::has(),不更新 atime 和 hits。测试显示常见负载吞吐较 2.4.2 提升 42.3%,最高 95.4%。
文章讨论小参数语言模型在搜推场景的推理优化,核心是在延迟约束下追求有效吞吐,而非单纯追求吞吐数字。压测应将超时请求计为失败,明确端到端延迟预算并区分排队与计算耗时;合批需权衡等待成本,压测应贴近真实请求分布并关注尾部延迟。工程上应设置调用超时、及时停止过期任务、限制重试并演练降级,通过小流量对照验证质量与资源消耗。
是石科技推出Meta-Infer推理引擎,通过内核补齐、算子通信重构、并行调优与缓存复用等纯软件优化,释放非主流GPU算力。在DeepSeek、GLM等模型上吞吐最高提升6.87倍,视频生成提升2.48倍,约1.5台6000D可媲美1台B300,且无需修改模型结构。
vLLM 推出硬件无关模型层,采用双轨架构:热门模型走硬件专用路径以提升性能,长尾模型和非主流加速器保留通用可编译路径。官方称在 H100 上三种模型吞吐差距不超过 3.4%。建议建立模型—硬件兼容矩阵,用真实流量验收正确性、吞吐、P99 和显存,并锁定提交版本。
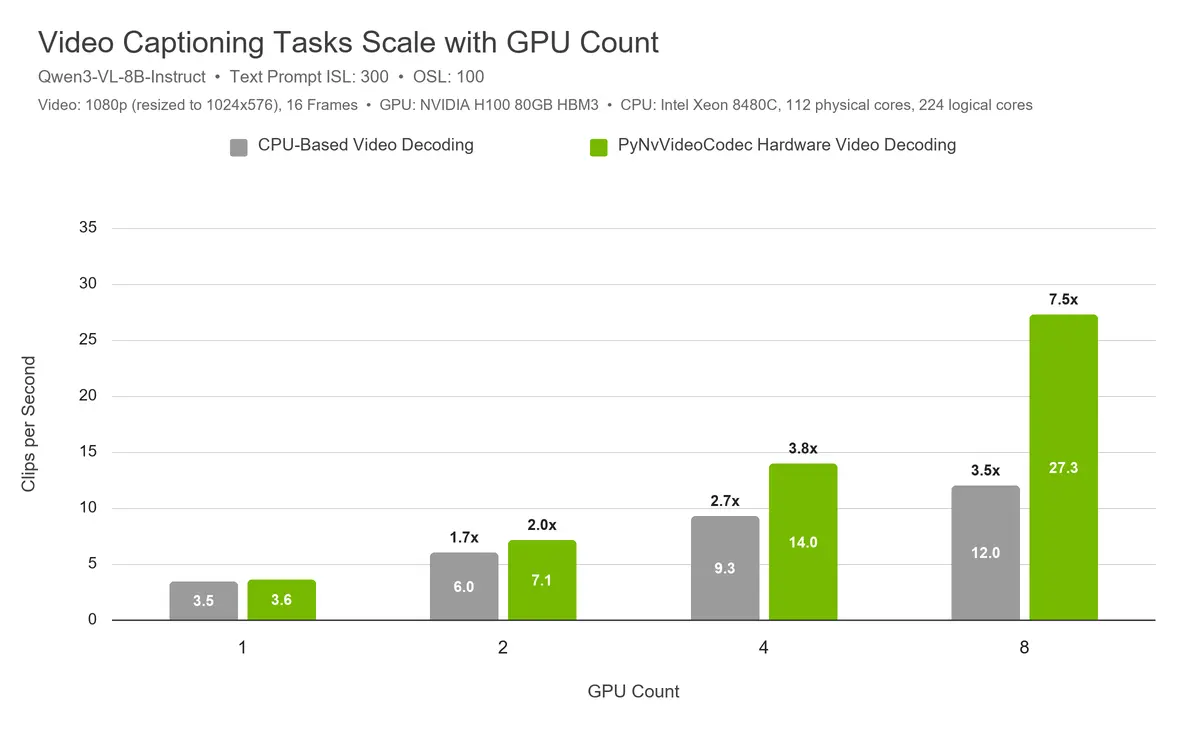
vLLM 通过集成 PyNvVideoCodec 正式支持 NVIDIA GPU 硬件视频解码(NVDEC),将视频解码从 CPU 迁移至 GPU,解决视频描述任务的 CPU 瓶颈。在 8 块 H100 配置下,吞吐量达 CPU 解码两倍以上;此前不足 4 卡即受制于 CPU,现瓶颈消除。该功能随标准 CUDA 版 vLLM 提供,需安装 PyNvVideoCodec==2.0.4,并建议先启动 CUDA MPS 守护进程。
本文介绍基于Amazon MSK Connect与Debezium的高吞吐CDC同步方案,解决AWS DMS单任务无法追平高写入量MySQL源库延迟的问题。通过单连接读取binlog、多Task并行写入Aurora MySQL,实现N倍吞吐提升,且不增加源库压力。文章涵盖架构设计、部署步骤、并行度调优及常见问题,适用于自建MySQL迁移AWS场景。
AMD MI300X显卡成功运行3040亿参数的DeepSeek V4 Flash模型,实测单流解码168.6 tok/s,总吞吐达830 tok/s。但部署过程充满挑战,需修复FP8格式不兼容、MoE路由错误等问题,显存使用接近极限,系统脆弱,仅适合技术验证,不适合生产环境。
奇异摩尔在WAIC 2026首次亮相,举办AI网络前沿生态论坛,发布国产超节点生态共建倡议和CPO技术白皮书。公司展示国产化超节点互联全栈方案及与壁仞科技合作的IBGDA技术,实现国产GPU直通RDMA网卡,提升通信效率。奇异摩尔致力于推动国产AI算力系统级协同,突破单点强、系统弱困境。
本文介绍了多个 Rust 项目,包括 yring、bon、Truce 1.0 和 BlazePilot。yring 提高了 SPSC 队列的吞吐量,bon 反思了 builder 生成器的使用场景,Truce 1.0 统一了音频插件格式,BlazePilot 展示了现代化的 Linux 文件管理器。这些项目推动了 Rust 生态的发展。
清华大学智能产业研究院的GS-Playground是一个新型多模态仿真框架,旨在推动具身人工智能的发展。该平台结合高保真视觉渲染与并行物理仿真,支持多种机器人形态的训练,提高了训练效率和真实场景迁移能力。GS-Playground通过自动化工作流简化了仿真环境构建,降低了成本,未来将开源以促进行业发展。
清华大学智能产业研究院与多家技术公司合作推出GS-Playground通用多模态仿真框架,旨在解决具身人工智能领域的核心难题。该平台实现高吞吐量并行物理仿真与高保真视觉渲染的深度融合,支持多种机器人形态的训练与部署,显著提高仿真效率与稳定性,并能快速将真实场景转化为数字资产,推动机器人技术的发展与应用。
OpenBMB推出的MiniCPM-o-4.5模型仅用9B参数实现全模态能力,强调跨模态对齐与推理效率,适合主流GPU部署,具备高性能与轻量化优势。
测试表明,NetServer在纯接收情况下每秒可处理1.4亿数据包,带编码协议头时每秒可处理190万个RPC请求。与StandardCodec相比,LengthFieldCodec在吞吐量和内存使用上表现更佳,滑动窗口模式提升显著。建议减少字典查找以优化性能。
京东云推出云原生AI推理框架,解决传统推理系统的稳定性、资源利用率和性能瓶颈问题。该框架通过智能流量调度、自动弹性扩缩容和故障自愈机制,提升推理效率和资源利用率,短文吞吐提升超过120%,GPU资源节省约26%。
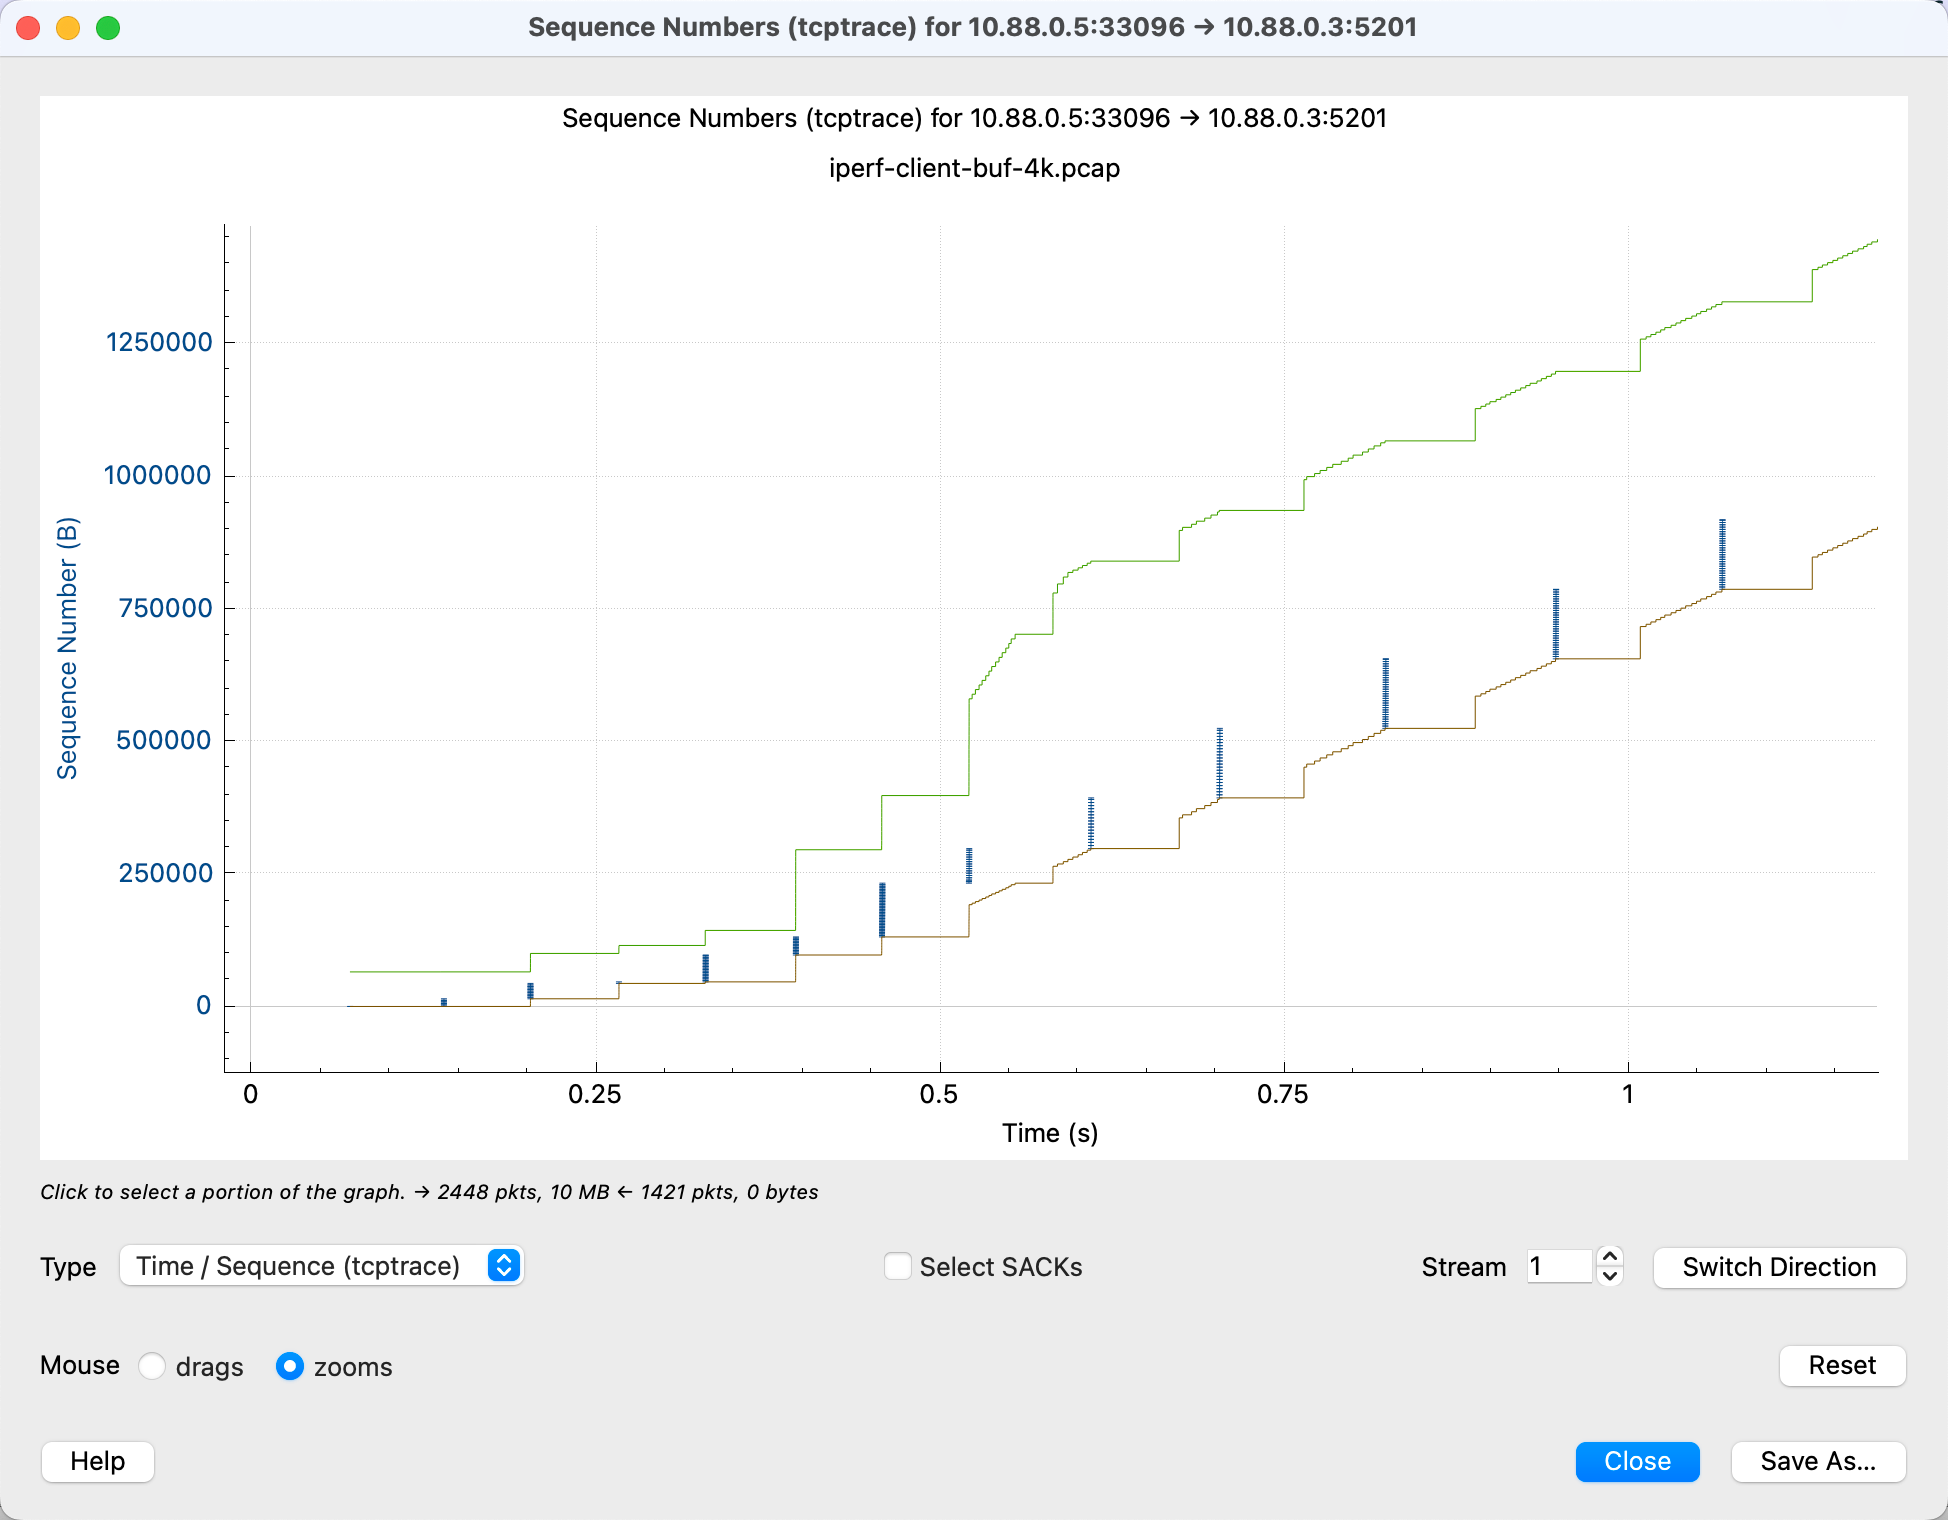
tcptrace用于分析TCP吞吐问题,图中横轴为时间,纵轴为序列号。蓝线表示发送数据,绿色线为接收窗口,棕黄线为已确认数据,红线为选择确认。通过图中距离可得出在途字节、窗口余量和RTT等信息。建议同时抓包以获取全面数据,常见问题如丢包和窗口限制可通过图形化方式分析。
分析抓包文件显示,新设备吞吐量下降主要因网卡LRO功能失效,导致数据包处理效率降低。尽管新旧设备转发速度相似,但包大小分布和ID不连续影响性能,造成部分请求超时。
rathole是一款开源的轻量级内网穿透工具,延迟与frp相近,但在高并发下表现更佳,资源占用更少。支持Windows、macOS、Linux,需公网IP,配置简单,但更新不频繁,建议无必要不折腾。
在2025大模型服务性能排行榜中,PPIO在DeepSeek-R1-0528的吞吐测试中以45.17 tokens/s排名第一,表现出色,获得行业认可,专注于优化AI基础设施。
机器之心数据服务现已上线,提供高效稳定的数据获取,简化数据爬取流程。
英伟达推出的Llama Nemotron Super v1.5开源模型专为复杂推理和智能体任务设计,吞吐量提升三倍,单卡高效运行。该模型通过神经架构搜索优化,兼顾准确性与效率,适合英语对话和编程任务。
完成下面两步后,将自动完成登录并继续当前操作。