


小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
Neki 上每秒 1.18 亿次查询

Neki平台预览版发布后,团队通过简单单分片主键查询测试扩展性。从5分片扩展到512分片,实现每秒1.185亿次查询,处理1.22 PiB数据,吞吐量随分片数线性增长。每分片约23万QPS,路由器p99延迟6.06毫秒,错误率约180万分之一。该测试为只读、无副本、无故障切换。

Neki 上每秒 1.18 亿次查询

PlanetScale - Blog PlanetScale - Blog · 2026-09-11T00:00:00Z

CUDA时间切片是GPU默认共享机制,但低利用率进程会拖慢其他进程。NVIDIA MPS允许多进程并发执行内核,提升GPU利用率。文章通过Triton内核测试展示,启用MPS后8个单SM工作负载的吞吐量从3.02提升至17.09请求/秒,约6倍改进,并提供了启用/禁用MPS及Docker配置方法。

CUDA多进程服务

Lei Mao's Log Book Lei Mao's Log Book · 2026-09-08T07:00:00Z
每瓦特性能提升高达30倍:NVIDIA Vera Rubin NVL72为AI代理树立新效率标准

NVIDIA Vera Rubin NVL72在代理式AI工作负载中,每兆瓦吞吐量比GB300 NVL72高30倍,每百万token成本低35倍。该平台通过软硬件协同设计,支持分离式服务、专家并行、KV缓存等优化,提升推理效率,适合大规模AI工厂部署。

每瓦特性能提升高达30倍:NVIDIA Vera Rubin NVL72为AI代理树立新效率标准

NVIDIA Blog NVIDIA Blog · 2026-08-24T15:00:19Z
14.3 万条/秒!VictoriaMetrics 亲自“开考”,把 8 大主流日志采集器按在地上摩擦

VictoriaMetrics 发布日志采集器基准测试报告,其新品 vlagent 在 1 核 1GB 限制下吞吐量达 14.3 万条/秒,是 Fluent Bit 的 4.5 倍、Fluentd 的 28 倍,且资源消耗最低。测试还发现 Fluent Bit 和 Vector 存在日志轮转丢字段、默认配置漏日志等正确性问题。vlagent 目前不支持多行日志合并和非 JSON 解析,适合 JSON 结构化日志场景。

14.3 万条/秒!VictoriaMetrics 亲自“开考”,把 8 大主流日志采集器按在地上摩擦

Tony Bai Tony Bai · 2026-08-20T22:00:00Z
并发与吞吐量:为何更多并行反而会让数据库变慢

数据库并发与吞吐量并非线性关系。文章通过MySQL故障案例说明,高并发会因锁竞争和快照版本链重建导致吞吐量骤降。解决方案是降低事务池大小并引入排队机制,模拟线程池行为,以控制并发、吸收突发流量。核心原则是:面对共享资源竞争,限制并发反而能提升总吞吐量,需根据工作负载特性谨慎应用。

并发与吞吐量:为何更多并行反而会让数据库变慢

PlanetScale - Blog PlanetScale - Blog · 2026-08-07T00:00:00Z
超越下一个词元预测:扩散语言模型与自回归语言模型的性能表征

本文比较了自回归语言模型(ARMs)与扩散语言模型(DLMs)的性能。DLMs通过并行生成令牌提高算术强度,但长上下文扩展不佳;块状解码可改善此问题。批处理推理中,ARMs因序列并行优势吞吐量更高。减少采样步数是DLMs降低延迟的关键。

超越下一个词元预测:扩散语言模型与自回归语言模型的性能表征

Apple Machine Learning Research Apple Machine Learning Research · 2026-08-07T00:00:00Z
测量Transformer推理性能

本文介绍如何测量Transformer模型推理性能,核心指标包括延迟、首令牌时间(TTFT)、每输出令牌时间(TPOT)、吞吐量、内存使用和每令牌成本。测量需区分预填充和解码阶段,使用墙钟计时或CUDA事件,并注意GPU同步和预热。并发请求测试可评估吞吐量,多GPU可复制或分区模型。最终需结合成本与质量评估系统效率。

测量Transformer推理性能

MachineLearningMastery.com MachineLearningMastery.com · 2026-08-04T14:00:56Z
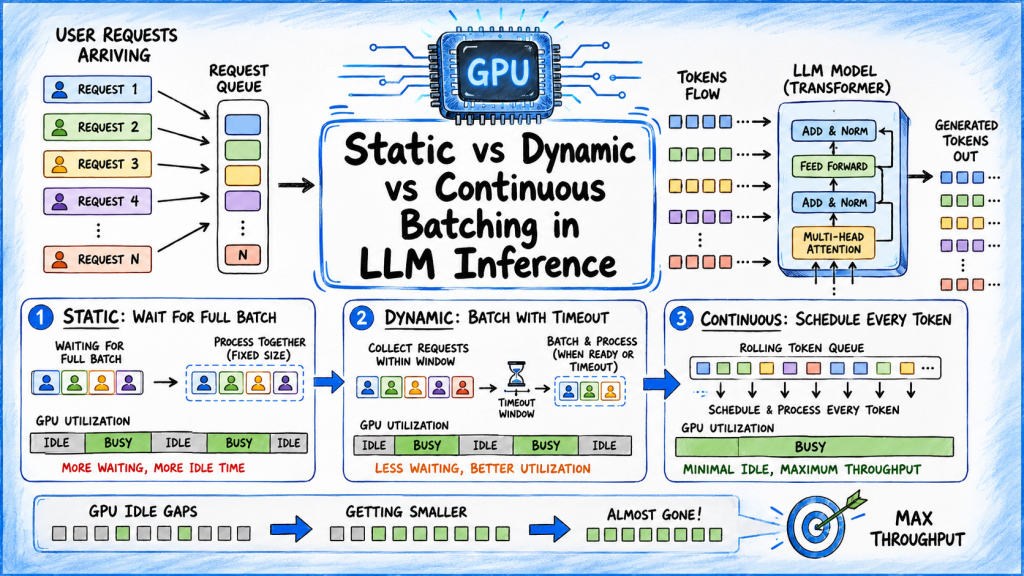
LLM推理中的静态、动态与连续批处理

静态批处理等待批次满后才运行,延迟高;动态批处理通过超时窗口改善等待,但批次内仍受最慢请求影响;连续批处理以解码步骤为单位调度,序列完成即释放槽位,吞吐量高,适合生产级LLM服务。

LLM推理中的静态、动态与连续批处理

MachineLearningMastery.com MachineLearningMastery.com · 2026-08-04T12:00:10Z
AMD MI355X单节点跑Kimi K3达952t/s:每美元吞吐量暴打B300

AMD MI355X在运行Kimi K3模型时,凭借更低价格和更高每美元吞吐量,性能超越英伟达B300。通过修复投机解码和预填充内核的软件缺陷,MI355X单节点速度达到B200的3.8倍,首字延迟大幅降低。文章认为,CUDA生态并非不可撼动,硬件性价比和工程师修bug能力正成为新护城河。

AMD MI355X单节点跑Kimi K3达952t/s:每美元吞吐量暴打B300

极道 极道 · 2026-08-02T06:08:00Z
有传言称谷歌正在研发名为Frozen v2的芯片 将AI模型部分蚀刻到芯片上提高吞吐量

谷歌研发Frozen v2芯片,将Gemini模型部分决策蚀刻于硅晶片,吞吐量较现有TPU提升6至10倍,计划2028年量产。此举应对算力短缺,但全蚀刻限制模型更新,故采用冻结架构、允许权重更新的方案,以延长寿命并支持多版本模型,与TPU并行发展。

有传言称谷歌正在研发名为Frozen v2的芯片 将AI模型部分蚀刻到芯片上提高吞吐量

蓝点网 蓝点网 · 2026-07-22T01:00:49Z
为什么有效吞吐量比吞吐量对LLM服务更重要

本文通过vLLM在单GPU上的基准测试,对比了吞吐量与“有效吞吐量”(goodput,即满足延迟目标的请求数)。结果显示,仅优化吞吐量会牺牲TPOT延迟,导致服务体验变差。作者强调,应设定TTFT和TPOT目标,通过自动化搜索寻找最佳配置,而非盲目追求高吞吐量,并指出配置需随流量和模型变化持续调整。

为什么有效吞吐量比吞吐量对LLM服务更重要

Cloud Native Computing Foundation Cloud Native Computing Foundation · 2026-07-20T11:00:00Z
Kimi以存储换计算:吞吐量暴涨115%,空头错看了哪张底牌?

Mooncake架构通过分布式KV Cache缓存池,将Kimi请求吞吐量提升115%,获存储顶会最佳论文。它分离预填充与解码节点,全局共享缓存,解决长上下文瓶颈。该架构拉动DRAM、光模块、SSD需求,开源生态正跟进,成为行业标准。

Kimi以存储换计算:吞吐量暴涨115%,空头错看了哪张底牌?

极道 极道 · 2026-07-18T23:24:00Z
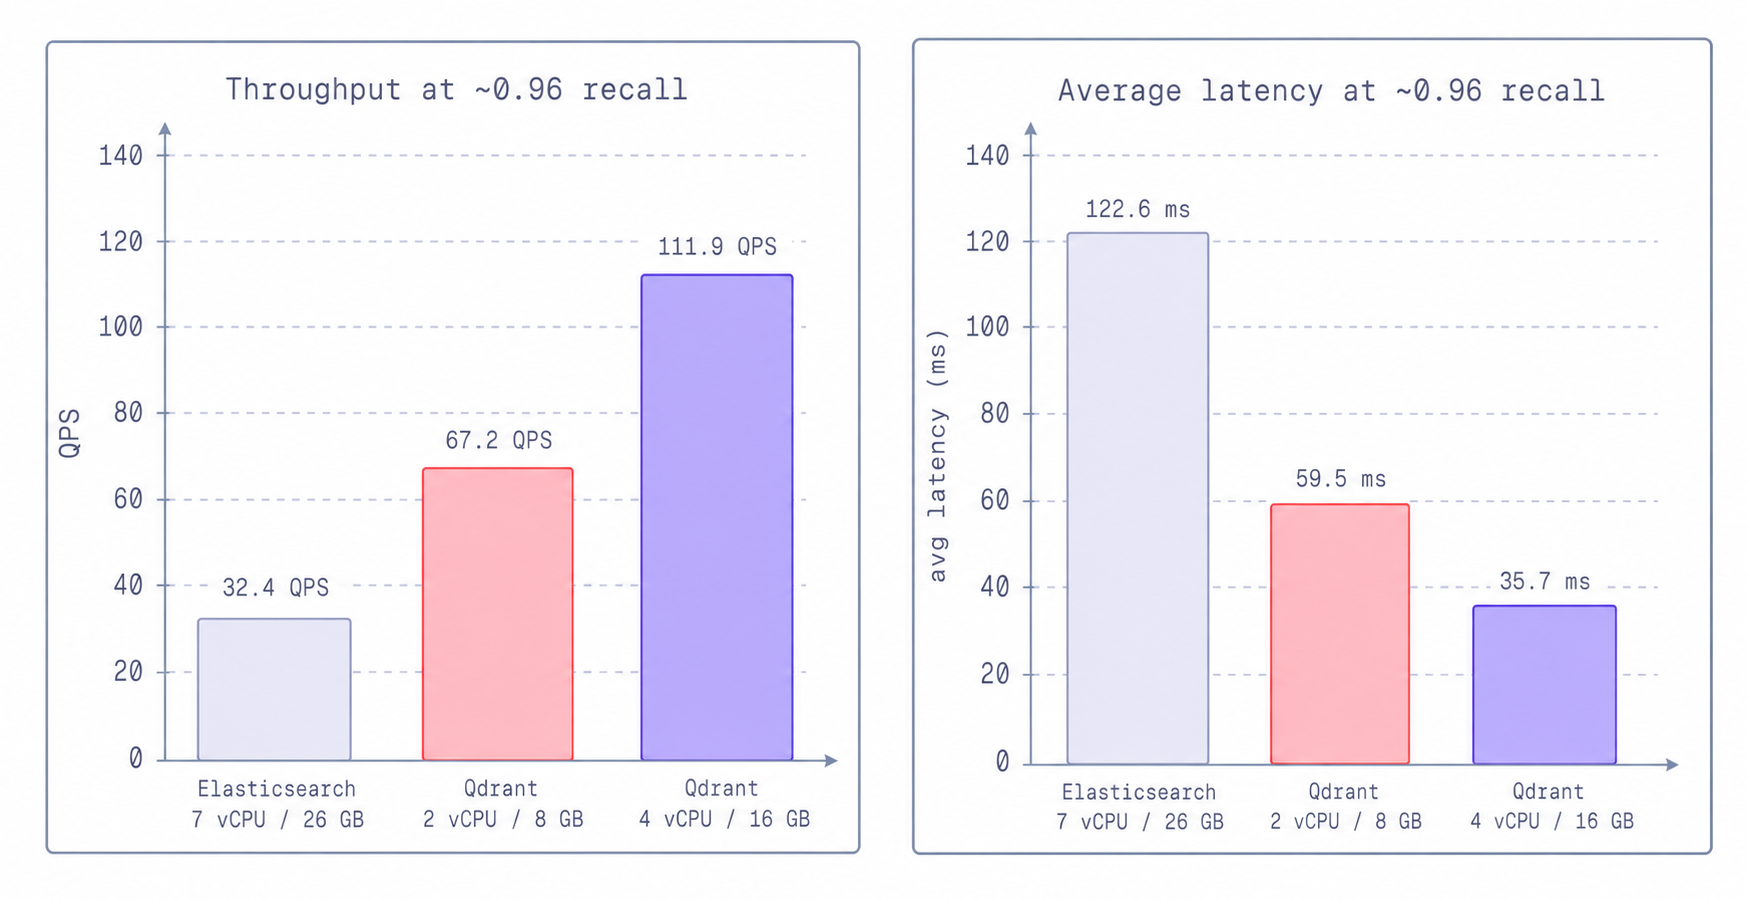
Qdrant在吞吐量上提高了2倍,延迟降低了50%,计算资源减少到1/3,超越了Elastic的DiskBBQ

Qdrant在基准测试中表现优于Elastic的DiskBBQ,吞吐量提高了2倍,延迟降低了50%。在相同的召回率下,Qdrant使用更少的CPU和内存资源,显示出更高的效率。Elastic的测试方法未能充分利用Qdrant的特性,导致结果偏差。Qdrant的两阶段检索和异步评分技术显著提升了性能。

Qdrant在吞吐量上提高了2倍,延迟降低了50%,计算资源减少到1/3,超越了Elastic的DiskBBQ

Qdrant - Vector Database Qdrant - Vector Database · 2026-07-08T00:00:00Z

Tensor Core 是专用的矩阵计算单元,利用 MMA 指令实现高效的矩阵乘加运算。FP16 Tensor Core 的吞吐量可达 72.8 TFLOP/s,显著高于 FP32 的 16 TFLOP/s。使用 Tensor Core 时,数据传输速度常成为瓶颈,因此需要优化数据布局和访存策略。CUDA 的 wmma API 简化了 Tensor Core 的使用,而高性能库如 CUTLASS 则能更精细地控制数据布局。

【GPU 算子工程】Tensor Core 与 MMA:wmma、mma.sync 与数据布局

土法炼钢兴趣小组的博客 土法炼钢兴趣小组的博客 · 2026-06-28T00:00:00Z
GLM 5.2 Fast现已通过Wafer在AI Gateway上线

GLM 5.2 Fast现已在AI Gateway上线,提供比其他服务商高2倍的吞吐量,适用于小、大上下文场景。使用时需在AI SDK中设置模型为zai/glm-5.2-fast。AI Gateway提供统一API,支持用量跟踪、成本管理及性能优化,无平台费用。

GLM 5.2 Fast现已通过Wafer在AI Gateway上线

Vercel News Vercel News · 2026-06-24T00:00:00Z
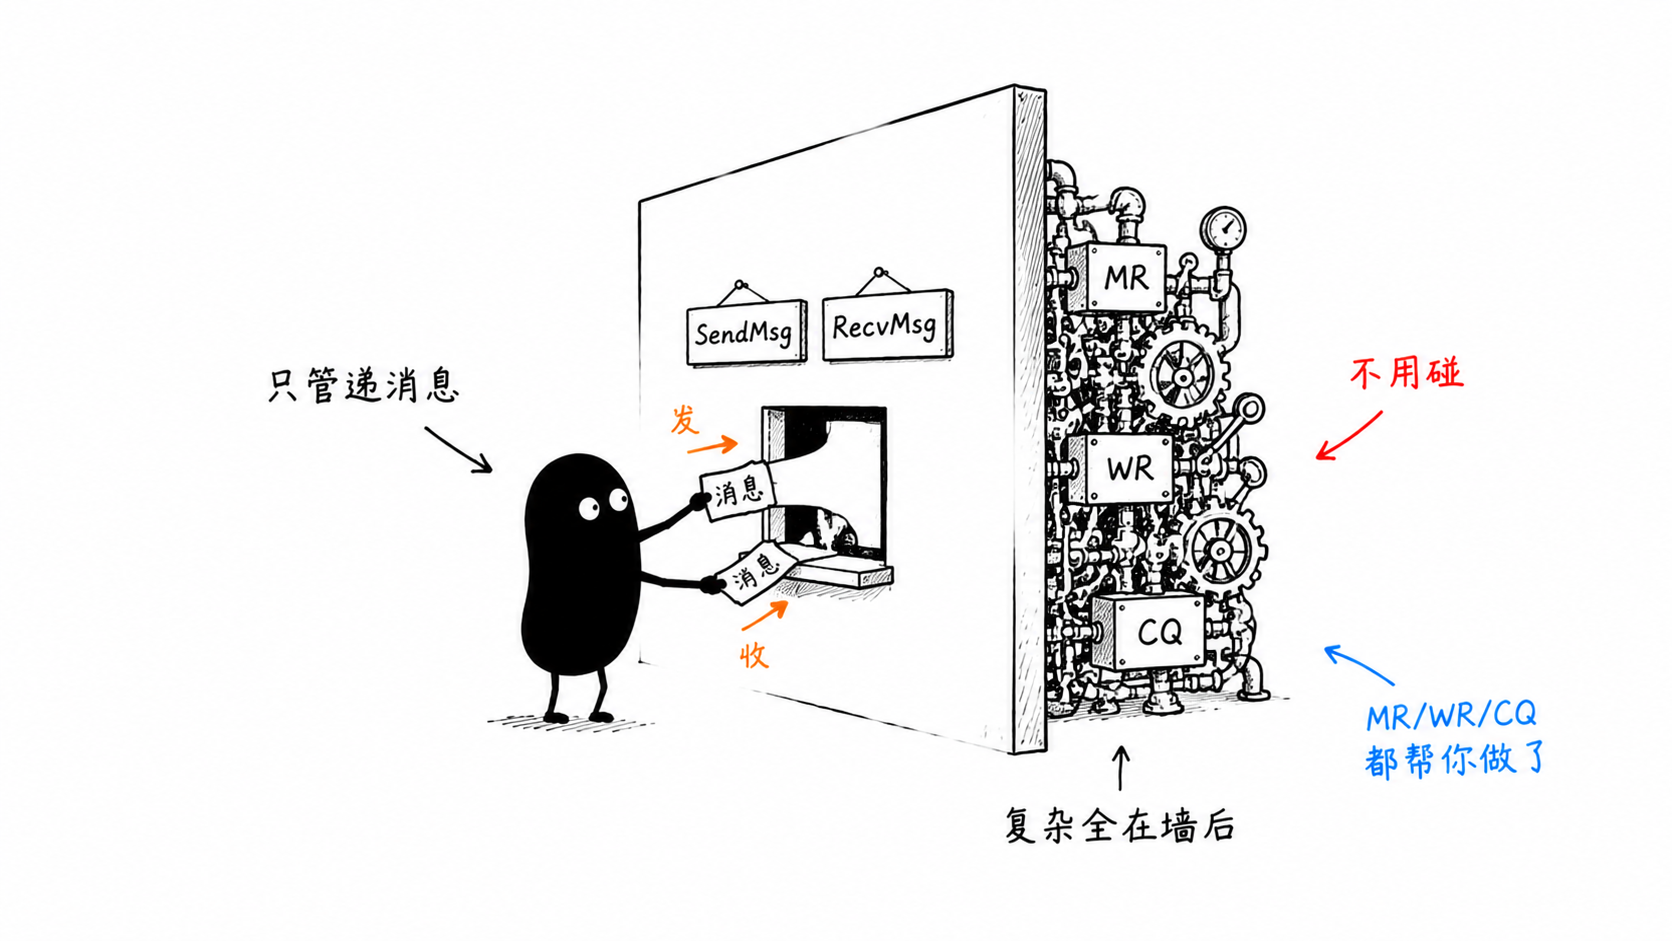
傻瓜式RDMA高性能网络开发:从零跑到 400 Gb每秒

本文介绍了gordma,一个用Go语言封装的RDMA网络库,旨在简化高性能网络编程。RDMA技术通过直接内存访问实现低延迟和高吞吐量,适用于AI训练和金融交易等场景。gordma提供易用的API,支持不同性能需求,用户可选择简单的net风格接口或底层API以获得更高性能。实测数据显示,gordma在400G网络环境下的吞吐量可达392 Gb/s,展示了其强大的性能和灵活性。

傻瓜式RDMA高性能网络开发:从零跑到 400 Gb每秒

鸟窝 鸟窝 · 2026-06-16T20:00:24Z
实测小米最快1T大模型:吞吐量每秒1000+ Tokens,Vibe Coding七秒交付

小米推出了MiMo-V2.5-Pro-UltraSpeed模型,具备1T参数和1000+ TPS的推理速度,突破了GPU的性能限制。该模型在全栈开发任务中表现优异,能够快速生成高质量的复杂应用,推动了大模型的商业化进程。

实测小米最快1T大模型:吞吐量每秒1000+ Tokens,Vibe Coding七秒交付

量子位 量子位 · 2026-06-11T01:18:16Z
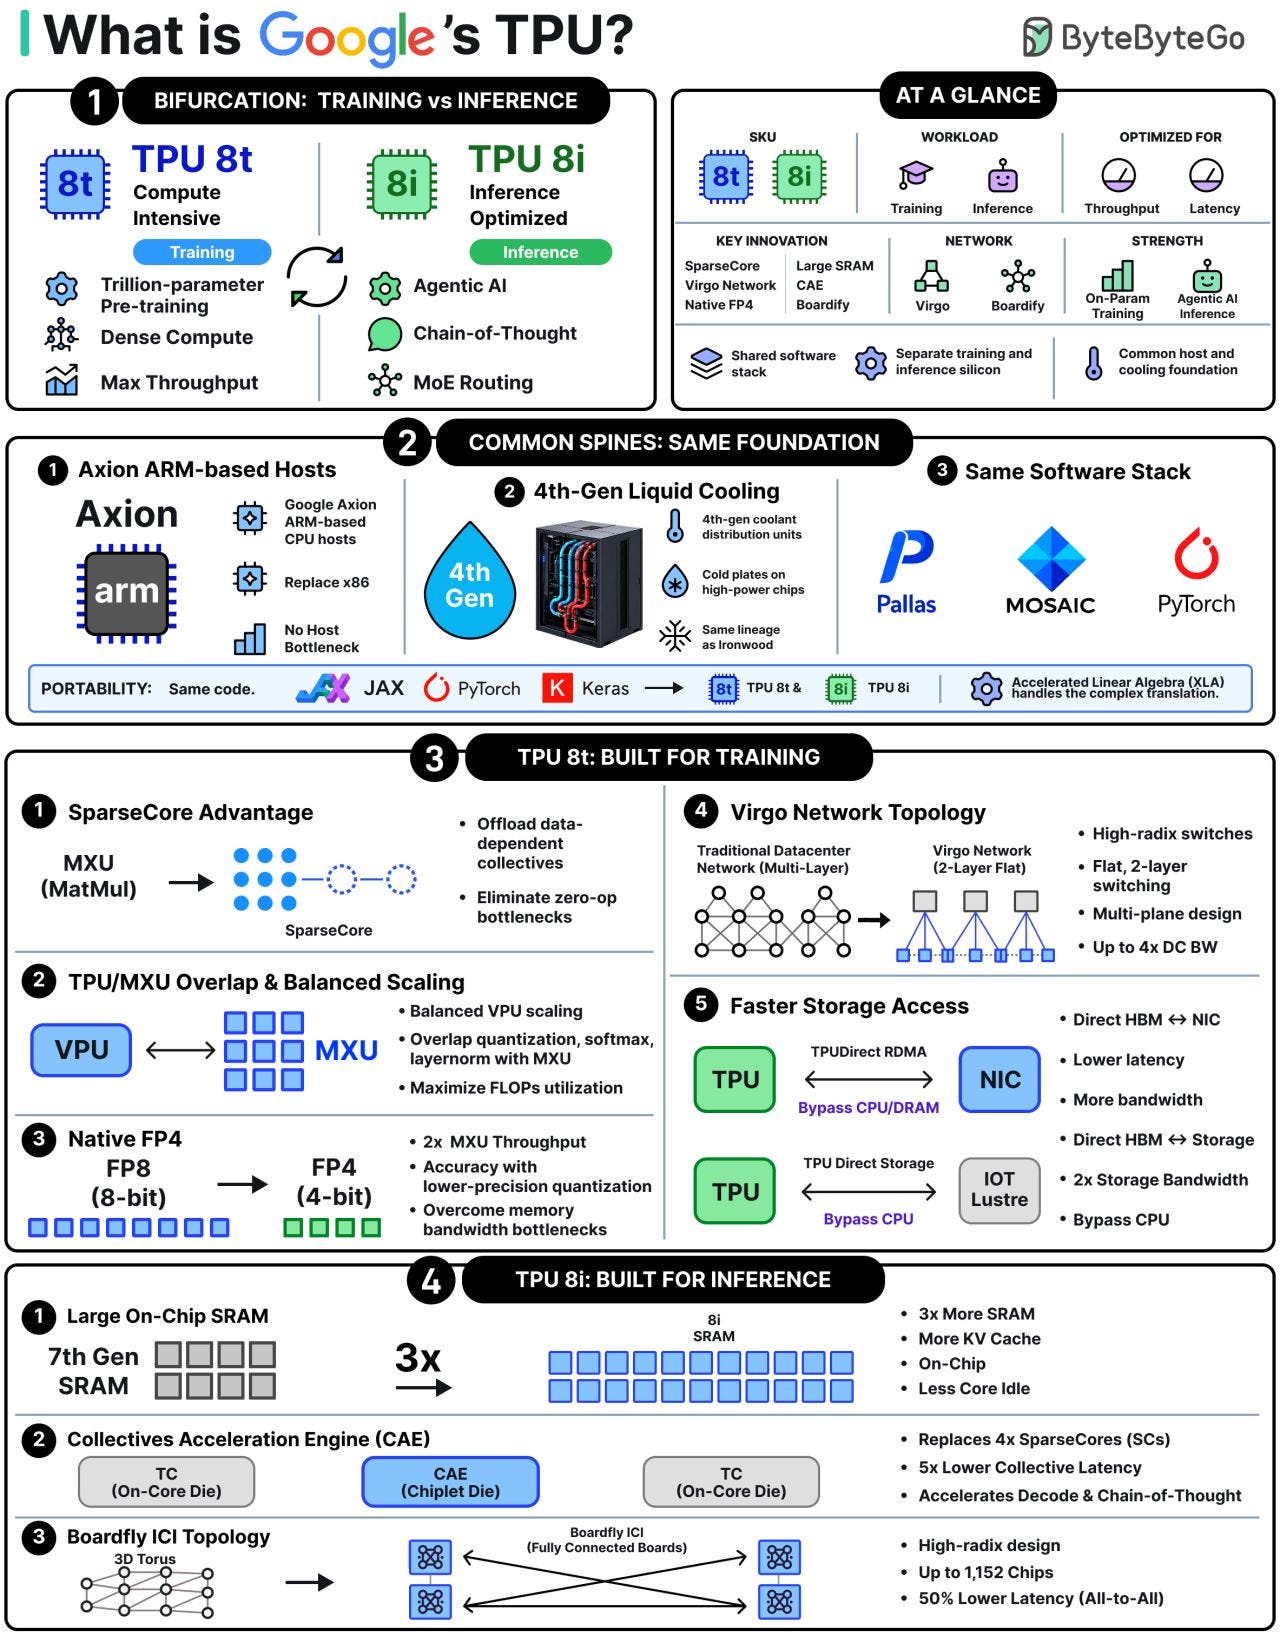
EP217:延迟与吞吐量与带宽

文章讨论了延迟、吞吐量和带宽的区别。延迟是数据包从发送者到接收者的时间,吞吐量是每秒成功传输的数据量,而带宽是连接的最大容量。低延迟不一定意味着高吞吐量,三者各自解决不同的问题。此外,文章介绍了谷歌的TPU芯片,专为深度学习设计,具有不同的训练和推理模式。

EP217:延迟与吞吐量与带宽

ByteByteGo Newsletter ByteByteGo Newsletter · 2026-06-06T15:30:33Z
vLLM的Rust前端PR了,预处理吞吐量直接翻了5倍!

在新加坡的 PyTorch 会议上,Bugen Zhao 介绍了 vLLM 团队用 Rust 重写 Python 前端的工作,以解决高并发下的性能瓶颈。Rust 前端的吞吐量提升约 5.16 倍,CPU 占用降低,长尾延迟收敛,用户无需额外操作,Rust 二进制文件已打包进 Python Wheel,支持主要 API。

vLLM的Rust前端PR了,预处理吞吐量直接翻了5倍!

迷途小书童 迷途小书童 · 2026-05-31T10:37:43Z
DEKRA德凯授予联想消费笔记本Wi-Fi吞吐量3D场型暨路由环境自适应专项认证

DEKRA德凯近日为联想消费笔记本授予Wi-Fi吞吐量3D场型暨路由环境自适应认证。该认证基于联想的Smart Antenna技术,首次将3D T-PUT均匀性测试与动态路由环境模拟纳入认证体系,测试结果显示联想笔记本在三维均匀性和动态适配方面表现优异,核心性能指标显著高于行业标准。

DEKRA德凯授予联想消费笔记本Wi-Fi吞吐量3D场型暨路由环境自适应专项认证

全球TMT-美通国际 全球TMT-美通国际 · 2026-05-27T06:46:39Z
  • <<
  • <
  • 1 (current)
  • 2
  • 3
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。

1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
友情链接: MOGE.AI 九胧科技 1tok 菜鸟教程 Remio.AI DeekSeek连连 53AI 神龙海外代理IP IPIPGO全球代理IP 东波哥的博客 匡优考试在线考试系统 开源服务指南 蓝莺IM Solo 独立开发者社区 AI酷站导航 极客Fun 我爱水煮鱼 周报生成器 He3.app 简单简历 白鲸出海 T沙龙 职友集 TechParty 蟒周刊 Best AI Music Generator 模力方舟 Gitee AI

小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码