

小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
DeepSeek V4.1 Flash 现已上线 AI Gateway

DeepSeek V4.1 Flash 已上线 AI Gateway,支持原生图像理解,可在同一请求中处理文本和图片,用于解读截图、图表等。模型上下文窗口达100万token,最多输出38.4万token,支持推理、工具调用和提示缓存。新架构分离输入与输出组件,降低各阶段计算量。AI Gateway 提供统一API,无加价和平台费。

DeepSeek V4.1 Flash 现已上线 AI Gateway

Vercel News Vercel News · 2026-09-09T00:00:00Z
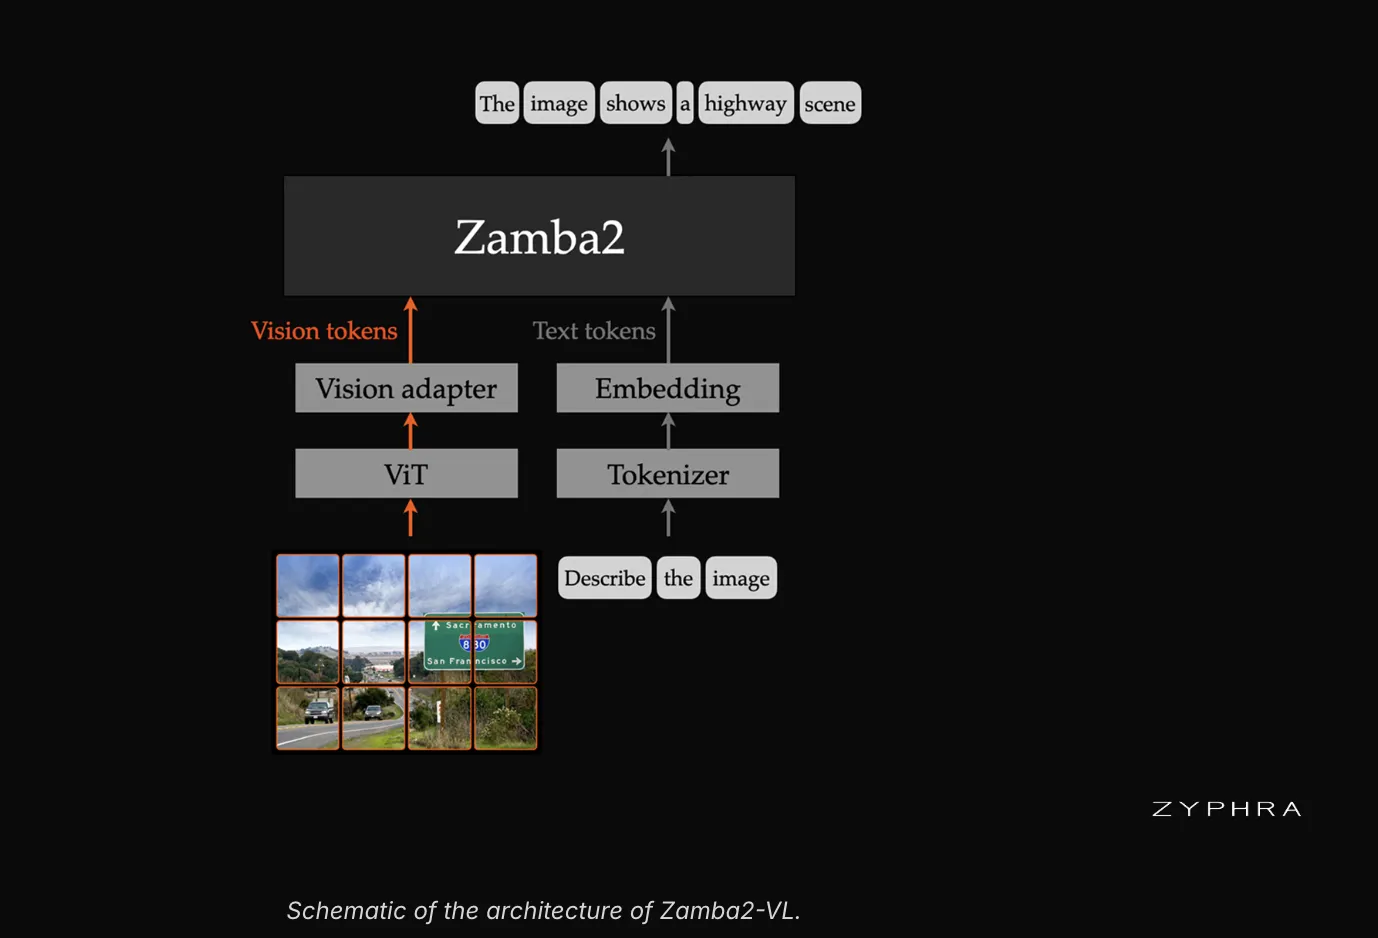
Zyphra发布Zamba2-VL:混合Mamba2-Transformer视觉语言模型

Zyphra发布了Zamba2-VL系列开放视觉语言模型,包含12亿、27亿和70亿参数。该模型采用混合SSM-Transformer架构,支持图像与文本的理解与关联,推理速度快,适用于文档提取和库存盘点等场景。尽管在知识推理方面表现不如大型模型,但在视觉计数和文档理解上具有优势。模型权重和推理代码已公开。

Zyphra发布Zamba2-VL:混合Mamba2-Transformer视觉语言模型

实时互动网 实时互动网 · 2026-06-15T02:50:06Z
字节开源 Lance,3B 模型包揽理解/生成/编辑;新加坡国立大学提出 ViMU 数据集:涵盖 588 个视频与无提示问答

Lance是字节跳动于2026年发布的多模态模型,具备图像与视频的理解、生成和编辑能力。该模型采用双流混合专家架构,提升了文本、图像和视频任务的生成质量和语义理解能力。

字节开源 Lance,3B 模型包揽理解/生成/编辑;新加坡国立大学提出 ViMU 数据集:涵盖 588 个视频与无提示问答

HyperAI超神经 HyperAI超神经 · 2026-05-29T06:13:08Z

现代人工智能系统越来越依赖多模态数据,尤其是图像理解。MySQL HeatWave GenAI使得在SQL工作流中直接实现图像理解成为可能,通过生成文本描述并转化为向量嵌入,提供可解释的语义检索。这种方法降低了基础设施成本,简化了AI系统的构建,使其更易于理解和管理。

使用MySQL HeatWave GenAI构建AI视觉搜索引擎

Planet MySQL Planet MySQL · 2026-05-14T16:54:52Z
京东正式开源JoyAI-Image-Edit:AI图像编辑从“平面修图“迈向“空间重塑“

京东开源的多模态基础模型JoyAI-Image-Edit支持文生图、图像理解和指令引导的图像编辑,具备像素级精细化编辑和真实立体感,解决了理解与生成之间的空间断层。该模型在生成与理解的深度融合、空间编辑的突破和多场景高性能表现方面具有技术优势,广泛应用于电商、具身智能和3D重建等领域。

京东正式开源JoyAI-Image-Edit:AI图像编辑从“平面修图“迈向“空间重塑“

京东科技开发者 京东科技开发者 · 2026-04-08T02:45:34Z
黑马图像模型被Nano Banana技术负责人点赞!15人华人小队,DDIM之父&CVPR最佳论文作者带队

Luma AI推出的Uni-1模型在图像理解与生成方面表现优异,超越谷歌的Nano Banana Pro和GPT Image 1.5。该模型由不到15人的华人团队开发,具备角色姿态迁移和草稿转漫画等功能,展现出强大的竞争力,预示着视觉AI的未来发展方向。

黑马图像模型被Nano Banana技术负责人点赞!15人华人小队,DDIM之父&CVPR最佳论文作者带队

量子位 量子位 · 2026-03-06T14:39:17Z

Gemini 3 Flash的Agentic Vision通过将图像理解转变为主动过程,提升了视觉任务的处理能力。它结合视觉推理与代码执行,允许模型逐步分析和操作图像,显著提高准确性,并支持图像缩放、注释和可视化计算,增强推理能力,未来将扩展更多功能。

在Gemini 3 Flash中引入Agentic Vision

The Keyword The Keyword · 2026-01-27T19:00:00Z

谷歌搜索的AI模式更新使视觉探索更加自然,用户可通过对话式提问获取丰富的视觉结果,帮助明确模糊想法。在购物时,用户只需描述商品,AI会智能推荐相关选项,简化购物体验。新技术结合图像理解和多模态能力,深入分析图像内容,提供精准结果。本周在美国推出。

AI模式现在可以帮助您进行视觉搜索和探索

The Keyword The Keyword · 2025-09-30T13:00:00Z

清华大学与面壁智能推出的MiniCPM-V 4.0模型,参数减少至4.1B,提升了移动端图像理解能力,并支持iOS应用,推动了端侧部署的广泛应用。

性能赶超GPT-4.1-mini!MiniCPM-V 4.0达端侧图像模型新高度;HelpSteer3让AI回应更接近人类思维

HyperAI超神经 HyperAI超神经 · 2025-08-19T07:36:29Z

清华大学与面壁智能推出的MiniCPM-V 4.0端侧大模型,具备强大的图像理解能力,参数减少至4.1B,适用于移动设备,提升用户体验,推动AI在边缘设备的应用。

性能赶超GPT-4.1-mini!MiniCPM-V 4.0达端侧图像模型新高度;HelpSteer3让AI回应更接近人类思维

HyperAI超神经 HyperAI超神经 · 2025-08-18T03:04:12Z

昆仑万维推出的开源多模态统一模型Skywork UniPic,参数量为1.5B,具备图像理解、生成和编辑能力,性能接近大型模型,能够在消费级显卡上流畅运行,支持多种应用场景,推动AI技术普及与发展。

1.5B参数撬动“吉卜力级”全能体验,国产开源之光多模态统一模型,来了

量子位 量子位 · 2025-07-30T04:41:10Z
苹果分享iOS 26即将推出的人工智能基础模型细节

苹果在最新技术报告中介绍了iOS 26的新智能基础模型,包括一个3B参数的高效模型和一个大型服务器模型。3B模型在设备上运行,强调低延迟和资源节省;大型模型则注重高准确性和可扩展性。苹果还强调负责任的人工智能原则,确保安全性和有效性。

苹果分享iOS 26即将推出的人工智能基础模型细节

InfoQ InfoQ · 2025-07-28T21:00:00Z
谷歌发布MedGemma:用于医疗文本和图像分析的开源AI模型

谷歌推出了MedGemma,包含两个开源生成AI模型,分别为多模态的MedGemma 4B和专注于医疗文本的27B。它们可用于放射报告生成和临床总结等任务,但谷歌强调需进一步验证,不能直接用于临床。

谷歌发布MedGemma:用于医疗文本和图像分析的开源AI模型

InfoQ InfoQ · 2025-05-30T10:50:00Z

字节推出的Seed1.5-VL多模态推理模型在60项基准测试中获得38项第一,表现优异。该模型结合532M视觉编码器和200亿参数,擅长复杂推理、OCR和图像理解。通过创新的训练方法和架构设计,模型在多模态数据处理上表现突出,但仍存在局限性。

拿下38项第一!字节发布Seed1.5-VL多模态推理模型

量子位 量子位 · 2025-05-14T06:20:16Z

本研究提出通过扩散变换器提升图像理解与生成模型的训练效率和生成质量。采用顺序预训练策略,开发的BLIP3-o模型在基准测试中表现优异,并开放源代码和数据集以促进研究。

BLIP3-o:一种完全开放的统一多模态模型—架构、训练与数据集

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-05-14T00:00:00Z
如何在本地安装Meta Perception LM 8B?

Perception-LM-8B是Meta FAIR团队开发的多模态模型,具备深度理解图像和视频的能力。它结合了轻量级语言解码器和高效视觉编码器,支持视觉问答和视频推理等任务,使用开放数据训练,确保透明性。该模型在图像和视频理解方面表现优异,适合研究和应用。

如何在本地安装Meta Perception LM 8B?

DEV Community DEV Community · 2025-05-13T08:35:09Z

本研究提出Nexus-Gen模型,通过双阶段对齐训练,将语言推理与图像生成相结合,提升了图像理解与生成的质量,解决了现有多模态模型在特定领域的不足。

Nexus-Gen: A Unified Model for Image Understanding, Generation, and Editing

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-04-30T00:00:00Z

本研究提出了一种名为VCM的自监督视觉概念建模框架,旨在提高大型视觉-语言模型的效率。该方法通过隐式对比学习和视觉-语言微调,显著降低计算成本,同时在图像理解任务中保持优良性能。

Vision Concept Modeling Based on Implicit Contrastive Learning: Vision-Language Instruction Fine-Tuning

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-04-28T00:00:00Z

ChatGPT通过分析照片,利用车牌、植物和建筑细节推测地理位置,准确度达到200-300公里,最终锁定在加州一个小村庄,展示了其在图像理解上的潜力。

o3猜照片位置深度思考6分48秒,范围精确到“这么近那么美”

量子位 量子位 · 2025-04-27T06:12:50Z
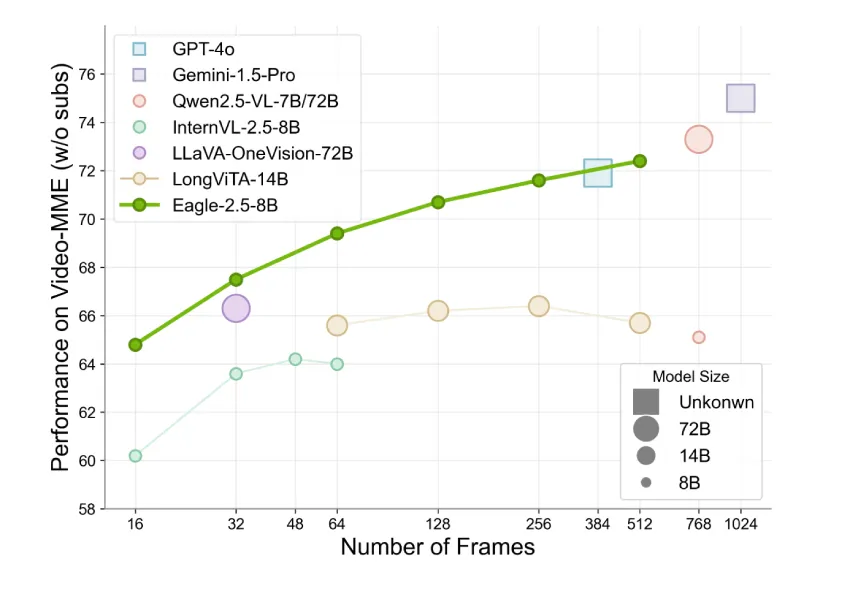
NVIDIA AI 推出通用视觉语言模型 Eagle 2.5,仅用 8B 参数就能在视频任务中与 GPT-4o 匹配

Eagle 2.5 是 NVIDIA 推出的视觉语言模型,专为处理长上下文的多模态数据而设计。它通过信息优先采样和渐进式后训练策略,显著提升了视频和图像理解任务的性能,尤其在高分辨率输入下表现突出。该模型强调上下文完整性和数据集多样性,是多模态理解的重要工具。

NVIDIA AI 推出通用视觉语言模型 Eagle 2.5,仅用 8B 参数就能在视频任务中与 GPT-4o 匹配

实时互动网 实时互动网 · 2025-04-23T03:09:24Z
  • <<
  • <
  • 1 (current)
  • 2
  • 3
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。

1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码