搜索效果差时,不应只升级重排序模型。大规模重排序成本高、延迟大,且候选池本身没有好结果时重排序也无能为力。更优方案是将检索设计为多阶段漏斗:先用低成本词法、向量或混合检索生成大量候选,再逐步收窄,最后才用机器学习重排序。该思路同样适用于RAG,需权衡召回率、相关性、延迟与成本。
本文介绍了构建检索增强生成(RAG)系统的高级技术,包括查询扩展与重构、混合检索(稠密与稀疏方法)以及多阶段检索与重排序。这些技术通过生成多种查询变体、结合稠密与稀疏向量的优点,以及初步快速检索与后续精确重排序,显著提升了RAG系统的性能和应用效果。
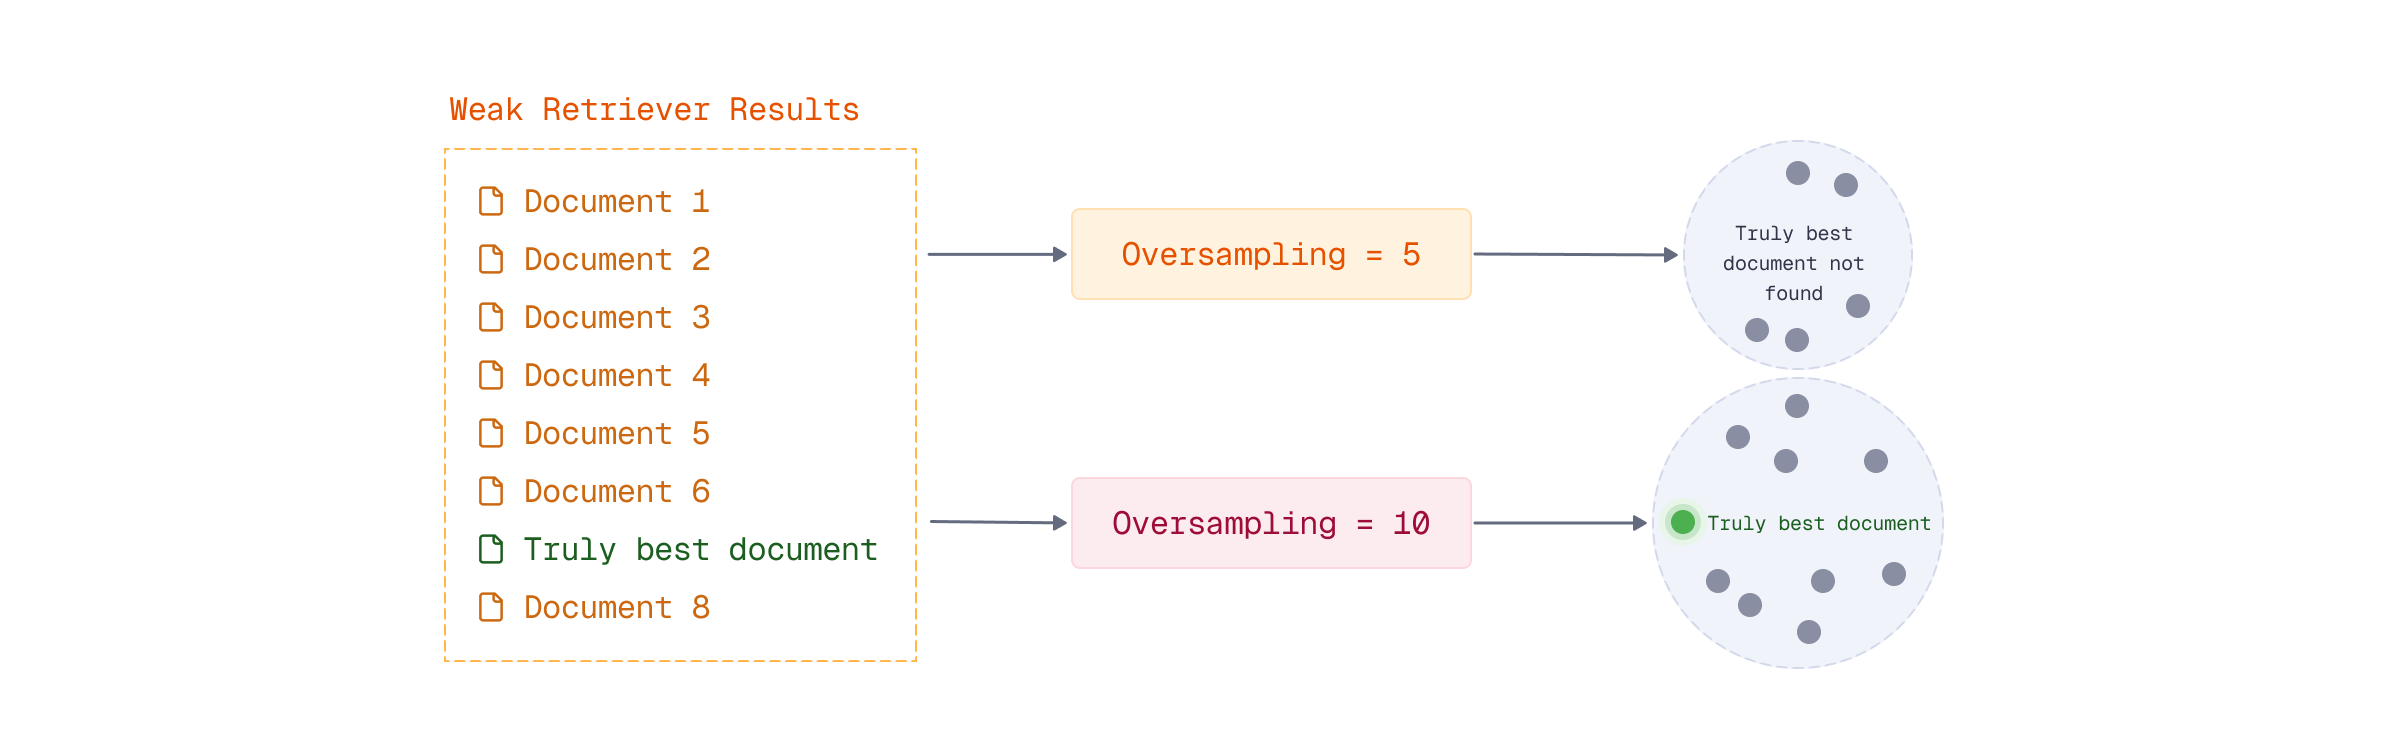
多阶段检索结合了快速单向量模型和高质量多向量模型的优点,通过预取阶段获取更多候选文档,并在重排序阶段使用ColBERT提高检索质量。过采样确保候选集足够大,以提高找到最佳文档的机会。Qdrant的通用查询API简化了多阶段检索的实现,适用于大规模文档集合。
完成下面两步后,将自动完成登录并继续当前操作。