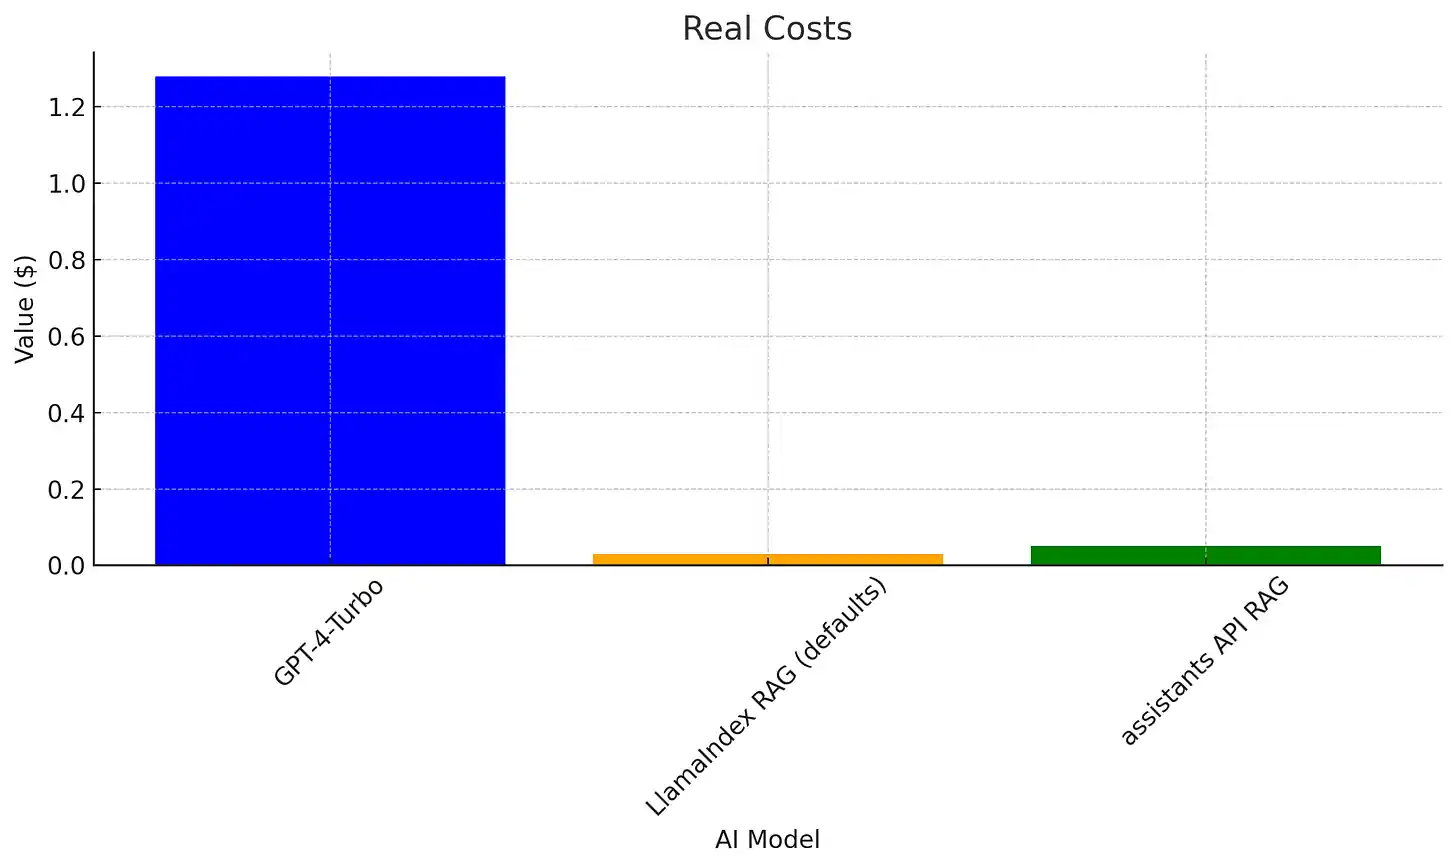
文章对比了RAG与GPT-4上下文窗口:在“大海捞针”测试中,RAG准确性近乎完美,成本仅为上下文填充的约4%;处理128k文档时延迟约12.9秒,优于GPT-4-Turbo的21.6秒。LlamaIndex在超过10万token后性能下降。结论是处理文本时,采用先进的RAG比单纯扩大上下文窗口更关键。
完成下面两步后,将自动完成登录并继续当前操作。