

RAG 与 GPT-4 的上下文窗口比较:准确性、成本和响应速度 [译]
内容提要
文章对比了RAG与GPT-4上下文窗口:在“大海捞针”测试中,RAG准确性近乎完美,成本仅为上下文填充的约4%;处理128k文档时延迟约12.9秒,优于GPT-4-Turbo的21.6秒。LlamaIndex在超过10万token后性能下降。结论是处理文本时,采用先进的RAG比单纯扩大上下文窗口更关键。
延伸解读
RAG 在准确性上的优势与局限
文章测试显示,结合 GPT-4 的 RAG 在“大海捞针”式搜索查询中准确性近乎完美,而单纯填充上下文窗口会引入无关信息,不仅成本高,还可能降低性能。但作者也指出,这种优势仅限于搜索类查询;对于少样本学习等需要大范围上下文的场景,结果可能不同。因此,RAG 并非万能,需根据任务类型选择。
成本对比:RAG 的固定成本与规模效应
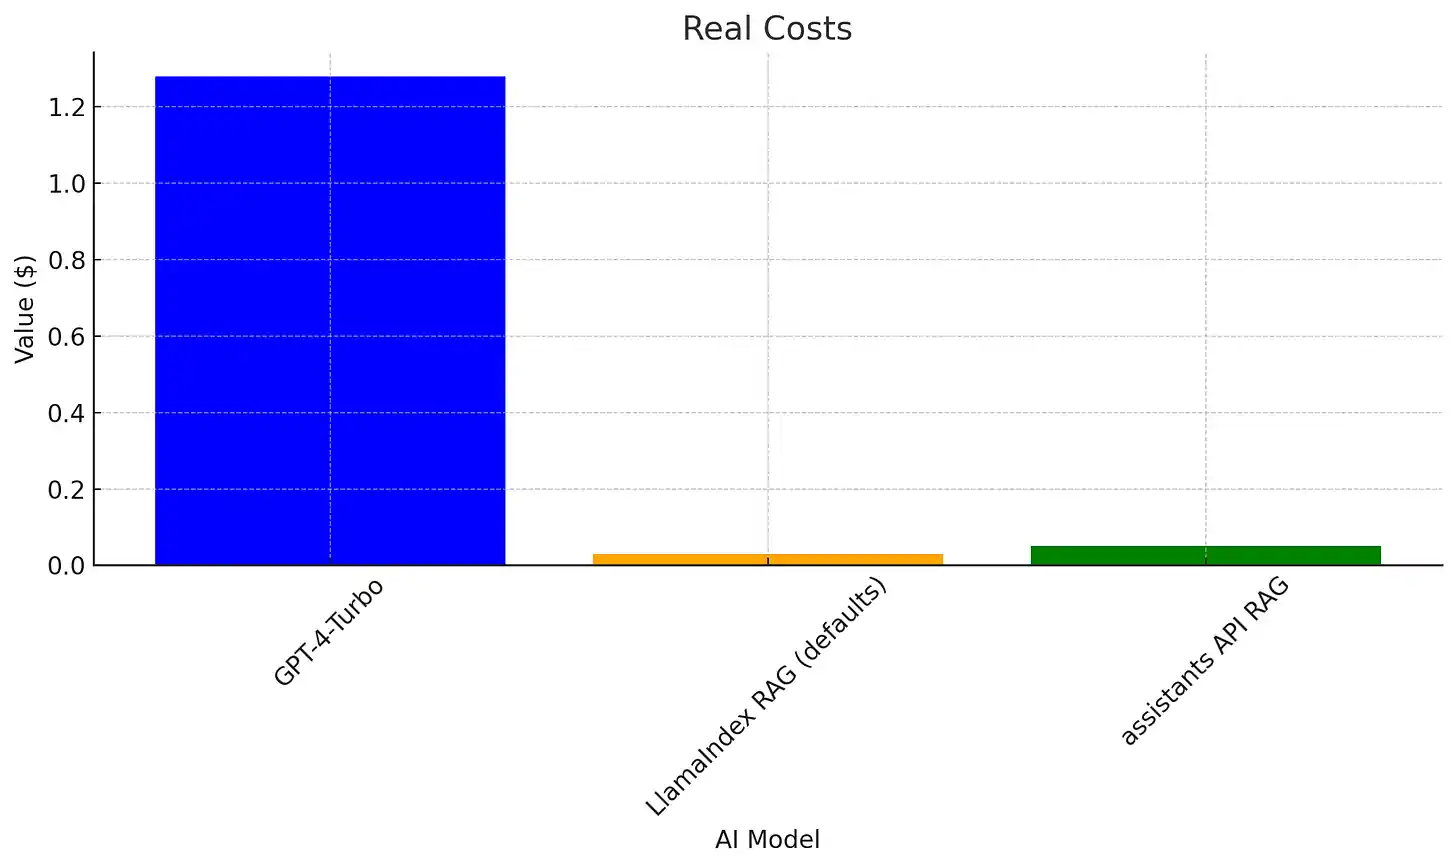
RAG 除了每 Token 的索引成本,还有固定的 LLM 推理成本。以 128k 上下文为例,RAG 总成本约为每千 Token 0.0004 美元,仅为 GPT-4-Turbo 的 4%。作者估算,只有当上下文窗口小于 5k 时,上下文填充才更划算。这意味着对于大多数长文档场景,RAG 在成本上具有显著优势。
延迟表现与优化空间
处理 128k Token 文档时,LlamaIndex RAG 平均延迟 12.9 秒,低于 GPT-4-Turbo 的 21.6 秒和助手 API RAG 的 24.8 秒。作者建议通过“乐观上传文档”来减少用户感知延迟,因为 RAG 索引成本很低。此外,嵌入计算可并行化,未来基础设施改进有望进一步降低延迟。
LlamaIndex 的性能拐点与开源前景
测试发现 LlamaIndex 在上下文超过约 100k Token 后性能明显下降,作者怀疑是检索过程未能有效找到关键信息,但指出不同分块和检索设置可能影响结果。尽管如此,作者对 LlamaIndex 和开源 RAG 技术持乐观态度,认为该领域仍处于容易取得进展的阶段,简化操作框架尤为关键。
Q&A
RAG和GPT-4上下文窗口在准确性上哪个更好?
在“大海捞针”测试中,RAG(结合GPT-4)的准确性近乎完美,而单纯填充上下文窗口的表现较差。这是因为无关信息会干扰模型性能,RAG通过检索只输入相关片段,从而提升准确性。
使用RAG的成本比直接填充GPT-4上下文窗口低多少?
以128k上下文为例,RAG的平均总成本约为每1000 Token $0.0004,仅占GPT-4-Turbo上下文填充成本的约4%。LlamaIndex RAG成本更低,为每1000 Token $0.00028。
处理128k文档时,RAG和GPT-4-Turbo的响应速度谁更快?
LlamaIndex RAG的平均延迟最短,为12.9秒;GPT-4-Turbo平均延迟为21.6秒(范围7-36秒);OpenAI助手API RAG的检索延迟为24.8秒。因此RAG在延迟上表现更优。
LlamaIndex在RAG测试中有什么性能限制?
LlamaIndex在上下文长度超过约100k token后性能明显下降,可能是检索过程未能有效找到关键信息。但该结果基于默认设置,不同分块和检索设置可能影响表现。
在什么情况下使用上下文填充比RAG更划算?
从成本角度考虑,只有当上下文窗口小于5k token时,使用上下文填充才比RAG更划算。超过此长度,RAG的固定推理成本被摊薄,总体成本更低。
RAG技术主要适用于哪些类型的查询?
RAG在搜索类型的查询中表现极佳,准确性近乎完美。但对于涉及较大上下文范围的其他场景(如少样本学习),表现可能不同,需要进一步评估。
