OpenClaw 引入决策模型机制,通过 Plugin SDK 共享 API,让 AI 智能体在工具选择、上下文压缩等高频场景快速判断,无需每个插件单独集成模型。决策模型接收证据与标准,直接返回结构化答案,避免大模型反复调用。该配置完全可选,不启用不影响原有功能,旨在降低延迟与成本,但准确率略有下降。
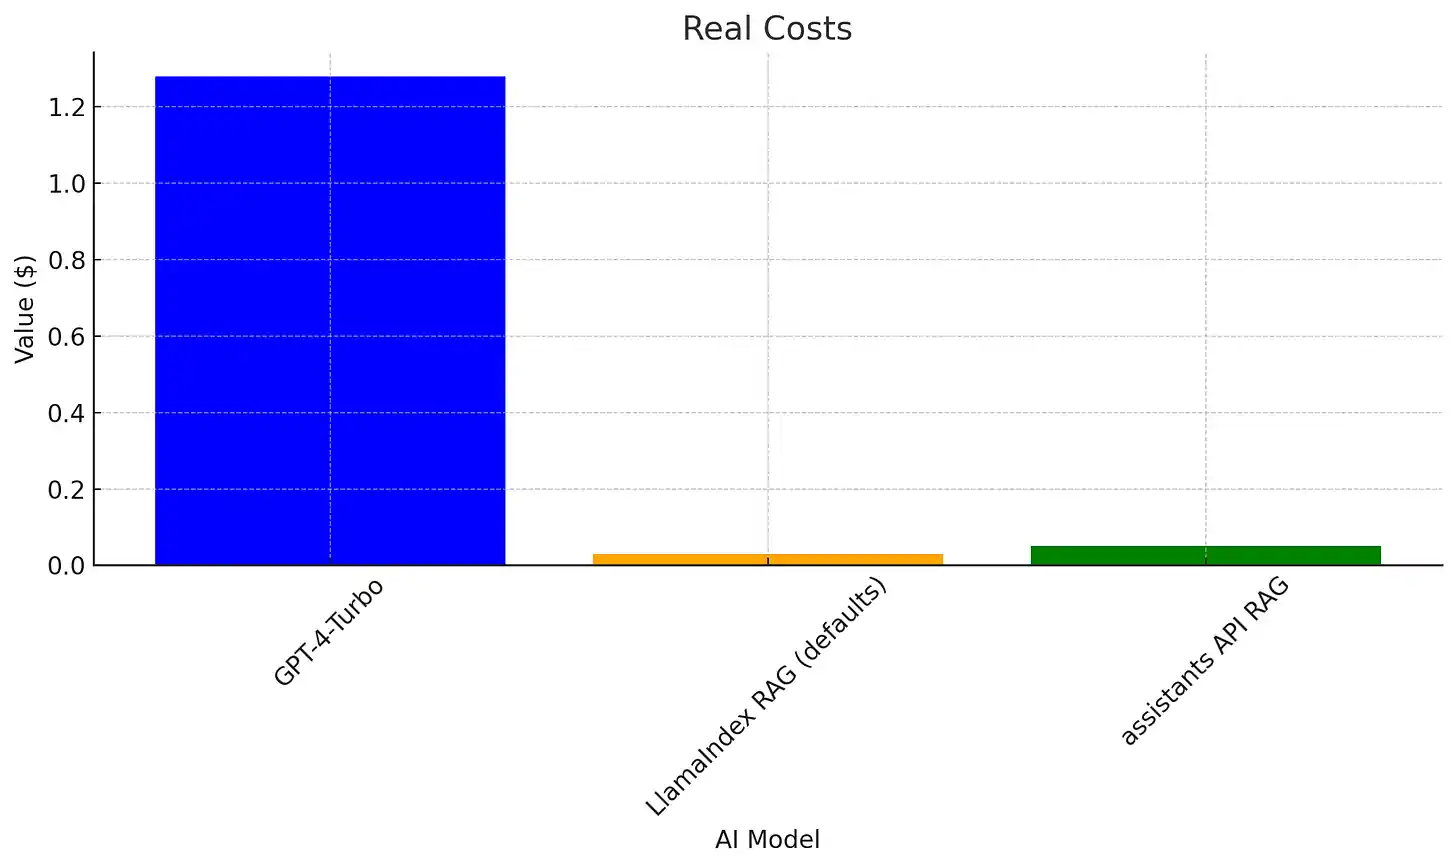
文章对比了RAG与GPT-4上下文窗口:在“大海捞针”测试中,RAG准确性近乎完美,成本仅为上下文填充的约4%;处理128k文档时延迟约12.9秒,优于GPT-4-Turbo的21.6秒。LlamaIndex在超过10万token后性能下降。结论是处理文本时,采用先进的RAG比单纯扩大上下文窗口更关键。
完成下面两步后,将自动完成登录并继续当前操作。