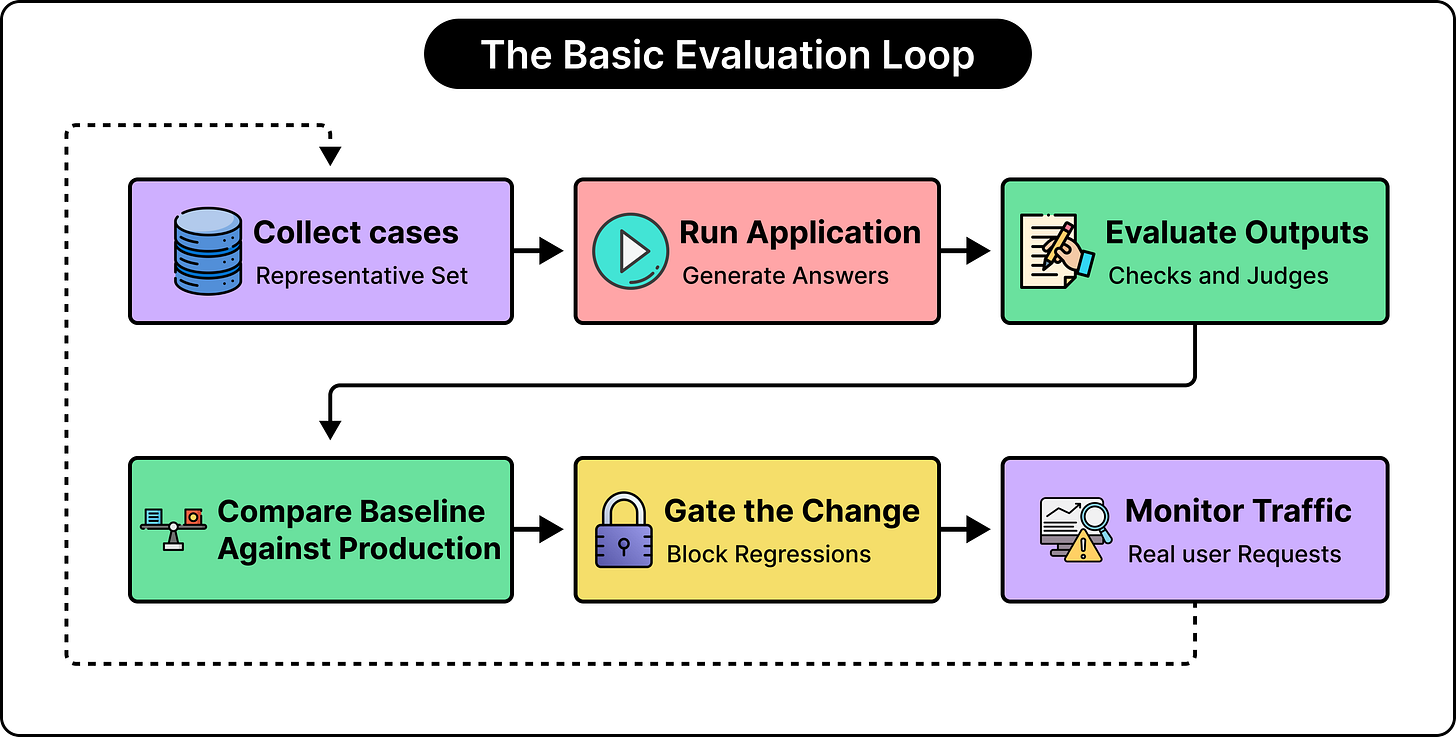
大语言模型评估需多层体系:黄金数据集用于可重复测试,自动指标快速检查客观属性,LLM评委按标准评估相关性、完整性与事实依据,人工审核校准评委并处理高风险案例,生产监控发现遗漏问题。目标是确保应用在关键场景中持续准确、安全、可靠、快速且成本可控。
GitHub开发者倡导总监Cassidy Williams探讨AI编码成本优化,指出缩短输出可能更贵,GitHub Copilot通过减少完整编码任务中的浪费来提升效率。另有教程教初学者用Copilot自动化处理Dependabot拉取请求分类,以及生产前评估大语言模型的经验,用于实际秘密扫描。
该文综述大语言模型评估研究,指出LLM作评估器存在约40%认知偏差,机器偏好与人类不一致;现有基准在心理健康、法律、多主体决策等领域有局限,GPT-4表现突出但提升空间大。研究呼吁转向元推理等新范式,以更准确评估LLM认知能力。
本文综述大语言模型评估摘要事实一致性的研究。TreatFact数据集表明现有方法和LLM评估器均难以捕捉临床摘要的不一致。研究提出Facet评估、GPTScore等方法,发现指令微调比模型规模更关键,适当提示可使LLM无需训练超越基线,但LLM仍存在将不一致摘要误判为高分的风险。
本文综述利用大语言模型评估自然语言生成质量的方法,梳理现有指标分类并比较其优劣与局限。研究指出,人类与LLM评判者均存在偏见、易受扰动,评估可靠性存疑;LLM在多语言和事实一致性评估上也有偏差。文章呼吁开发更稳健、公平的评估系统,并探讨人机协作与未来方向。
该文综述大语言模型评估与数据问题:数据污染会显著抬高基准成绩,需更强评估方法;提出自监督评估框架监测模型行为;发现基准泄漏导致性能虚高;揭示LLM生成数据与人类数据存在差异;研究信息更新中的暴露偏差并改进;提出统一数据创建流程,合成数据在分布外评估更优;并探索自动审核LLM的方法。
该文汇总多项研究,提出评估大语言模型心理与能力的框架,包括用PsychoBench测试人格、人际、动机和情绪,用BOLT分析心理治疗对话行为,并采用协商游戏、自适应测试、多主体博弈等方法评估模型。结果显示GPT-4表现最强,Llama-2-70B最弱,能力差距达三倍。
该文综述大语言模型评估方法,指出基准泄漏会虚高结果、导致评估不可靠。研究涵盖法律、多语言、长文本等基准,提出知识能力、对齐、安全等评估维度,并强调需建立标准化、客观的统一评估体系,以推动负责任发展并降低风险。
综述150多个大语言模型评估,提出结合知识图谱与LLM语言能力的新型架构,兼顾语言复杂性与事实严谨性,并加强数据安全。研究涉及对话系统、对话理解评估、多轮对话增强、教育口语学习、医疗诊断评估及事实核查,发现LLM在事实一致性和复杂对话理解上仍有不足,需提升可信度与透明度。
本文综述大语言模型指令遵循能力的评估研究。FollowBench、FollowEval、IFEval、CoDI-Eval等基准从多级细粒度约束、多维度任务及可验证指令等角度测评,发现模型明显落后于人类,开源与闭源模型差距显著。指令追踪评分(IFS)可衡量遵循能力并作早停准则,模型训练早期即学会遵循指令,过度微调则致语义变化。研究还揭示模型易过拟合指令短语、难以真正理解指令,且对对抗性指令攻击防御不足。
完成下面两步后,将自动完成登录并继续当前操作。