


LLM作为评委:如何判断你的LLM是否健康
内容提要
大语言模型评估需多层体系:黄金数据集用于可重复测试,自动指标快速检查客观属性,LLM评委按标准评估相关性、完整性与事实依据,人工审核校准评委并处理高风险案例,生产监控发现遗漏问题。目标是确保应用在关键场景中持续准确、安全、可靠、快速且成本可控。
延伸解读
为什么传统测试不够用
传统软件测试依赖确定性:相同输入必须产生相同输出。但LLM基于概率生成,同一问题可能得到措辞不同但都正确的答案。此外,质量是多维且部分主观的,正确性还依赖上下文。因此,仅靠单元测试无法覆盖LLM应用的健康状况,需要结合黄金数据集、自动指标、LLM评委、人工审核和生产监控等多层评估。
LLM评委的常见方法与局限
LLM评委可用多种方式评估答案:点式评分(如1-5分)便于追踪趋势,但需明确定义每个分数;通过/失败分类适合部署门禁,但会掩盖细微变化;成对比较更稳定,但需注意位置偏差;错误识别能指出具体问题。评委虽灵活,但可能遗漏某些失败模式,需人工校准。
人工审核与校准的关键作用
人工审核是评估的最终参照,尤其当答案涉及法律、医疗、金融等专业领域时。但人工成本高、速度慢,因此最佳角色是校准:让专家对代表性样本评分,再与LLM评委结果对比,了解评委的同意率、漏检类型,并调整通过阈值。同时需测量评审者之间的一致性,避免将人类评分视为完美标准。
构建完整的评估栈
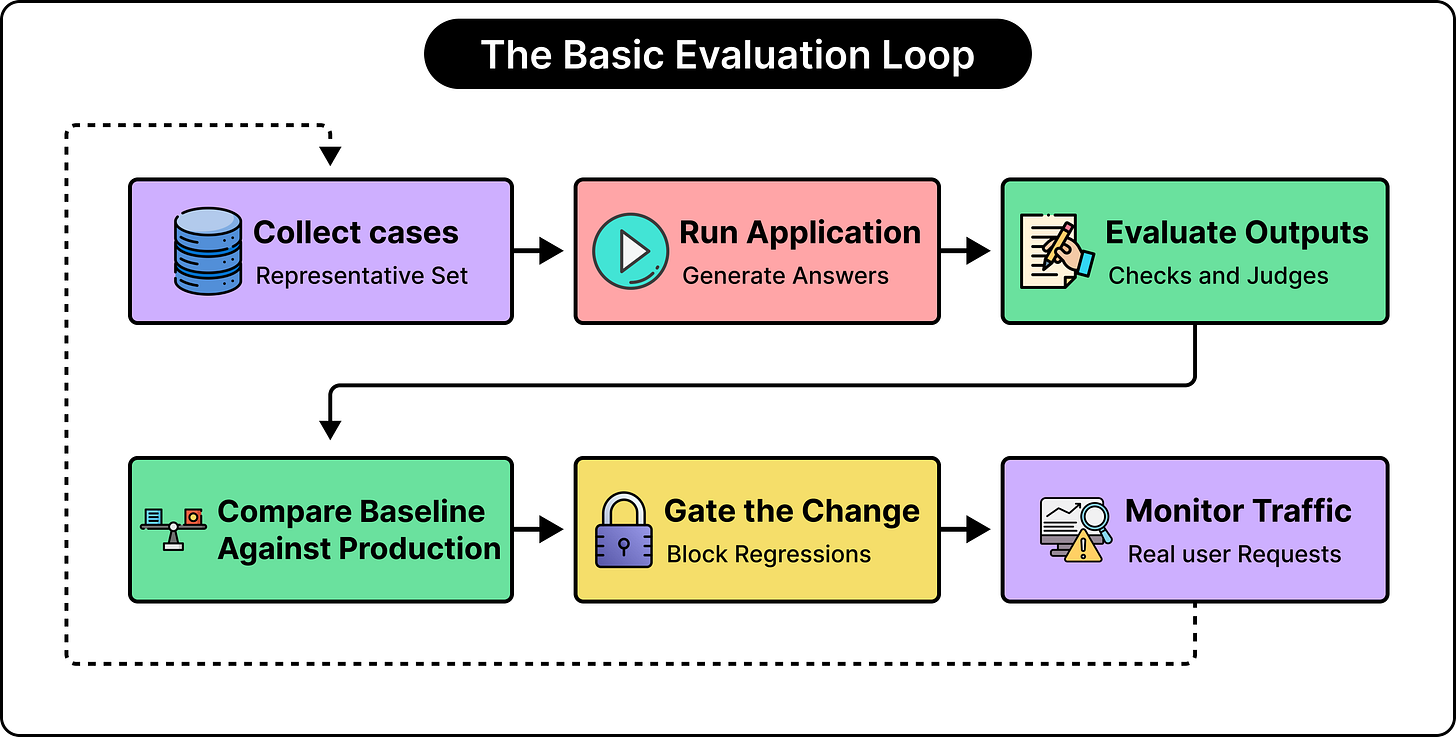
健康的LLM评估体系是互补的多层结构:底层是传统软件测试,验证确定性组件;黄金数据集提供可重复场景;自动检查验证JSON、字段等客观属性;LLM评委评估相关性、完整性等语义质量;人工审核校准评委并处理高风险案例;生产监控发现测试集遗漏的问题。各层协同,才能持续确保应用准确、安全、可靠、快速且成本可控。
Q&A
如何判断一个LLM应用是否健康?
一个LLM应用健康意味着它能在准确、安全、速度、可靠性和成本等方面持续产生有用的结果。需要从多个维度评估,例如是否理解用户问题、答案是否事实正确、是否完整、是否遵循语气和格式、是否避免编造政策、是否拒绝不当请求、响应时间是否可接受、成本是否可控。同时要区分模型本身和整个应用的健康,问题可能来自提示、检索、工具调用等。
为什么传统的软件测试方法不适用于LLM?
传统软件测试依赖确定性行为,给定输入期望固定输出。但LLM的输出是非确定性的,相同输入可能产生不同但都合理的回答;质量是多维且部分主观的,没有唯一正确答案;正确性还依赖上下文。因此,精确字符串比较会误判许多有效答案,需要新的评估方法。
什么是黄金数据集?它在LLM评估中起什么作用?
黄金数据集是精心策划的输入集合,包含对良好响应应包含内容的描述,类似于单元测试套件,但不要求精确匹配。它应覆盖常见请求、重要案例、模糊问题、信息缺失、恶意指令、边界情况等。黄金数据集提供可重复的测试场景,用于评估整个LLM应用,并应分为开发集和保留集,避免过拟合。
LLM作为评委(LLM-as-a-Judge)是什么?它如何工作?
LLM作为评委是指用一个语言模型评估另一个语言模型的输出。评委模型接收原始问题、提供的文档、助手答案、评估标准和可选参考答案,然后根据相关性、事实支持、完整性、清晰度和指令遵循等标准进行评分。它可以识别不同措辞的相同含义和细微失败,比精确匹配更灵活。
评委模型有哪些常见的评估方法?
常见的评估方法包括:1)基于分数的评分,如1-5分,便于跟踪但需明确评分标准;2)通过/失败分类,用于部署门槛,但隐藏细微变化;3)成对比较,比较两个答案哪个更好,通常更一致,但需注意位置偏差;4)错误识别,列出不支持的主张、未回答部分等,有助于开发阶段诊断。
人工评估在LLM评估中扮演什么角色?
人工评估由领域专家使用相同标准审查模型输出,用于创建和验证评分标准、审查高风险失败、评估新请求类型、检查自动评分是否反映真实有用性、调查评估者分歧以及定期审计评委漂移。由于人工昂贵且慢,通常用于校准评委模型,即人工评分代表性样本并与评委评分比较,以调整评委的阈值和一致性。
完整的LLM评估栈包含哪些层次?
完整的评估栈是互补的层次,包括:底层传统软件测试,验证确定性组件;黄金数据集提供可重复场景;自动化检查验证可靠属性如JSON格式、字段、延迟;LLM评委评估需要理解含义的质量如相关性、完整性、事实支持;人工审查校准评委并处理高风险案例;生产监控发现测试集遗漏的问题。这些层次共同构建对模型的信心。
