Sky Media与健力士合作,自10月10日起在Sky Sports英超转播中推出实时字幕和描述性音频解说,每赛季分别覆盖约210场和109场比赛,服务盲人、低视力及听障球迷。该服务经RNIB等测试反馈开发,已在Sky各平台及NOW上线。
谷歌Flow推出六款定制工具:Mondo Sónico生成同步音效,CaptionCast自动制作多语言字幕,ThumbnailForge生成社交缩略图,Surface实时生成建筑材质纹理,CollageMotion Pro自动制作动态拼贴,SwissFlow Studio将脚本转为瑞士风格动效。用户可复制、改编或自建工具。
作者因给视频加字幕需用昂贵软件或上传在线工具,便自建纯浏览器运行的“字幕工作室”:拖入MP4即可在时间轴分段写字、调样式并预览,导出无水印带字幕视频。它用WebCodecs逐帧解码编码,mp4box解析、mp4-muxer封装,音频尽量直转。全程本地处理,视频不上传,状态存IndexedDB,适合桌面Chrome或Edge。
作者因缺少顺手的视频加字幕工具,开发了纯浏览器运行的“字幕工作室”。拖入本地MP4即可在时间轴分段编辑字幕、调整样式并实时预览,导出带字幕视频,无需注册、后端和水印。工具使用WebCodecs逐帧解码编码,mp4box解析、mp4-muxer封装,视频全程留在本地,状态存于IndexedDB。目前支持本地音频识别自动生成字幕,推荐桌面版Chrome或Edge。
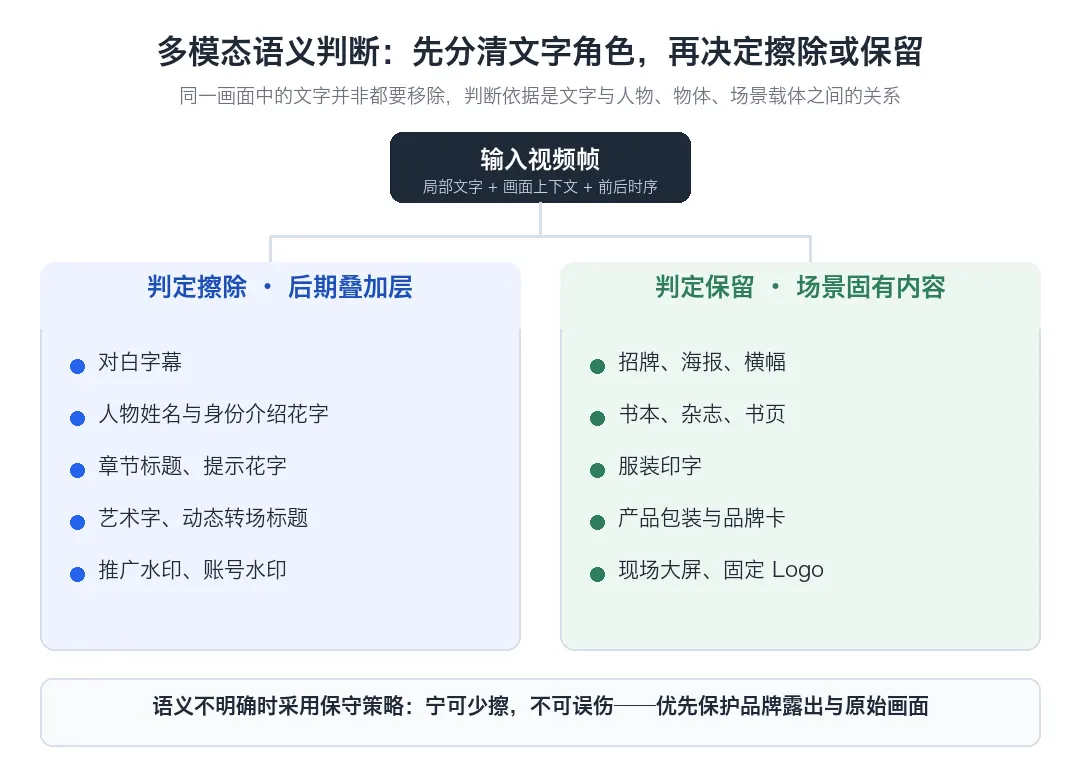
火山引擎推出AI MediaKit理解式视频编辑引擎,采用自研ReFM残差流匹配作为修复主干,解决字幕擦除难题。该方案通过多模态语义理解区分应擦除的后期叠加文字与应保留的场景固有文字,以残差编辑替代从噪声重建,结合局部与全局引导及Latent精准回贴,实现4步采样下的无痕修复。支持50多种语种,适配批量生产与多算力部署。
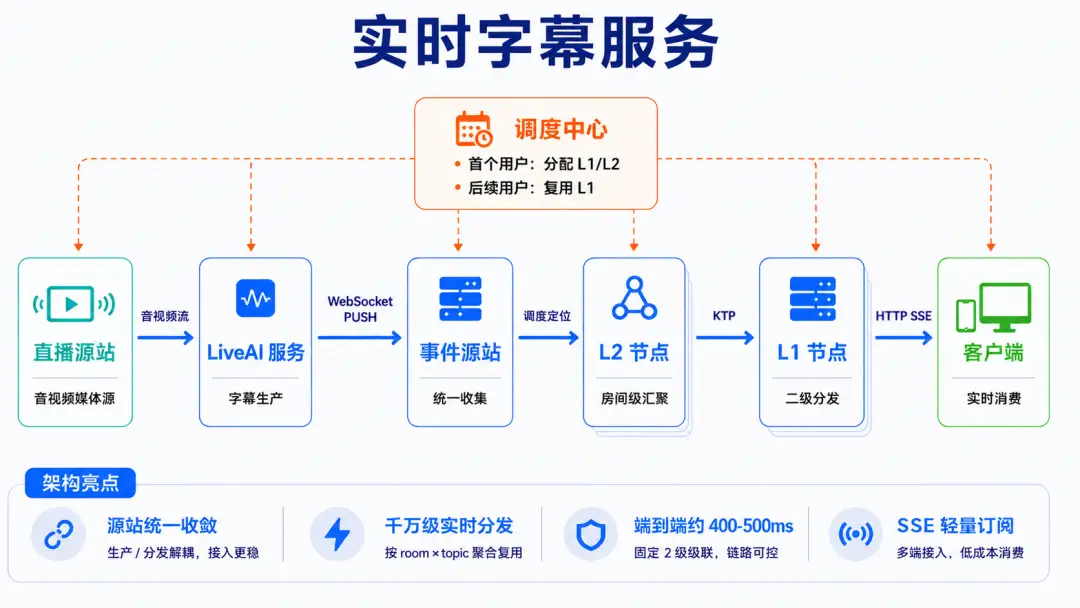
快手电商直播团队构建了业界首个大规模实时字幕系统,通过统一媒体PTS时间线、源站单份生产、两级级联分发和客户端版本化渲染,将端到端延迟从2秒降至500毫秒,字错率从7.81%降至3.51%,支撑千万级并发,并沉淀出可复用的实时AI工程范式。
研究提出CapQuiz,一种无参考视频字幕评测基准,通过人工验证的多选题考察字幕信息保真度,涵盖10类问题、24个视频领域,并设计CapF1指标综合衡量事实性与覆盖度。实验表明其与人类判断相关性显著优于现有指标,可提供可解释的模型性能分析。
Maestro 视频生成 API 支持通过自然语言 prompt 自动生成带字幕的视频,可指定场景、风格、音色、多语言,并支持在已有视频上迭代。提交后返回 task_id,需轮询查询结果。计费基于实际成片时长、语言数和质量档位,失败任务不扣费。
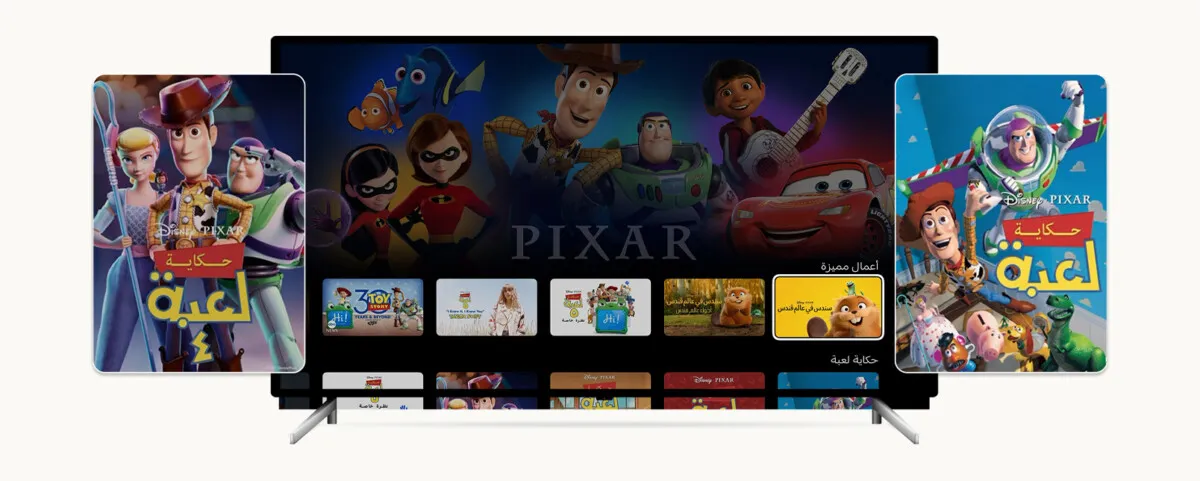
Disney+ 为了更好地服务国际市场,新增了对 17 种音频语言的支持,总语言数达到 58 种。用户界面支持 30 多种语言,字幕提供 42 种语言,更新包括阿拉伯语和希伯来语的右到左界面,强调了本地化在全球流媒体平台的重要性。
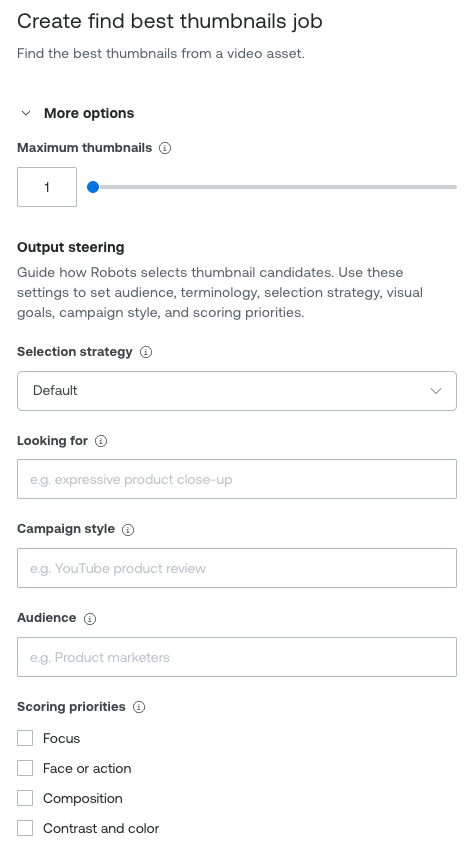
Mux Robots推出六个新工作流程,包括生成高质量字幕、音频翻译、最佳缩略图选择和观众参与分析。这些功能通过API调用实现,用户可以编辑现有字幕、分段视频场景,并获取详细的参与数据。所有工作流程均可通过Mux仪表板使用,定价基于资产时长和复杂性。
StreamVX与SyncWords合作,集成DVB-TTML字幕,简化字幕与播出基础设施的连接。通过vxOTT网关,提取原生字幕并将AI字幕转为HLS格式,支持高分辨率录制,满足多语言和无障碍需求。该解决方案可云部署或本地部署,助力广播行业向OTT转型。
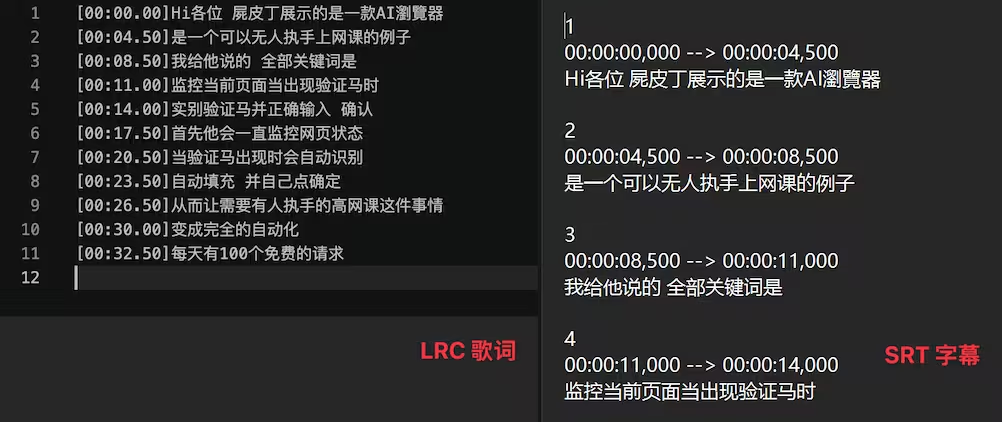
Vovsoft 发布了两款 Windows 限免工具:音频转歌词工具和二维码读取工具。音频转歌词工具使用离线 OpenAI Whisper 模型,支持多种音频格式,并能导出带时间轴的文本。二维码读取工具功能简单。限免有效期至2026年。
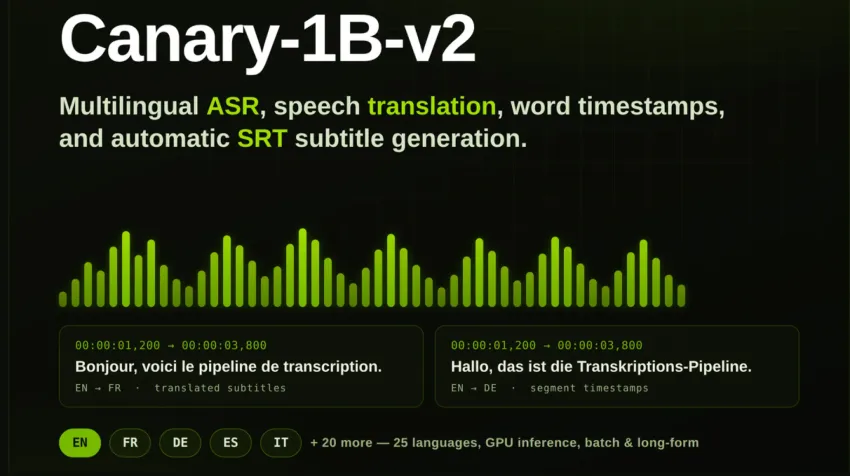
本文介绍了如何使用NVIDIA Canary-1B-v2构建多语言自动语音识别(ASR)和翻译工作流程,包括安装依赖项、加载模型、处理音频、执行英语转录和多语言翻译、生成时间戳及导出SRT字幕,最后测试长文本转录和批量处理以评估模型性能。
Agnes Video Generator 是一个免费的AI视频生成器,用户只需注册API Key即可使用。它提供简单视频、创意视频和文稿视频三种生成方式,支持自动生成旁白和字幕。尽管存在网络不稳定和生成时间较长的问题,但整体流程可靠,适合想尝试AI视频制作的用户。
微软正在更新Windows 11的多款内置应用,包括计算器、相机、闹钟和媒体播放器,目前仅限预览用户。更新后,正式版用户将在商店获得推送。新功能包括计算器的平方根精度提升、相机的变焦滑块和媒体播放器的自定义字幕。预计更新将在两周内推送给正式版用户。
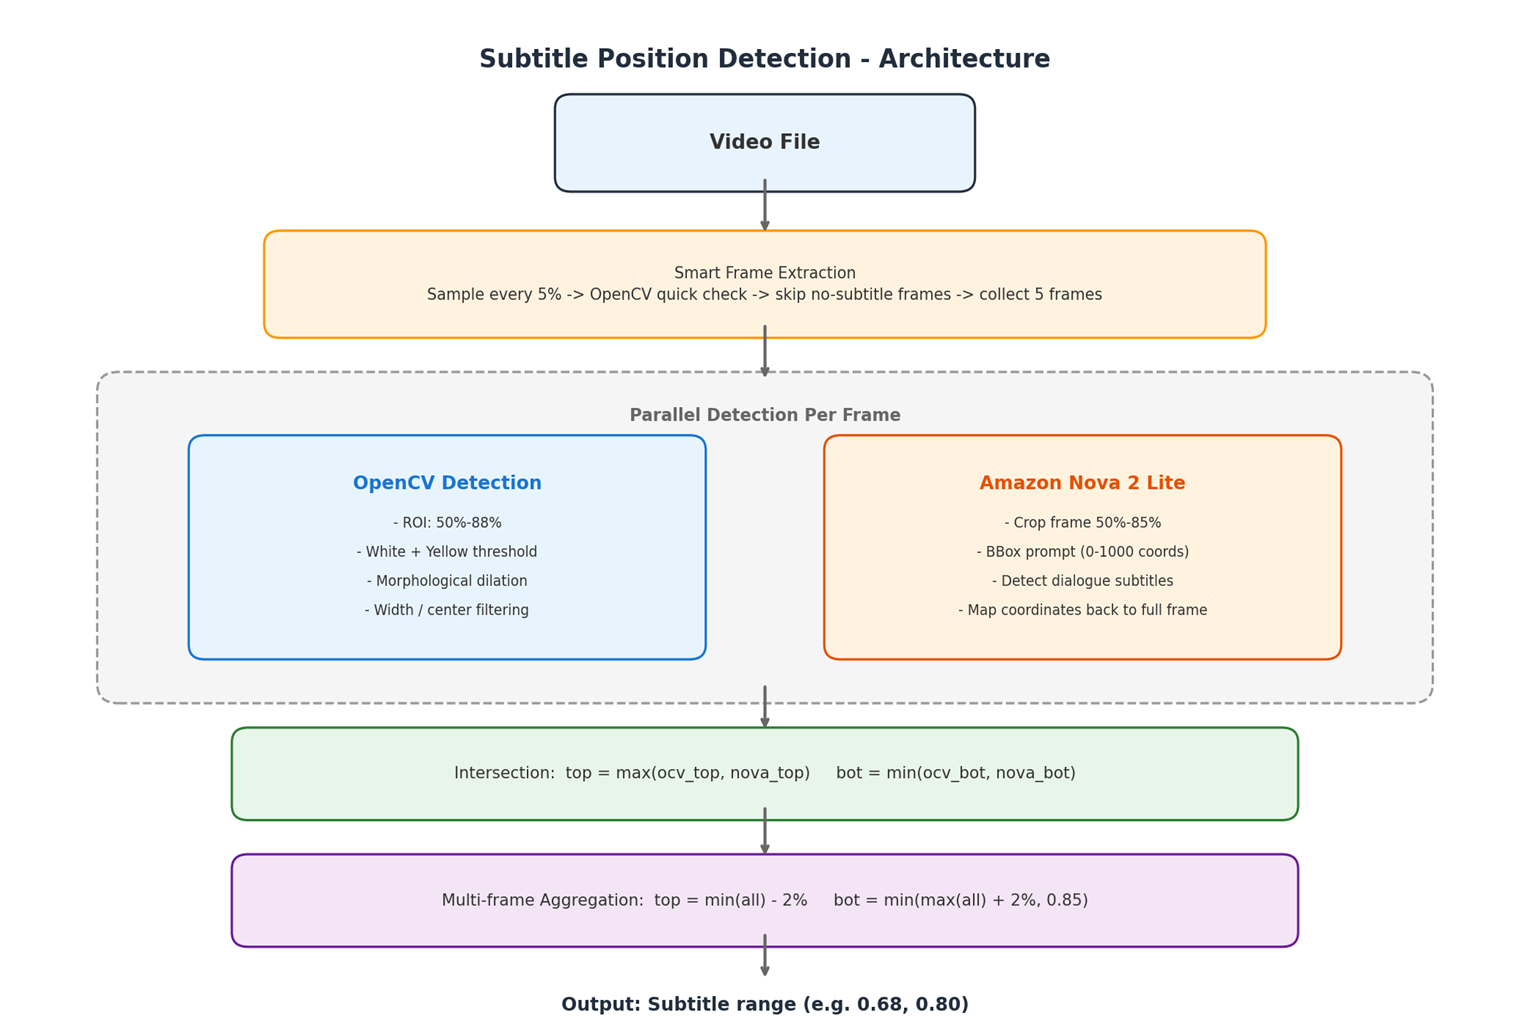
本文介绍了一种短剧视频字幕位置自动识别方案,结合OpenCV和Amazon Nova 2 Lite模型,在30个测试视频中实现了83%的准确率。该方案通过智能抽帧和裁剪技术,优化了字幕检测,显著减少了人工标注工作量,成本低廉,适合大规模应用。
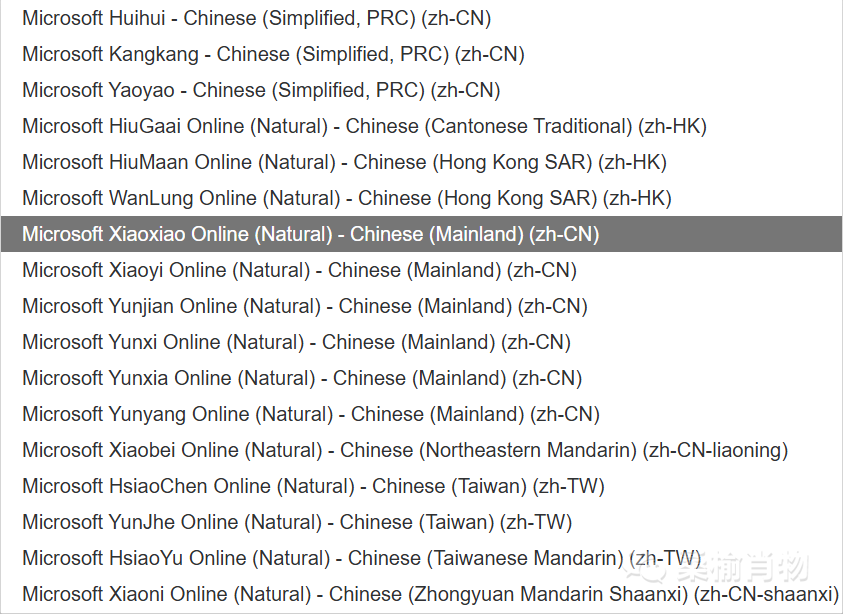
本文介绍如何利用浏览器的语音合成功能为网页视频添加配音,提升用户体验。通过简单代码实现“字幕转语音”,用户可享受更生动的视频内容。Edge浏览器支持多种语言和声音选择,操作简便,适合快速验证想法。
RubiCap是一种新型强化学习框架,通过大型语言模型生成细致的奖励信号,有效解决图像字幕生成中的多样性和泛化问题。在CapArena和CaptionQA基准测试中表现优异,超越传统方法和人类专家注释。
本文介绍了如何使用McCloudS/subgen项目实现本地AI视频字幕生成和翻译。作者扩展了“转录后翻译”功能,并结合Jellyfin自动生成双语字幕。通过GPU机器进行转录和翻译,优化了家庭局域网的媒体管理与播放,整体效果令人满意。
Vimeo的工程团队解决了AI生成字幕时的“空白屏幕”问题,通过将翻译过程分为三个阶段,确保了字幕的流畅性和时间同步。尽管增加了成本,但有效避免了手动质量检查,提升了用户体验。
完成下面两步后,将自动完成登录并继续当前操作。