小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
Dify.AI
沉浸式翻译 immersive translate
展开循环,让着色器提速10倍

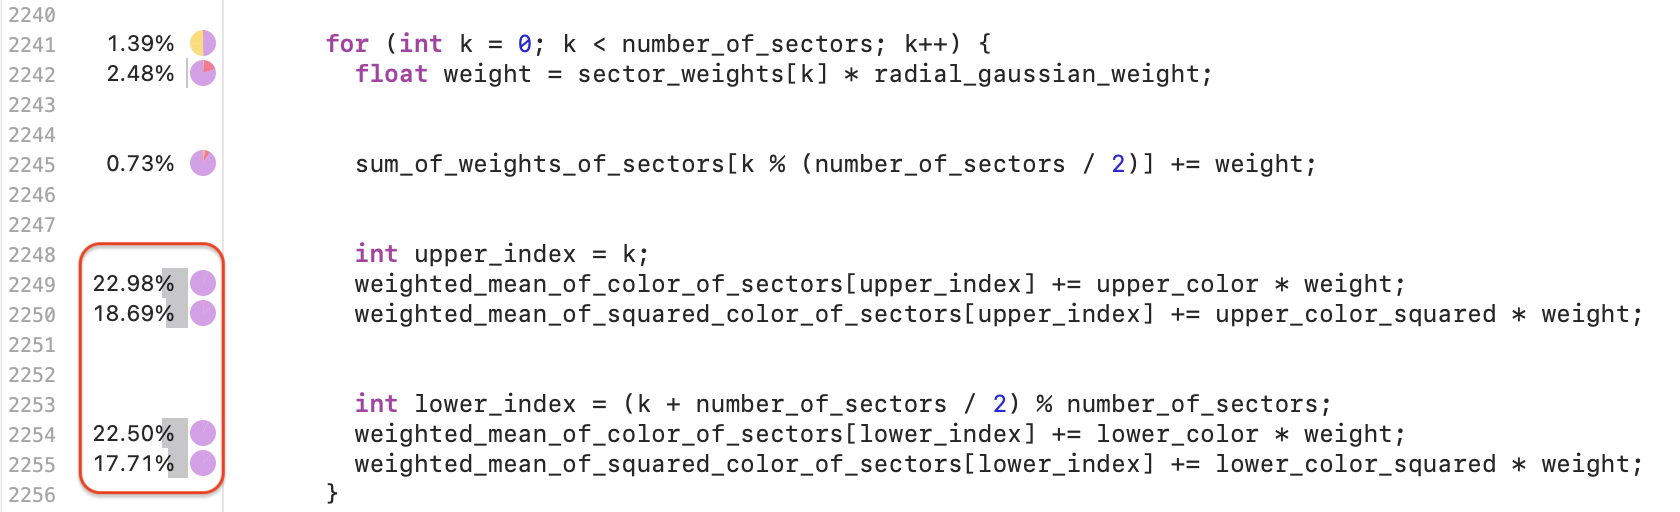
作者发现Blender的Kuwahara着色器在苹果M4 Max上GPU仅比CPU快不到两倍,经Xcode分析,内层循环未展开导致大量整数比较选择指令,占87%。手动添加[[unroll]]展开循环后,着色器提速10倍,浮点运算占比升至79%;在RTX 3080Ti上也快2倍,寄存器减半、占用率翻倍。该优化已合并进Blender 5.3。

展开循环,让着色器提速10倍

Aras' website Aras' website · 2026-10-05T10:05:10Z

在Cache Lab中,任务是优化32x32、64x64和61x67矩阵的转置,旨在减少缓存未命中。通过矩阵分块和循环展开技术,针对不同矩阵大小采用不同优化策略,以提高性能并降低缓存未命中次数。优化不仅依赖数学,还需理解硬件特性。

CSAPP缓存实验II:优化矩阵转置

Louis Aeilot's Blog Louis Aeilot's Blog · 2026-02-05T00:00:00Z

本文讨论了矩阵转置的优化,重点在于减少缓存未命中的情况。针对32x32、64x64和61x67三种矩阵,采用了矩阵分块和循环展开技术。32x32矩阵使用8x8分块,61x67矩阵采用16x16分块,64x64矩阵结合4x4和8x8分块及临时存储进行优化。优化后的代码显著减少了缓存未命中次数,提升了性能。

CSAPP缓存实验II:优化矩阵转置

Louis Aeilot's Blog Louis Aeilot's Blog · 2026-02-05T00:00:00Z
SPO 第3.2周 - 优化技术

第三周我们学习了编译器优化技术,包括死代码消除、强度削减、循环展开等。这些优化帮助编写高效代码,并通过编译器标志进行性能调优。开发者还可以使用记忆化和预计算提升性能。

SPO 第3.2周 - 优化技术

DEV Community DEV Community · 2024-10-22T23:01:00Z

这篇文章是JVM研发专家Aleksey Shipilëv撰写的系列文章之一,介绍了JVM的基本知识。文章讨论了Hotspot是否会对循环进行锁粗化优化,并通过实验验证了这一问题。实验结果显示,禁用循环展开可以提高性能,但不同的循环展开参数并没有明显的差异。文章总结了锁粗化对循环的优化方法,以及其带来的性能优势和范围限制。

JVM 剖析花园:1 - 锁粗化及循环

"地瓜哥"博客网 "地瓜哥"博客网 · 2024-01-13T08:08:36Z
  • <<
  • <
  • 1 (current)
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。

1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码