
展开循环,让着色器提速10倍
内容提要
作者发现Blender的Kuwahara着色器在苹果M4 Max上GPU仅比CPU快不到两倍,经Xcode分析,内层循环未展开导致大量整数比较选择指令,占87%。手动添加[[unroll]]展开循环后,着色器提速10倍,浮点运算占比升至79%;在RTX 3080Ti上也快2倍,寄存器减半、占用率翻倍。该优化已合并进Blender 5.3。
延伸解读
性能异常:GPU加速比远低于预期
在苹果M4 Max上,Kuwahara着色器的GPU耗时220ms,仅比CPU的385ms快不到两倍,而RTX 3080Ti上GPU比CPU快约20倍。这种异常比例提示GPU路径可能存在优化不足,而非硬件本身性能问题。
瓶颈定位:整数比较选择指令占比87%
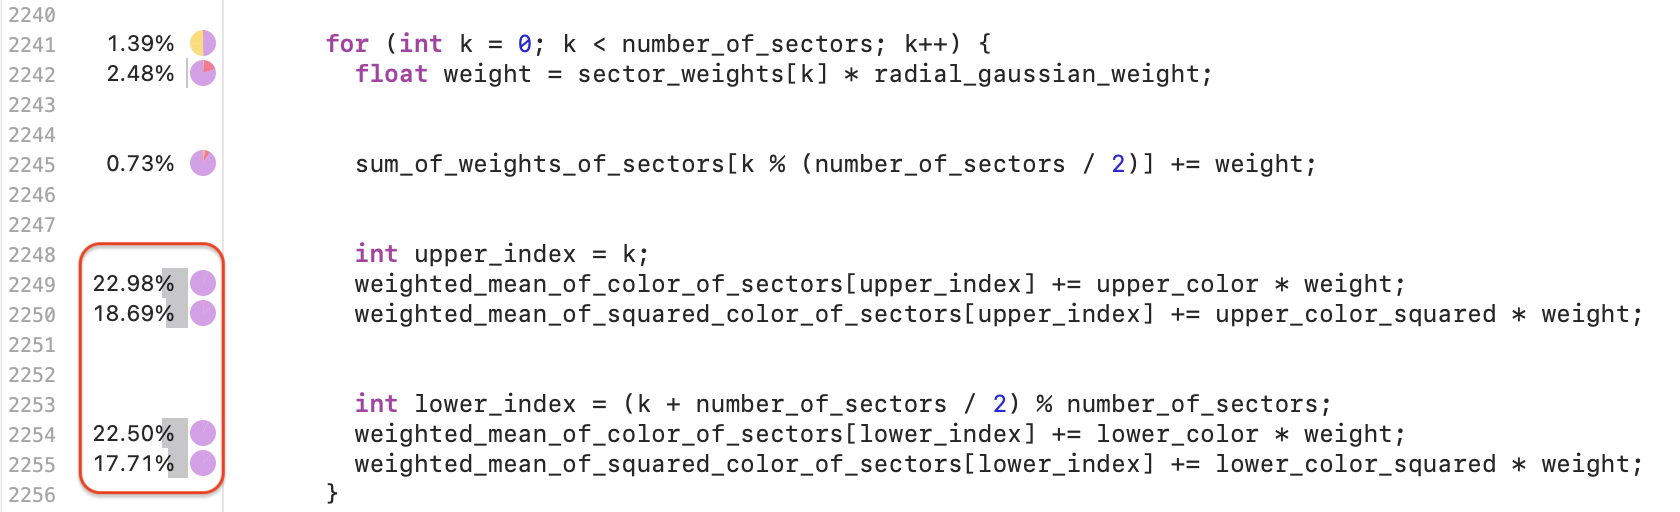
Xcode性能分析显示,着色器指令中浮点运算仅占12%,而条件、整数和布尔指令高达87%。进一步反汇编发现,内层循环未展开导致数组索引被编译为大量icmpsel指令,每次循环迭代产生约200条整数选择指令。
优化手段:手动循环展开
在BSL着色器语言中,为内层循环添加[[unroll]]属性,强制编译器展开循环体。展开后,M4 Max上着色器耗时从220ms降至20.4ms,提速10倍;浮点运算占比升至79%,整数条件指令降至17%。
跨平台效果与启示
在RTX 3080Ti上,展开循环同样带来2倍提速,寄存器使用从204降至113,占用率翻倍。该优化已合并至Blender 5.3。案例表明,即使编译器通常能优化循环,但在特定情况下手动展开仍能显著提升性能,且跨平台收益可能超出预期。
Q&A
为什么在苹果M4 Max上Kuwahara着色器的GPU加速比只有不到2倍?
因为内层循环未被编译器展开,导致着色器指令中87%是整数比较选择指令,浮点运算仅占12%,严重拖累了GPU性能。
如何通过循环展开优化Kuwahara着色器?
在BSL着色器语言中,为内层循环添加[[unroll]]属性,强制编译器展开循环体,避免因数组索引产生大量整数选择指令。
循环展开后Kuwahara着色器在M4 Max上性能提升了多少?
着色器运行时间从220ms降至20.4ms,提速10倍;浮点运算指令占比从12%升至79%,条件与整数指令从87%降至17%。
循环展开对NVIDIA RTX 3080Ti上的Kuwahara着色器有什么影响?
计算调度时间从17.8ms降至9.5ms,提速2倍;寄存器使用从204个减至113个,占用率翻倍,FMA浮点指令占比从44%升至60%。
Kuwahara着色器为什么会产生大量整数比较选择指令?
因为循环未展开时,数组索引变量导致编译器无法直接索引寄存器,只能生成一系列if-else比较选择指令来模拟数组访问,每次循环迭代约产生200条整数选择指令。
这个Kuwahara着色器优化被合并到哪个Blender版本?
该优化已合并到Blender 5.3版本(PR 164617)。
