

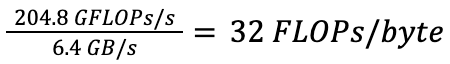

NEAREST BY 连接:在 Databricks Runtime 中扩展向量搜索
内容提要
Databricks将向量搜索实现为原生SQL的top-k排序连接(NEAREST BY),而非依赖外部实时端点。它将批量向量搜索视为大规模连接,借助Photon的融合GEMM内核、SIMD距离函数和分组top-k聚合,并支持以Delta表存储的IVF索引加速近似查询,在十亿级向量上兼顾性能、容错与成本。
延伸解读
从服务到批处理:向量搜索的架构转变
文章指出,许多向量搜索工作负载本质上是批处理任务,例如实体解析、去重和语义标记,它们需要定期处理数百万查询与数十亿向量的匹配,关注的是SLA内完成和成本,而非单次查询延迟。Databricks将向量搜索构建为引擎原生的top-k排序连接,而非依赖外部实时端点,这更适合批处理场景,能利用分布式引擎的弹性和容错能力。
NEAREST BY 的语义与优化器友好性
NEAREST BY 将批处理向量搜索表达为一种非对称的top-k排序连接,左侧驱动,右侧被搜索。它明确区分 EXACT 和 APPROX 语义:EXACT 保证精确结果,APPROX 允许优化器使用近似索引,且创建或删除索引不会静默改变查询结果。这种设计让优化器能识别并优化查询模式,避免了其他系统中因查询形状漂移导致快速路径失效的问题。
性能关键:融合算子与数据重用
朴素计划中,每对查询和基向量独立评分,没有数据重用,导致内存带宽成为瓶颈。Databricks 引入融合的 Photon 算子,用分块 GEMM 内核缓冲较小输入,流式处理另一侧,并维护每查询的 top-k 状态。这样,算术强度随批大小增长,在查询批大小达到 64 时越过屋顶线拐点,从而利用计算峰值,显著提升性能。
IVF 索引:以 Delta 表实现可扩展近似搜索
对于十亿级向量,精确搜索的 O(nq×nb) 复杂度不可行。Databricks 采用 IVF 索引,训练 k-means 生成质心,将基向量分配到最近质心,查询时只扫描最近簇。索引存储为普通 Delta 表,按质心 ID 进行 liquid clustering,支持事务性增量刷新。APPROX 查询重写为探测质心、等值连接、评分和合并,未刷新的新文件通过补偿分支暴力搜索,确保索引陈旧只影响剪枝效率,不降低搜索质量。
Q&A
Databricks 为什么将向量搜索实现为 SQL 连接而不是外部端点?
因为许多向量搜索工作负载本质上是批处理的,例如实体解析、去重、语义标记等,这些任务需要定期对数百万到数十亿向量进行查询,关注的是在 SLA 内以合理成本完成作业,而不是单次查找的延迟。外部端点受限于实时端点规模,吞吐量无法随运行时集群扩展,而 Databricks Runtime 作为分布式、容错、弹性的执行引擎,更适合处理大规模连接。
NEAREST BY 连接语法有哪些关键特性?
NEAREST BY 是一种非对称的 top-k 排名连接,左侧驱动,右侧被搜索。它支持显式指定排序方向(BY SIMILARITY 降序或 BY DISTANCE 升序),LEFT OUTER 保留无候选的查询行,BY 表达式可插拔。APPROX 和 EXACT 编码语义契约:EXACT 保证精确 top-k,APPROX 允许优化器使用近似策略(如 ANN 索引),因此创建或删除索引不会静默改变查询结果。
NEAREST BY 如何被优化器重写为关系操作?
NEAREST BY 解析为逻辑连接节点,优化器将其重写为:为每个查询行生成 ID,对每个(查询,基础)对评分,使用分组 top-k 保留每个 ID 的最佳 k 个,然后将保留的行内联回去。这本质上是一个交叉连接、一个标量评分表达式和一个分组 top-k 聚合。由于所有操作都是普通关系操作,计划可以像其他操作一样分布、溢出和重试,正确性和容错性自然获得。
Photon 中融合算子如何提升向量搜索性能?
融合算子是一个单一的 Photon 执行节点,替代交叉连接、距离/相似度投影以及可选的部分 top-k。它缓冲较小输入,流式处理另一侧,使用自定义 GEMM 内核按查询-基础瓦片评分,并在 k 足够小时维护每个查询的 top-k 状态。通过数据重用,算术强度随批量大小线性增长,在 nq=64 时越过脊点,从而利用计算屋顶,避免朴素计划的内存带宽瓶颈。
向量索引是如何实现的?它如何加速近似查询?
向量索引采用经典的 IVF 设计:通过 k-means 训练质心,将每个基础行分配到最近质心。索引存储为普通的 Delta 表,按质心 ID 进行液体聚类,使每个簇的候选连续存储。查询时,APPROX 查询重写为:用相同的 top-k NEAREST BY 连接探测质心,按质心 ID 等值连接限制每个查询到其探测的簇,评分并 top-k,然后合并。自上次刷新后添加的文件在补偿分支中暴力计算并合并,因此过时索引只会减少剪枝,不会降低搜索质量。
NEAREST BY 在评估中表现如何?
在客户典型工作负载上评估,基础表从 10 万到 50 亿向量,查询批次高达 1000 万向量,目标召回率@K 至少 96%。使用索引 ANN 时,在十亿级向量上实现了性能、容错和成本效益的平衡。
