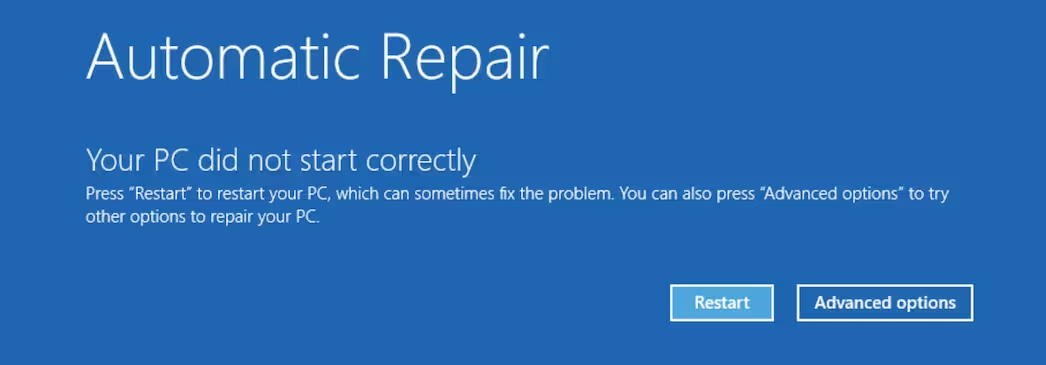

Windows 11新增“时间点还原”功能,默认在系统分区大于200GB时启用,每24小时自动创建系统快照,可恢复至72小时内的状态。若误删文件或系统故障,可通过恢复环境、Shift重启或命令行进入还原。该功能仅备份C盘,还原会丢失之后更改,与系统还原不同,建议优先使用。
本文解析Ceph中恢复、回填和深度清理三种机制的差异:恢复由日志驱动修复缺失对象,回填用于全量对象拷贝,清理则校验数据一致性。文章还讨论了mClock调度器对恢复流量的控制边界、异步恢复机制,以及恢复速度与前台延迟之间的权衡,并指出mClock无法控制块设备层的I/O带宽。
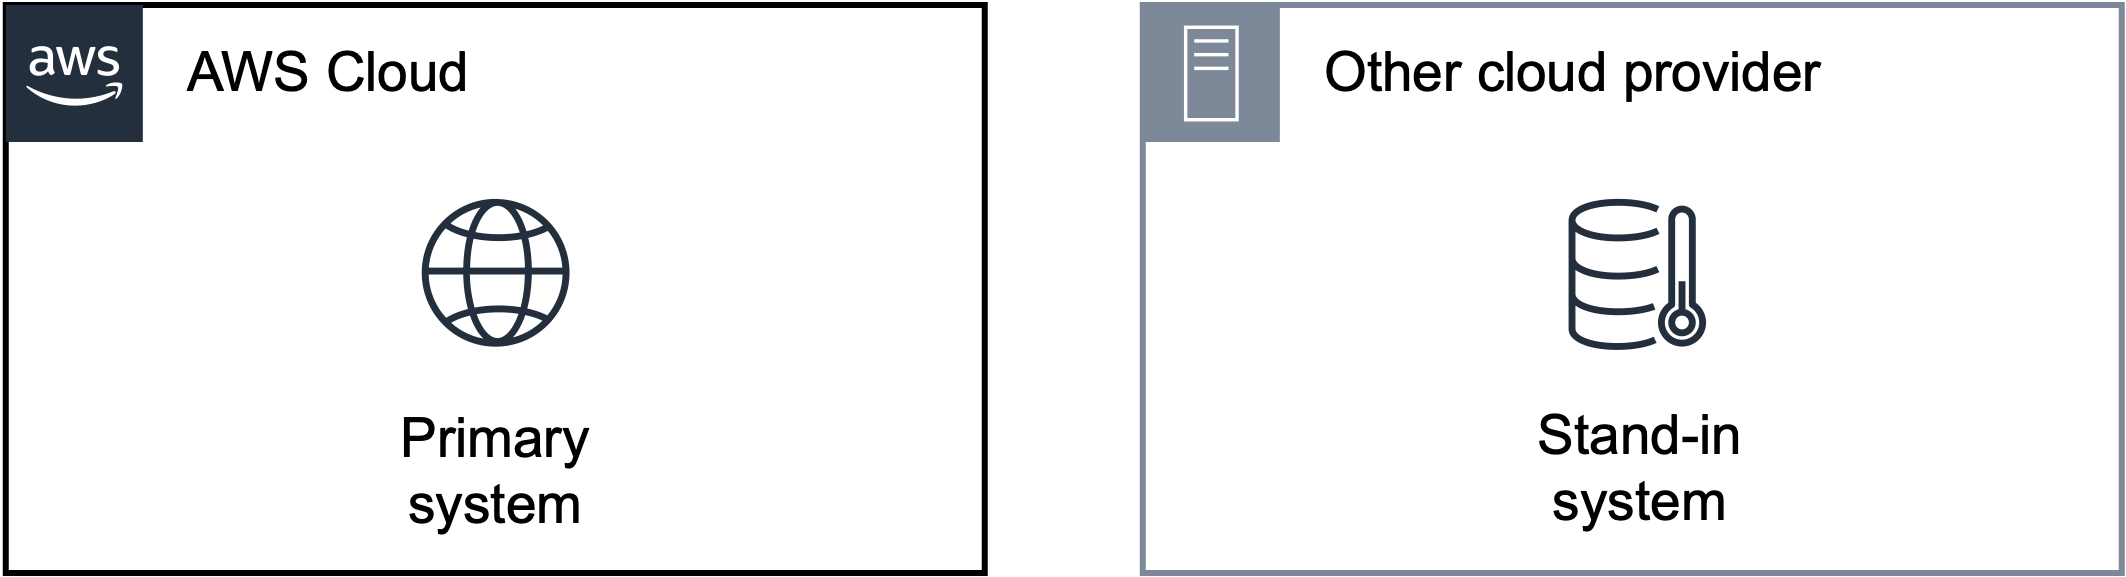
本文介绍了在AWS上满足数据驻留要求的三种灾难恢复策略:策略1使用加密作为补偿控制,跨区域复制数据;策略2通过AWS Outposts在本地存储备份,保持数据在境内;策略3则完全在境内运行,包括本地基础设施或多云救生艇方案。每种策略需根据法规和风险偏好选择,并持续进行端到端测试以确保恢复能力。
DBeaver插件,用于将项目、脚本和凭据备份到HTTPS WebDAV端点。创建zip归档并上传,默认包含工作空间项目、元数据和全局配置,排除日志等临时文件。恢复时需关闭DBeaver,独立进程替换文件后重启。界面提供备份、恢复和设置菜单,支持配置WebDAV地址、凭据和保留数量。安装需通过更新站点,仅支持HTTPS,恢复会覆盖现有文件。
Codex将于2026年7月31日恢复5小时窗口限额,此前因调查Sol模型用量问题临时取消。社区猜测恢复时会再次重置周用量,但未获证实。用户需注意时差,合理规划使用,避免额度耗尽后长时间等待。
Diagrid发布Catalyst 2.0,为AI代理添加持久执行和防篡改记录层,支持LangGraph等框架。它通过Dapr工作流引擎记录模型和工具调用,使代理中断后可从最后步骤恢复,无需重跑。Catalyst还提供签名历史链,确保操作可审计,适用于金融、医疗等受监管行业,并符合欧盟AI法案要求。
作者用Next.js开发新博客,但旧文章未备份,尝试通过RSS阅读器恢复失败,因此决定重新开始。
本文讨论了FoundationDB的严格可串行化和外部一致性,强调了5秒事务限制的设计目的,以确保系统恢复的有界性。通过结合OCC与MVCC,FoundationDB实现了可串行化快照隔离(SSI)语义。在高冲突情况下,重试机制可能导致吞吐量下降,需通过优化数据模型和减少读集来缓解。
FoundationDB通过Sequencer管理事务版本分配,确保严格可串行化。每个世代只有一个活跃的Sequencer,故障时可快速恢复。客户端通过Proxy间接使用Sequencer,需短事务和幂等性以应对版本作废问题。
文章讨论了通过错误恢复和任务系统增强大型语言模型(LLM)的能力。针对常见故障(如输出截断、输入过长等),提出了自我恢复的方法。任务系统将大目标拆分为小任务,支持持久化和依赖管理,提升规划能力。后台任务功能允许LLM在执行耗时操作时继续处理其他任务,保持高效性。
S&P Global利用Amazon FSx和NetApp ONTAP实施了一种创新的灾难恢复解决方案,确保在区域故障时15分钟内实现只读模式的快速切换。该方案通过SnapMirror复制和FlexClone技术保持数据一致性,支持金融服务的业务连续性,降低基础设施成本,并满足合规要求。
研究表明,大脑健康管理应关注“脑力寿命”,即保持清晰思维、情绪稳定和社交能力。大脑认知能力在二十多岁后开始下降,早期干预能有效提升“脑健康指数”。新方法SMART训练强调管理能力,适用于各年龄段,促进神经可塑性。研究希望将大脑健康变为可追踪的日常指标,强调持续成长的重要性。
本文介绍了 Git 的 reflog 功能,强调其在找回误删提交时的重要性。reflog 记录了每次引用指针的移动,存储在 .git/logs/ 目录下。每条记录包含旧指针、新指针、提交者、时间戳和消息。通过 reflog,可以恢复已删除的分支和提交,确保即使对象不在任何分支上,只要 reflog 存在,仍可访问。
本文讨论了Flink中Savepoint与Checkpoint的区别及应用场景。Savepoint是用户手动触发的可移植快照,适用于版本升级和拓扑变更;Checkpoint是自动生成的,主要用于故障恢复。Savepoint支持状态迁移和并行度调整,但需注意UID管理和状态兼容性。文章还提供了操作命令、常见异常处理及版本升级检查清单,强调了在生产环境中使用Savepoint的重要性。
达梦数据库的库级恢复是关键的灾备操作,主要通过dmrman工具进行。恢复步骤包括停止数据库服务、确认辅助进程启动、执行还原、恢复和更新魔数。逻辑备份恢复使用dimp工具,支持多种导入方式。在生产环境中需注意备份有效性、字符集一致性及权限设置,以确保数据安全和完整性。
灾难恢复是一个过程,需要编写清晰的操作手册并进行压力测试演练。手册应简洁明了,包含明确的步骤和责任分配。定期演练可以检验手册的有效性,提升团队应对能力,营造无责文化,以便在真实事件中更好地应对挑战。
数据库的检查点是核心功能,负责将脏页写入磁盘。检查点滞后可能导致数据库无法恢复。文章回顾了两个事件,强调在检查点问题时重启数据库的风险。健康系统的检查点快速完成,而不健康系统在负载过重时可能延迟至一小时。应避免在检查点滞后时重启数据库。
腾讯优图实验室与中山大学、清华大学合作的研究评估了大型语言模型(LLM)智能体在工具失败场景下的动态重规划能力。研究表明,隐式语义失败的恢复难度远高于显式故障,复杂的拓扑结构可能导致智能体陷入无效循环。此外,动态重规划能力的提升滞后于基本性能,强调了状态管理与异常检测结合的重要性。
美国政府与Anthropic就Claude Fable 5模型的出口管制谈判未果,原因是模型存在越狱安全隐患。尽管Anthropic认为担忧被夸大,但美国政府坚持必须解决越狱问题才能解除管制,导致模型恢复时间遥遥无期。
灾难恢复是一个过程,而非单一工具。在现代环境中,系统可用性和用户体验至关重要。灾难不仅包括自然灾害,还涉及性能下降、数据损坏和安全事件等。有效的灾难恢复需要充分的准备和预防,真正的恢复能力在于应对已发生的故障。恢复目标(RPO和RTO)应根据业务需求进行协商,而非简单声明。成功的恢复计划应涵盖基础设施故障、程序失误和人为错误等多个层面。
完成下面两步后,将自动完成登录并继续当前操作。