小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
Dify.AI
沉浸式翻译 immersive translate

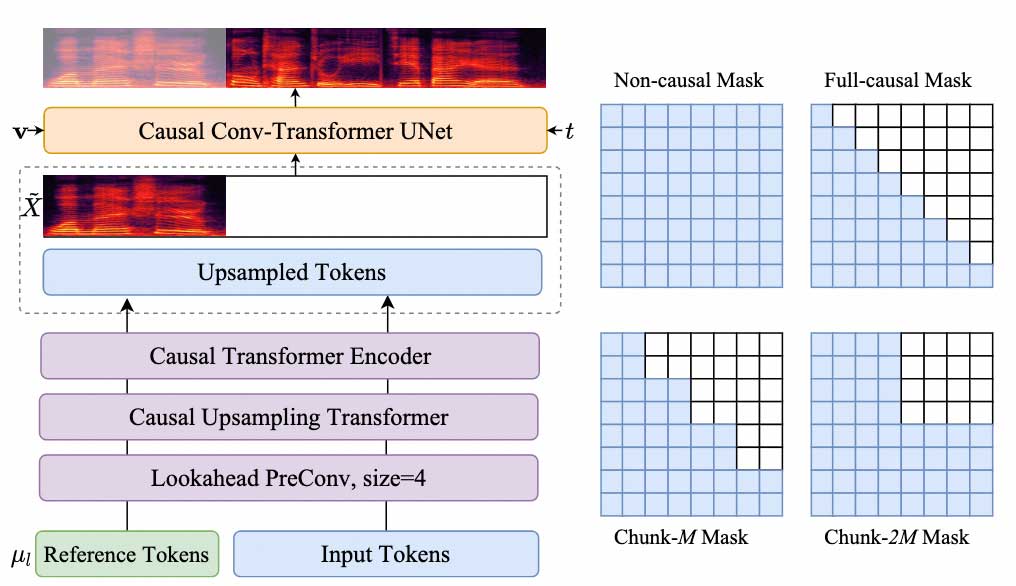
哔哩哔哩开源的IndexTTS-2.0是一个可控情感和时长的自回归文本转语音系统,解决了语音合成中的时长控制和情感表达问题。该系统支持多种情感调节,广泛应用于AI配音和有声读物,助力全球内容出海,提升跨语言视频的本地化体验。

B站开源IndexTTS-2.0:突破自回归TTS时长与情感控制瓶颈

量子位 量子位 · 2025-09-11T02:28:33Z

本研究探讨了语言模型间KL散度估计的高方差问题,提出了一种Rao-Blackwell化估计器,降低了方差并保持无偏性。实证结果表明,该估计器在情感控制微调中显著提高了KL估计的稳定性。

更好的语言模型间KL散度估计

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-04-14T00:00:00Z

本文研究了大型语言模型(LLM)知识编码的优化技术,提出了LLMBRACES方法,通过调整FFN层的子更新贡献,显著提升模型在情感控制和降低文本毒性方面的性能。

LLM支架:基于相关子更新优化大型语言模型的预测

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-03-20T00:00:00Z

本研究提出了XMusic框架,旨在提升人工智能生成音乐的质量,特别是在情感控制和高质量输出方面。XMusic通过灵活的提示生成可控的高质量符号音乐,并通过创新的表示和选择器有效评估音乐质量。实验结果表明,XMusic在音乐质量上显著优于现有方法,具有重要应用潜力。

XMusic: Towards a Generalized and Controllable Symbolic Music Generation Framework

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-01-15T00:00:00Z
语音生成大模型CosyVoice升级2.0版本 | 开源更新

CosyVoice是阿里巴巴开源的语音生成大模型,最新的2.0版本在音质、准确性和稳定性上有显著提升,支持多方言和情感控制,语音合成延迟更低。

语音生成大模型CosyVoice升级2.0版本 | 开源更新

实时互动网 实时互动网 · 2024-12-16T02:11:32Z

本研究提出了一种新方法,通过提取富有情感的语音片段并生成详细描述,解决了现有情感语音数据库标注简单的问题,从而提高情感粒度。这为开发灵活的情感控制文本转语音系统奠定了基础。

EmoSpeech: A Corpus of Emotionally Rich and Contextually Detailed Speech Annotations

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-12-09T00:00:00Z

随着声音克隆技术的快速发展,AI已能生成逼真的语音,但仍面临零样本学习和情感控制的挑战。E2 TTS和F5 TTS通过新方法提升语音合成质量,支持多语言和情感调节。hyper.ai官网提供相关教程和数据集,助力研究与应用。

3秒实现多音色混合克隆!F5/E2 TTS教程上线;PsyDTCorpus 5k 心理对话数据集发布,精准模拟心理咨询师语言风格

HyperAI超神经 HyperAI超神经 · 2024-11-08T09:56:36Z

本研究提出EmoKnob框架,解决了文本到语音技术中情感选择和强度控制的问题。EmoKnob通过少量示例实现细粒度情感控制,并引入评估指标系统性评估情感合成效果。结果显示,该框架在情感表现力上优于商业TTS服务。

EmoKnob: Enhancing Voice Cloning with Fine-Grained Emotional Control

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-10-01T00:00:00Z

本文介绍了Bardo Composer等多种基于人工智能的音乐生成系统,探讨了情感控制、实时生成和可解释性等技术。这些系统在音乐创作中有效提升了情感表达和用户体验,强调了人类反馈的重要性。未来研究将关注AI音乐生成的实用影响及其跨学科应用。

潮汐MerzA:通过强化学习结合情感建模和自主代码生成

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-09-12T00:00:00Z

本文介绍了多种情感视频生成技术,如情感视频肖像(EVP)、EMOTE、DREAM-Talk和EmoTalker。这些系统通过音频与面部表情的结合,实现高质量的情感表达和唇部同步,显著提升了生成视频的真实感和表现力。研究表明,这些新方法在情感控制和动画生成方面优于传统技术。

EMOdiffhead:通过扩散在对话头生成中的连续情感控制

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-09-11T00:00:00Z

本文介绍了一种基于离散扩散模型(D3PMs)生成多声部符号音乐的方法,强调其高质量和灵活性。该方法结合变分自编码器和扩散模型,能够生成特定作曲家风格的音乐,并实现情感控制。此外,研究展示了通过分层语言模型生成完整音乐作品的能力,提升了音乐生成的可控性和质量。

为什么扰动符号音乐是必要的:通过联合概率扩散模型拟合从未使用音符的分布

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-08-04T00:00:00Z

本文提出了一种结合扩散模型与生成对抗网络的方法,以提高算法音乐生成中的情感控制和计算效率。通过训练变分自编码器,成功生成特定情感的符号音乐,展示了该模型在音乐创作中的灵活性和高质量表现。

SYMPLEX: 使用单纯形扩散和词汇先验进行可控符号音乐生成

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-05-21T00:00:00Z

本研究探讨了多臂赌博机方法在自然语言生成中的应用,提出了一种通过强化学习优化多种风格生成的动态权重方法。研究表明,引入密集奖励能有效提升情感控制和摘要生成效果。此外,提出了多目标Q网络和Parrot框架,解决了多智能体系统中的学习策略问题,实验结果显示这些方法在多个质量指标上优于现有算法。

多目标强化学习中的动态奖励调整在辅导员反思生成中的应用

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-03-20T00:00:00Z

扩散模型广泛应用于音乐生成,包括音频延续、修复、轨道过渡与风格迁移。研究结合变分自编码器、生成对抗网络和离散扩散,实现情感控制、多轨符号音乐生成及作曲家风格模仿,并探索逻辑约束采样以提升生成质量与效率。

用非可微分规则引导扩散进行符号音乐生成

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-02-22T00:00:00Z
  • <<
  • <
  • 1 (current)
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。

1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码