文章讨论小参数语言模型在搜推场景的推理优化,核心是在延迟约束下追求有效吞吐,而非单纯追求吞吐数字。压测应将超时请求计为失败,明确端到端延迟预算并区分排队与计算耗时;合批需权衡等待成本,压测应贴近真实请求分布并关注尾部延迟。工程上应设置调用超时、及时停止过期任务、限制重试并演练降级,通过小流量对照验证质量与资源消耗。
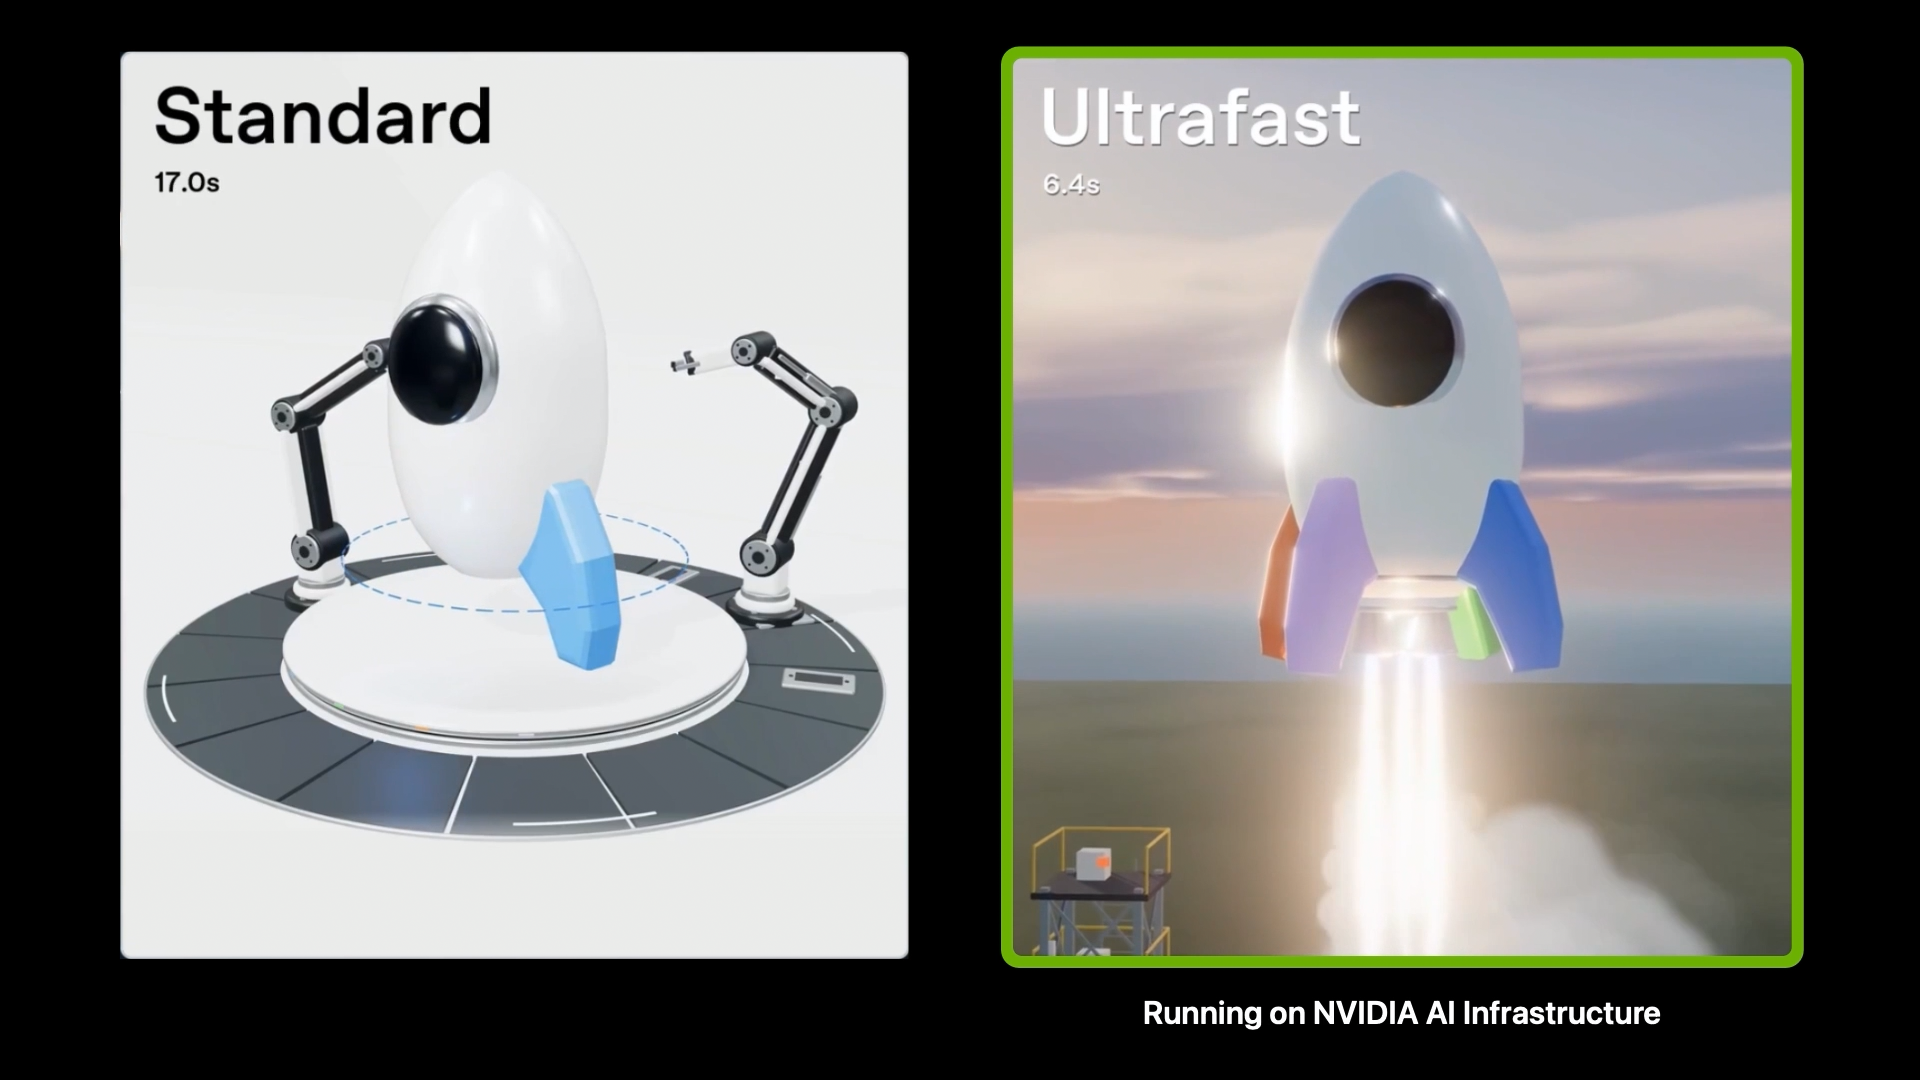
OpenAI推出GPT-6 Astra Ultrafast,运行于NVIDIA Blackwell GPU,通过持续推理优化,令牌生成速度比标准模式快8倍。该模型已上线OpenAI API,面向ChatGPT Work和Codex用户,可加速代码生成、工具调用和交互应用。OpenAI还利用自身模型优化GPU推理软件,提升性能与基础设施利用率。
本文介绍vLLM推理优化:通过连续批处理让GPU持续忙碌,用PagedAttention分页管理KV缓存减少碎片,并利用前缀缓存跳过重复计算。还介绍GuideLLM测性能、lm_eval测质量,以权衡成本、准确率与性能。
Chip Huyen在P99大会上指出,模型训练是一次性成本,推理成本则反复发生,比例可达1:10至1:100。她建议关注首token延迟和goodput等指标,并从模型与服务两方面优化:量化、蒸馏、批处理、预填充解码分离、并行及提示缓存。提示缓存命中率可达90%以上,显著降低成本。评估推理服务时,除成本和延迟外,还须关注模型质量。
NVIDIA推出BioNeMo推理运行时,通过内核选择、CUDA Graph和Ray流水线优化蛋白结构预测。在8张H100上,Boltz-2吞吐达每GPU小时5.85万残基,较公开实现提升2.9倍。文章强调科学AI吞吐应以成功结构数和完整流程时间衡量,需关注CPU预处理、写盘和失败率等瓶颈。
NVIDIA测试显示,四张B200运行Nemotron 3 Ultra,在每用户50 Token/s延迟目标下,启用NIM优化栈后并发承载从718提升至1997 Token/s,约2.5倍。提升源于内核、张量并行、缓存复用、调度与推测解码协同,并非通用结论。文章强调推理优化需兼顾吞吐与延迟,用Pareto曲线和SLO评估,并保存真实流量轨迹持续回放,避免单次跑分误导。
TensorSharp 3.3.0.0 发布,新增 Wan 2.1/2.2 视频生成支持,性能大幅提升;引入 Muse-Glimmer-30B 和 GLM 5.x 推理,优化投机解码速度;修复多项安全漏洞,建议升级。
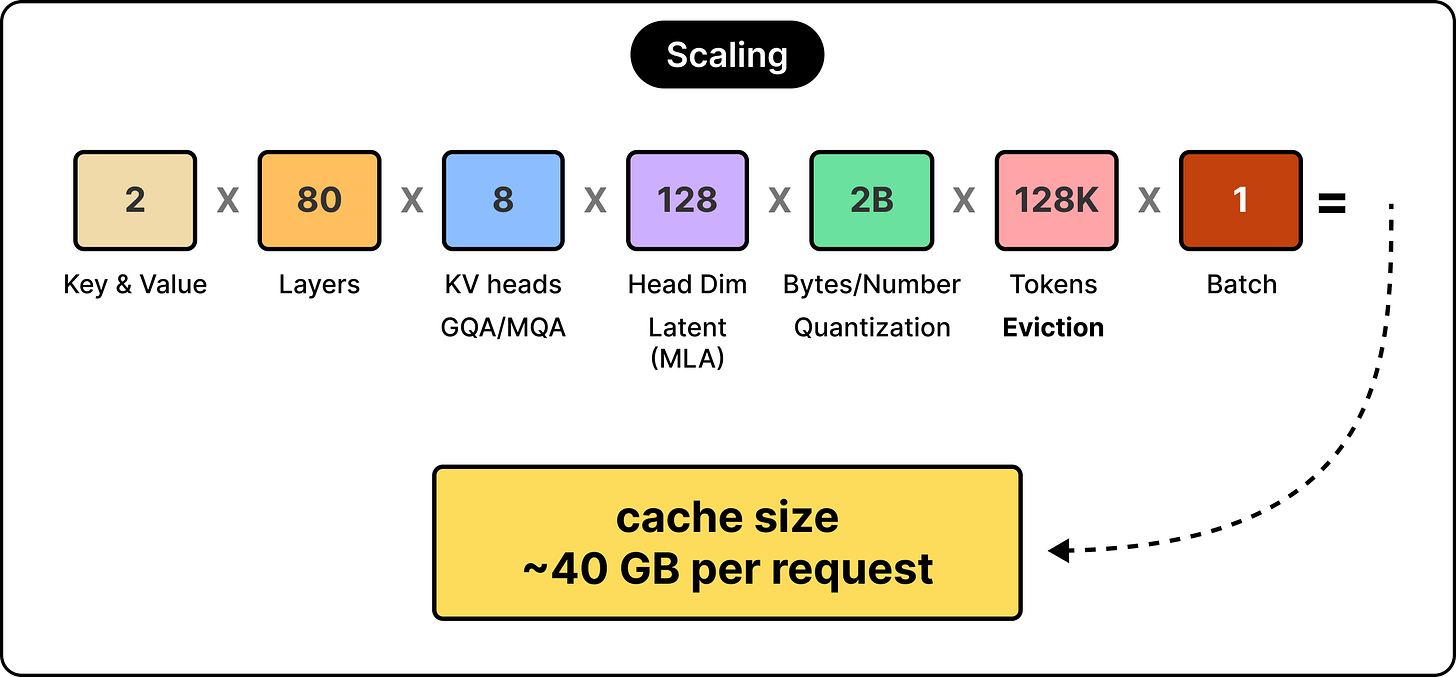
LLM长上下文推理成本高,主因是KV缓存随token数线性增长,解码时需逐token读取全部缓存,受内存带宽限制。优化方法包括:分组查询注意力、潜在注意力减少每token存储;量化降低存储精度;驱逐机制减少token数;分页注意力和前缀缓存提升内存管理效率。各方法在质量、工程复杂度间权衡,适合长上下文和高并发场景。
Cloudflare Workers AI通过三项技术优化Kimi和GLM等大型MoE模型的推理效率:量化KV缓存至FP8,使上下文容量翻倍且成本降低30%;压缩模型权重至INT4,减少40%内存占用并提升解码速度;引入KV缓存完整性检查,确保共享缓存安全,开销低于1%。这些优化在保持模型精度不变的前提下,支持更多客户并降低成本。
OpenAI发布GPT-5.6家族,包含Sol、Terra、Luna三个模型,其中Sol性能超越Claude且成本减半。通过推理栈优化、负载均衡、推测解码、内核重写及缓存提升,效率增加20%。Sol能自我优化代码,实现AI优化AI,智能体套件减少重复开销,推动效率曲线陡升。
OpenAI发布GPT-5.6 Sol后,用户反映其消耗ChatGPT Work和Codex使用额度过快。OpenAI重置了额度并优化推理,使会话时长延长18%。工程负责人承认低估了代理执行成本,因Sol的编程工具调用和复杂工作流消耗大量令牌,测试未覆盖重度用户场景。公司改进等待和搜索效率,并暂时取消五小时上限。
本文介绍OpenAI GPT-5.6系列模型在推理效率和成本上的优化。通过负载均衡、推测解码、内核优化和提示缓存等技术,Sol模型在Codex中自主改进系统,降低服务成本20%,提升生成效率15%。同时,代理框架通过避免上下文膨胀和保留前缀缓存,减少重复工作,实现更高效、更经济的智能服务。
趋境科技与杭州萧山区钱江世纪城签约,设立华东区域总部,建设AI Token生产服务平台(ATaaS)交付中心,计划五年内建成万卡级AI Token工厂。公司源自清华,专注企业级推理优化,自2026年以来单设备效率提升3倍,总产能增长超30倍,服务万亿参数模型,日产量达万亿级。
研究者提出了DiffMAS框架,将多智能体系统的通信机制转变为可学习的隐式表示,实现了通信与推理的联合优化。该方法通过隐空间映射和高效的参数训练,提高了推理准确率,减少了通信开销,表明通信与推理应紧密结合。实验结果显示,DiffMAS在多个基准测试中表现优异,证明了通信协议可以被学习和优化。
本文探讨了长上下文模型的工程挑战与解决方案,包括位置编码、注意力计算复杂度、训练策略和推理优化。随着上下文长度增加,模型面临计算复杂度和显存限制。采用RoPE、YaRN等技术扩展位置编码,并结合线性注意力和稀疏注意力优化计算效率。在训练方面,采用短预训练与长继续预训练相结合的策略,推理时利用前缀缓存和KV压缩等技术提高效率。
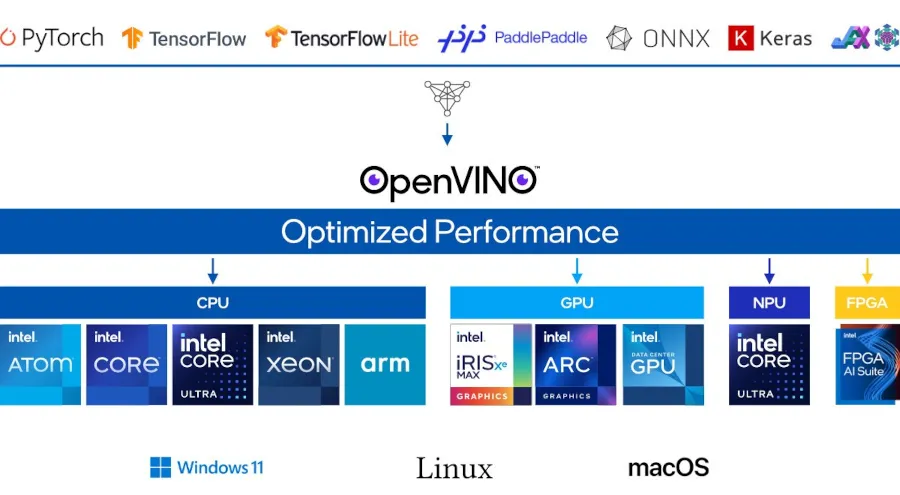
英特尔发布了OpenVINO工具包的2026.1版本,新增对Qwen3 VL模型和GPT-OSS 120B的支持,优化了跨Intel CPU、GPU和NPU的推理,支持Wildcat Lake SoC和Intel Arc Pro B70显卡。
视频生成模型的推理优化应从算子级转向计算图级,以提升整体执行效率。Self-Forcing模型采用逐块生成策略,降低计算复杂度。通过torch.compile实现整图编译,消除Graph Break,最终实现约47.6%的加速效果。
10月25日,上海浦东将举办vLLM推理优化实战Meetup,邀请行业专家分享前沿技术与经验,活动包括技术分享、QA互动、开源集市和抽奖,名额有限,欢迎报名参与。
DeepSeek-R1模型通过可验证的过程奖励机制(VSRM)优化推理,减少冗余回复,提高效率。实验表明,VSRM有效抑制无效步骤,鼓励有效步骤,保持模型性能,解决过度思考问题。
WavLM模型在音频处理中的优化包括简化推理过程、ONNX导出和MNN转换,有效解决了模型体积大和推理速度慢的问题。优化后,推理代码减少至60行,模型体积显著减小,便于在资源受限环境中部署。
完成下面两步后,将自动完成登录并继续当前操作。