文章介绍通过OpenSharing实现AWS HealthLake与Databricks集成:自定义OpenSharing服务器以Databricks App运行,借助Lake Formation临时凭证解析Iceberg快照并预签名文件,无需导出或复制数据即可实时查询FHIR数据。数据经Unity Catalog统一治理,支持细粒度权限与审计,并可通过Genie One用自然语言分析临床数据,降低使用门槛。
IBM与Confluent发布Streamhouse数据架构,可实时捕获、处理、治理业务状态,为AI智能体与应用提供受治理的实时数据视图。Confluent平台新增查询能力,Lightning Tables支持直接查询实时流数据,延迟极低,无需复制到独立数据库。该组件已登陆AWS,使平台整合流式传输、连接、处理、治理与实时查询五大能力,支撑Streamhouse搭建。
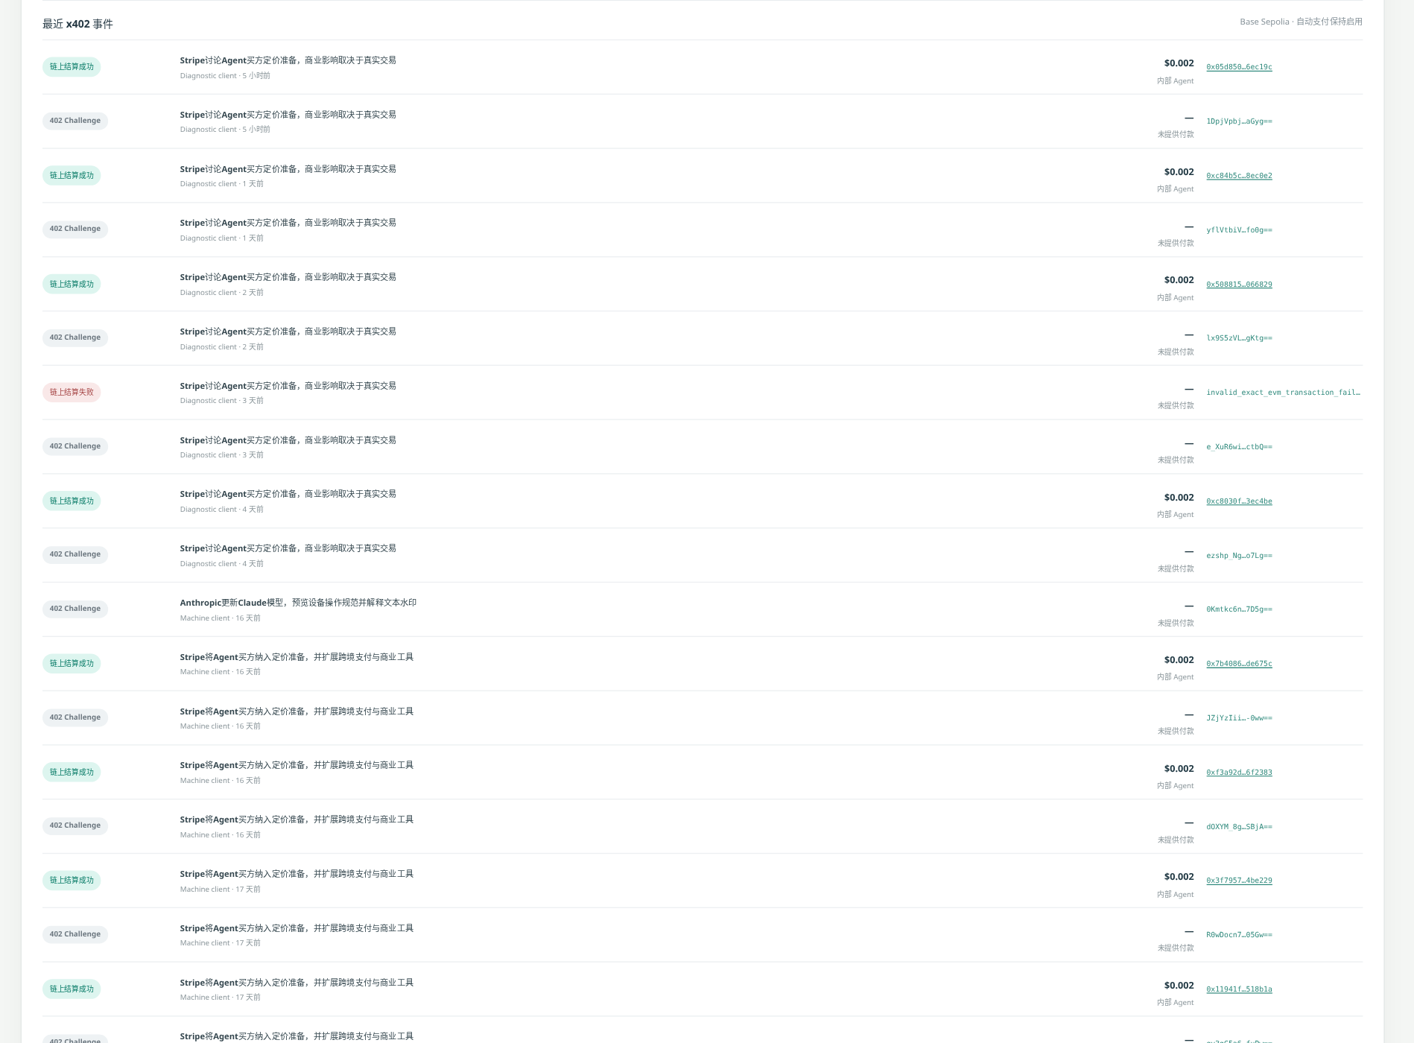
文章介绍将Agent流量转化为数据收入的路径:先用Amazon Bedrock与AgentCore完成电商比价研究,经审核去重后发布;再通过GEO(生成式引擎优化)让内容被AI搜索发现并准确引用;最后用x402协议实现按次付费,让Agent在授权预算内购买机器可读数据。演示中17次测试付款均来自内部地址,证明流程可行,但尚未验证真实客户的付费意愿。
2014年纽约公开1.79亿条出租车数据,车牌经MD5哈希处理。研究员枚举约1700万种车牌并逐一计算哈希比对,还原出真实车牌,还结合照片定位名人行程。问题不在MD5强度,而在输入空间小且哈希无密钥,换SHA-256也无效。正确做法是加盐或密钥哈希(HMAC),且密钥须独立保管;但密钥哈希仅属伪匿名化。教训:先评估熵,再选工具,并考虑攻击者掌握的辅助信息。
IFS Copperleaf 基于 Databricks Genie 构建企业 AI 平台 IONA,整合近 30 个业务系统数据。团队打破传统先建模再查询的做法,仅对财务和营销漏斗精细建模,其余直接交由 AI 处理原始数据,由业务人员定义数据含义。IONA 上线后激活率达 70%,可自动处理访问请求、加速续约决策。其核心是统一业务上下文层,确保各系统对客户等概念定义一致,并支持 Teams、Claude 等多入口访问。
OntoDB能力实证报告显示:本体五件套DDL全部成功;必填、值域、唯一、不相交等约束在写入时即拒错;写入数据自动事实化,INFER可直接产出带规则归因的传递与类层级蕴含;支持中文n-gram子串检索和HNSW向量检索;回包为机器可读JSON,推理行含规则字段,便于Agent消费。测试发现并修复不相交漏检和EXTENDS不可达两个缺陷,回归348/348通过。
亚马逊计划建立“全球商品图谱”,收录全网所有在售商品信息,包括其自身不销售的商品,以减少用户转向Reddit或谷歌进行购物研究,并让AI代理优先依赖其数据。该项目旨在为AI购物助手Alexa for Shopping提供更多数据,解决回答错误和搜索成本高的问题。内部文件显示目标发布日期为2027年10月1日,但亚马逊称此类文件不一定反映当前计划。
Vercel守护进程现可向Vercel Tracing发送OpenTelemetry追踪数据,让用户和代理在项目追踪中查看后台工作进程的运行情况。Vercel为每个守护进程提供Unix套接字接收OTLP/HTTP追踪,路径由环境变量设置。将@vercel/otel升级至2.3.0以上即可自动导出Node.js守护进程追踪,需在工作进程启动前初始化OpenTelemetry。可通过Vercel CLI按服务名搜索并返回JSON。
OpenAI与Databricks合作,使企业能在受治理的数据上使用前沿AI模型,主要通过三种方式:员工借助ChatGPT中的Genie插件,基于公司指标定义自助查询数据并生成图表;Codex经Unity Gateway统一管理,以控制预算并审计请求;OpenAI模型在Unity Catalog治理下于Databricks内运行,支持构建和部署智能体。其核心是将模型能力与企业数据上下文相结合,同时兼顾安全、权限与成本控制。
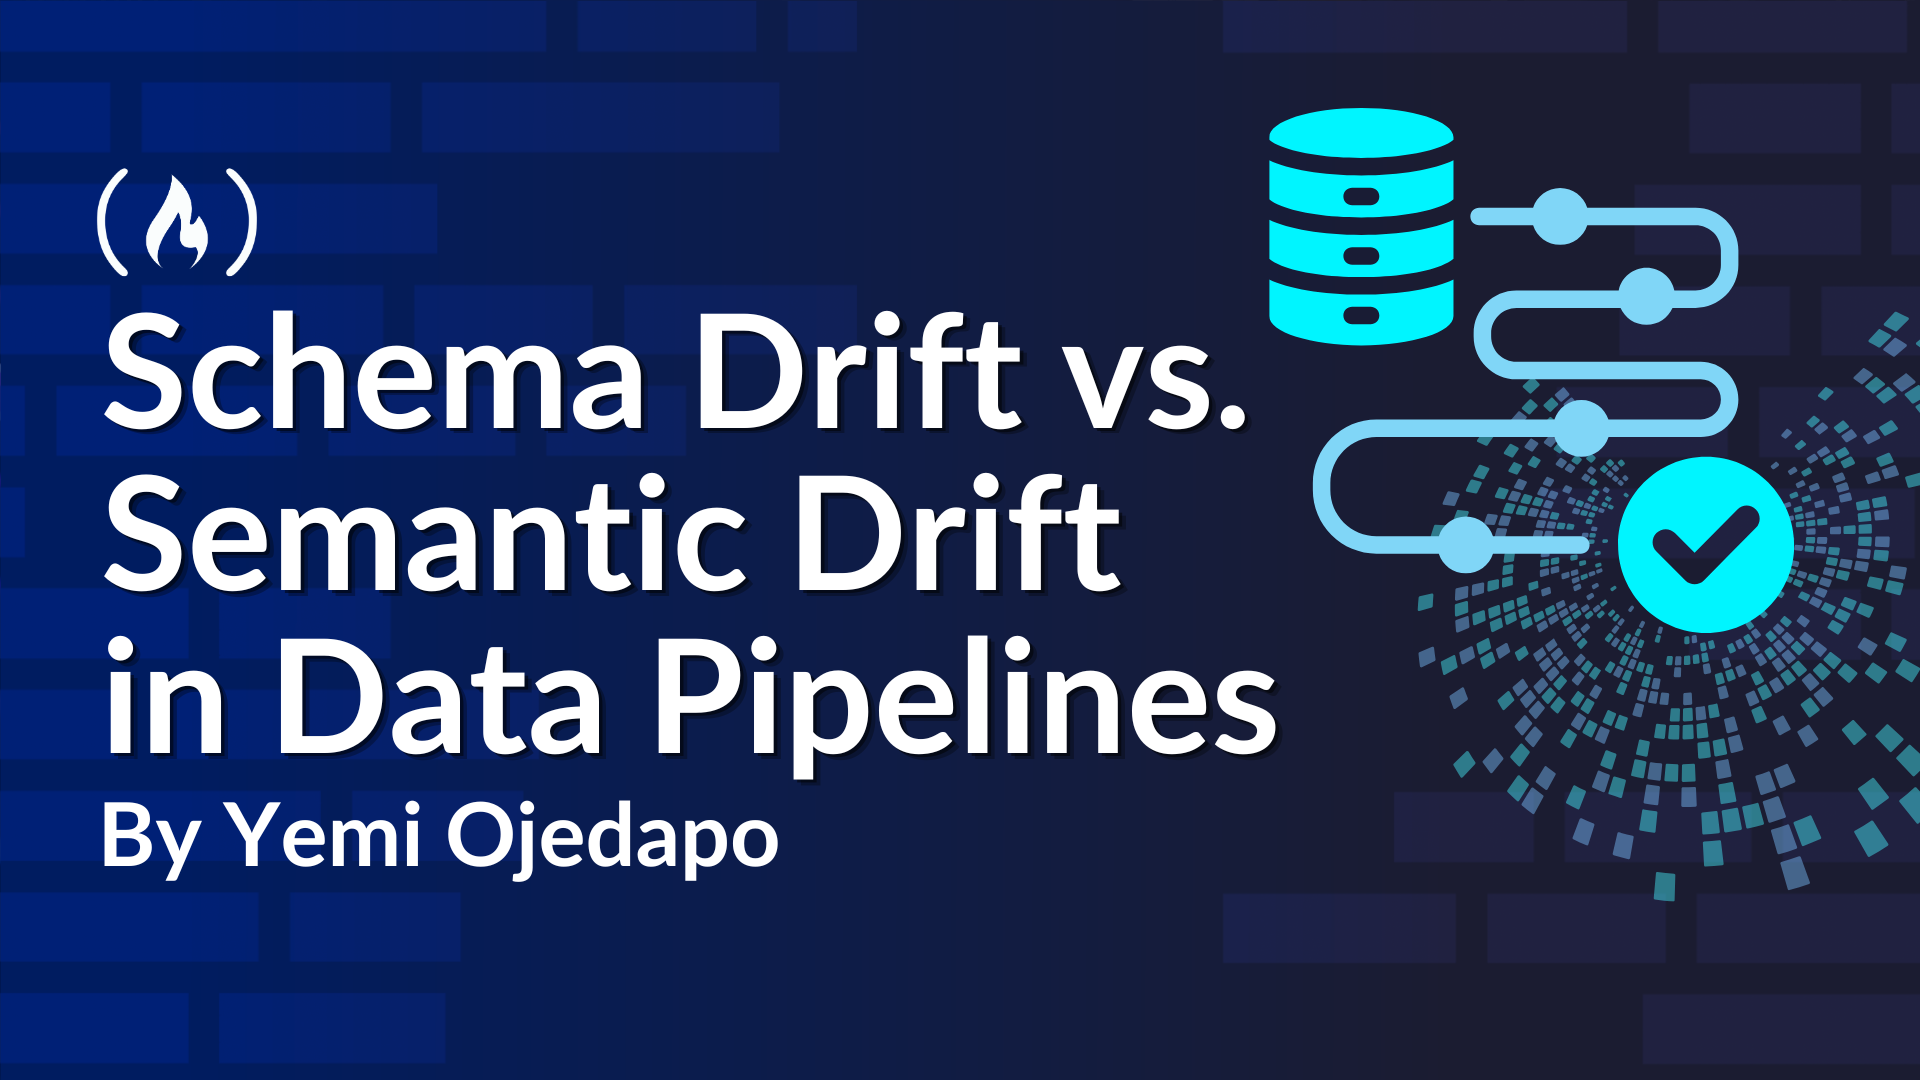
文章通过实验测试四种检测器对九类数据漂移的识别能力:模式差异能发现全部五种结构变化,但漏掉时区偏移、空值变空字符串、耐久度放大十倍等语义漂移,这些变化不改变字段名和类型,管道照常运行却产出错误结果;严格Pydantic模型捕获7/9,统计画像仅2/9。作者建议组合使用多种检测器,并对关键字段设定范围、时区等语义规则,因为管道成功运行并不代表数据正确。
Yandex Cloud数据中心遭乌克兰无人机袭击后,已恢复97.16%的客户数据,其余2.84%因硬件严重损坏且客户未备份而永久丢失。由于备份需额外资源并收费,此前默认未开启。Yandex决定为所有新建虚拟机或云服务器默认开启备份,用户可自行关闭。11月11日启用中部1数据中心可用区F,初期设资源配额。
美国最大核电企业Constellation在Databricks上构建受治理的企业数据平台,核心难题不是选模型,而是统一数据含义:零售、批发、CRM对“客户”定义不同,同一问题出现三个正确答案,收购Calpine后更复杂。平台设三大架构支柱,并落地工程助手、停堆检修协调、销售洞察三类用例,强调语义与治理是AI规模化的基础。
IBM大中华区董事长陈旭东提出,企业AI规模化落地须跨越三道关:一是数据缺乏统一治理或关键环节未数字化;二是系统割裂、设备互联不足,制约AI嵌入研发生产等核心流程;三是AI转型需负责人亲自参与,不能仅靠IT部门。他将AI需求分为经营、运营、管理三类,强调应以高价值场景切入,补齐数据与数字化基础,打通流程,建立统一的模型、数据、智能体及安全合规治理体系。
2026年11月6日,杉岩数据在苏州主办智能制造数据价值与AI应用大会,宣布杉岩IDM升级为工业AI数据管理平台,并发布面向工业质量领域的杉岩琢玉大模型。该模型融合检测图像、生产数据与工艺知识,支持构建缺陷识别、根因分析、质量预警等质量Agent,已在动力电池激光焊接场景实现模型辅助根因定位。杉岩同时推出AI数据湖SandOcean、高性能文件存储SandFS、AI推理加速存储SandKV三款产品,协同提升GPU利用率、降低训练与推理成本。
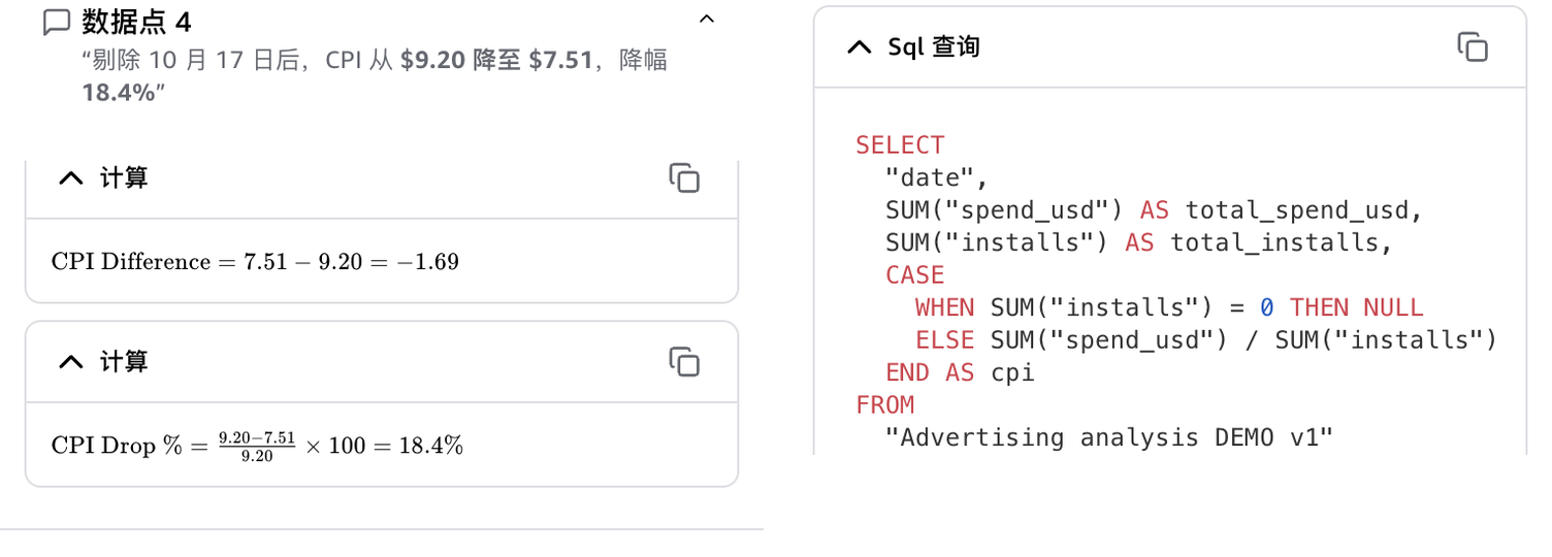
本文介绍基于Amazon Quick的自然语言分析方案,用于游戏出海多平台买量数据分析:运营可在同一对话中从平台总览下钻至广告系列和日期,并查看SQL追溯依据。架构上由AgentCore Gateway统一采集,Harness生成字段适配器,Code Interpreter隔离测试,数据经Normalizer转换后写入S3 Tables,供Quick直接查询,实现可扩展、可审计的多平台投放分析。
AI编程让代码生成更快,也让测试可信度面临挑战。测试数据化将业务规则变成人工可读、机器可执行的独立契约,使AI能够修改实现,同时保留人类对软件行为的控制权。 ## AI编程带来的自动化测试问题 2026年11月11日,Thoughtworks 意大利技术负责人 Matteo Va
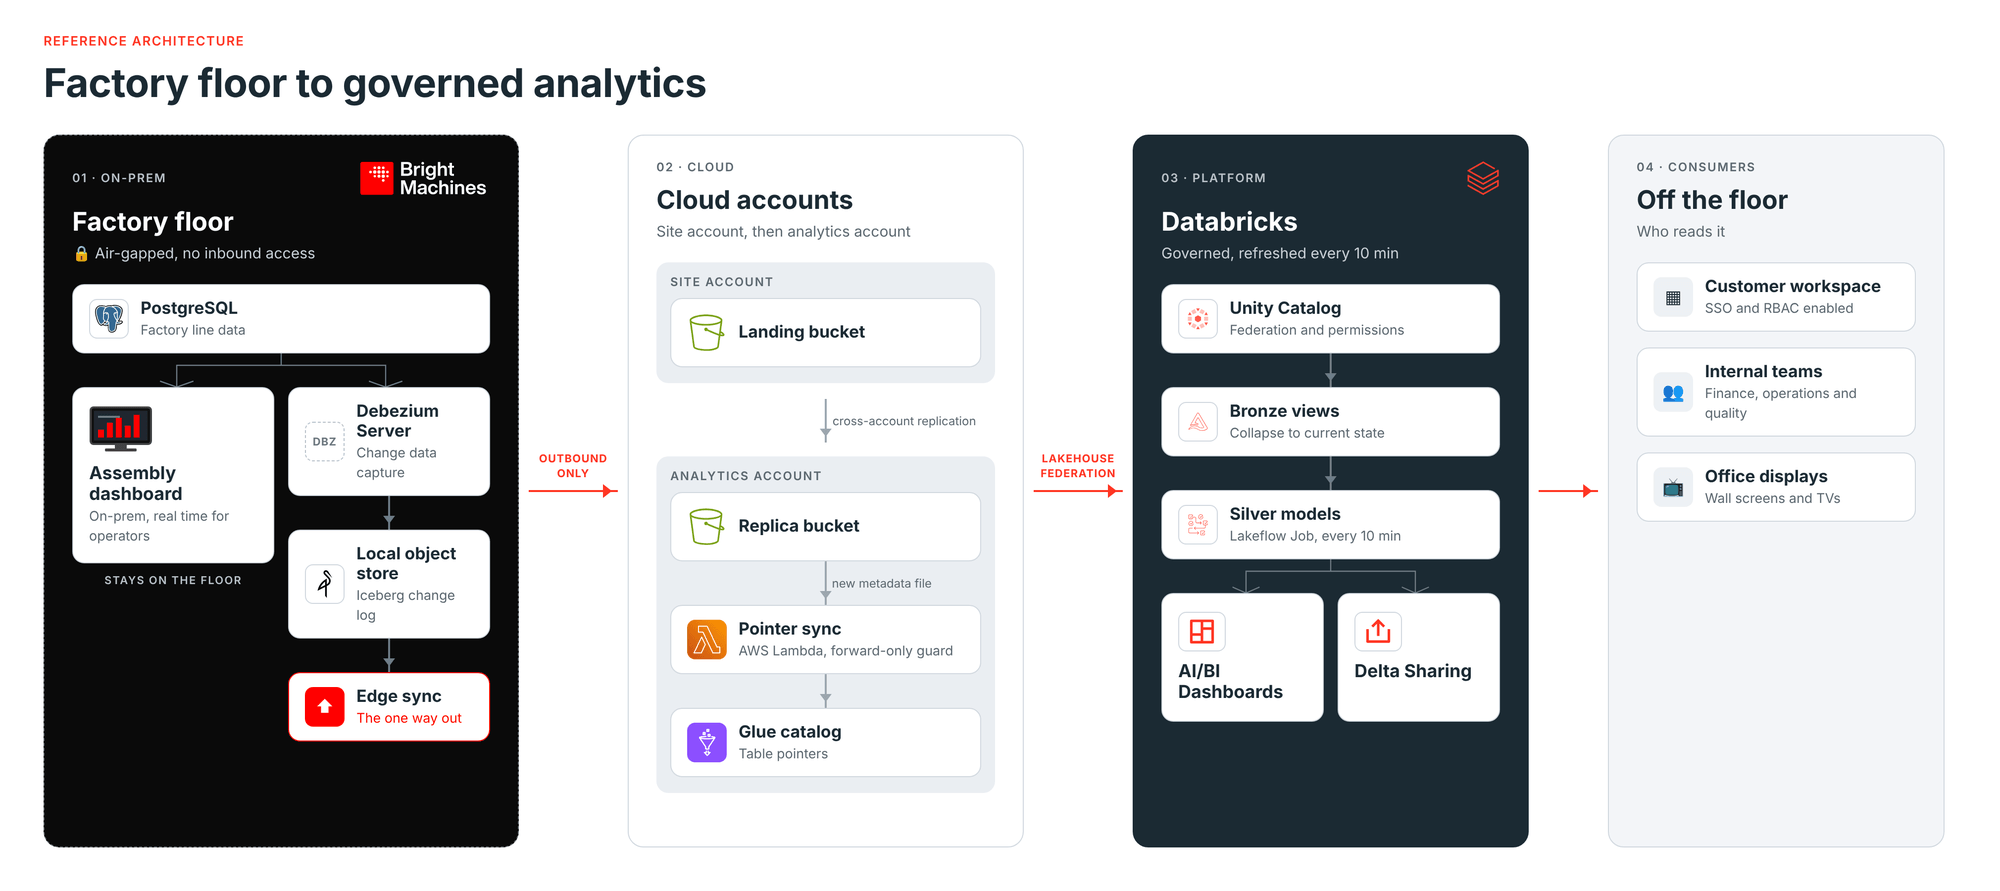
Bright Machines 为气隙工厂设计数据共享方案:在工厂边缘用 Debezium 捕获 PostgreSQL 变更并写入 Apache Iceberg,数据经唯一可审计的出站路径传出,再由 Unity Catalog 联邦读取,无需入站访问。数据约1–2分钟可查,仪表板每10分钟刷新,客户按角色查看受治理数据,首个客户仪表板约两个月上线。
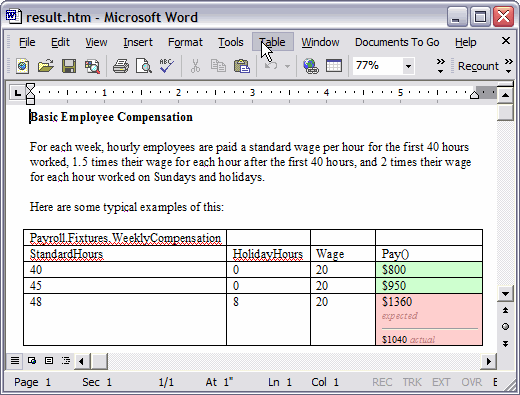
AI编码代理同时生成生产代码和测试代码,导致开发者难以信任测试:测试难读、易随重构变动、常绑定实现细节,甚至可能被AI弱化。作者主张开发者应成为AI的“客户”,以客户测试作为人机契约,并将测试写成数据文件(表格、结构化场景、文本DSL),由AI生成测试运行器,使测试更易读、抗重构、便于审查与保护,还可配合变异测试、属性测试和人工探索测试。
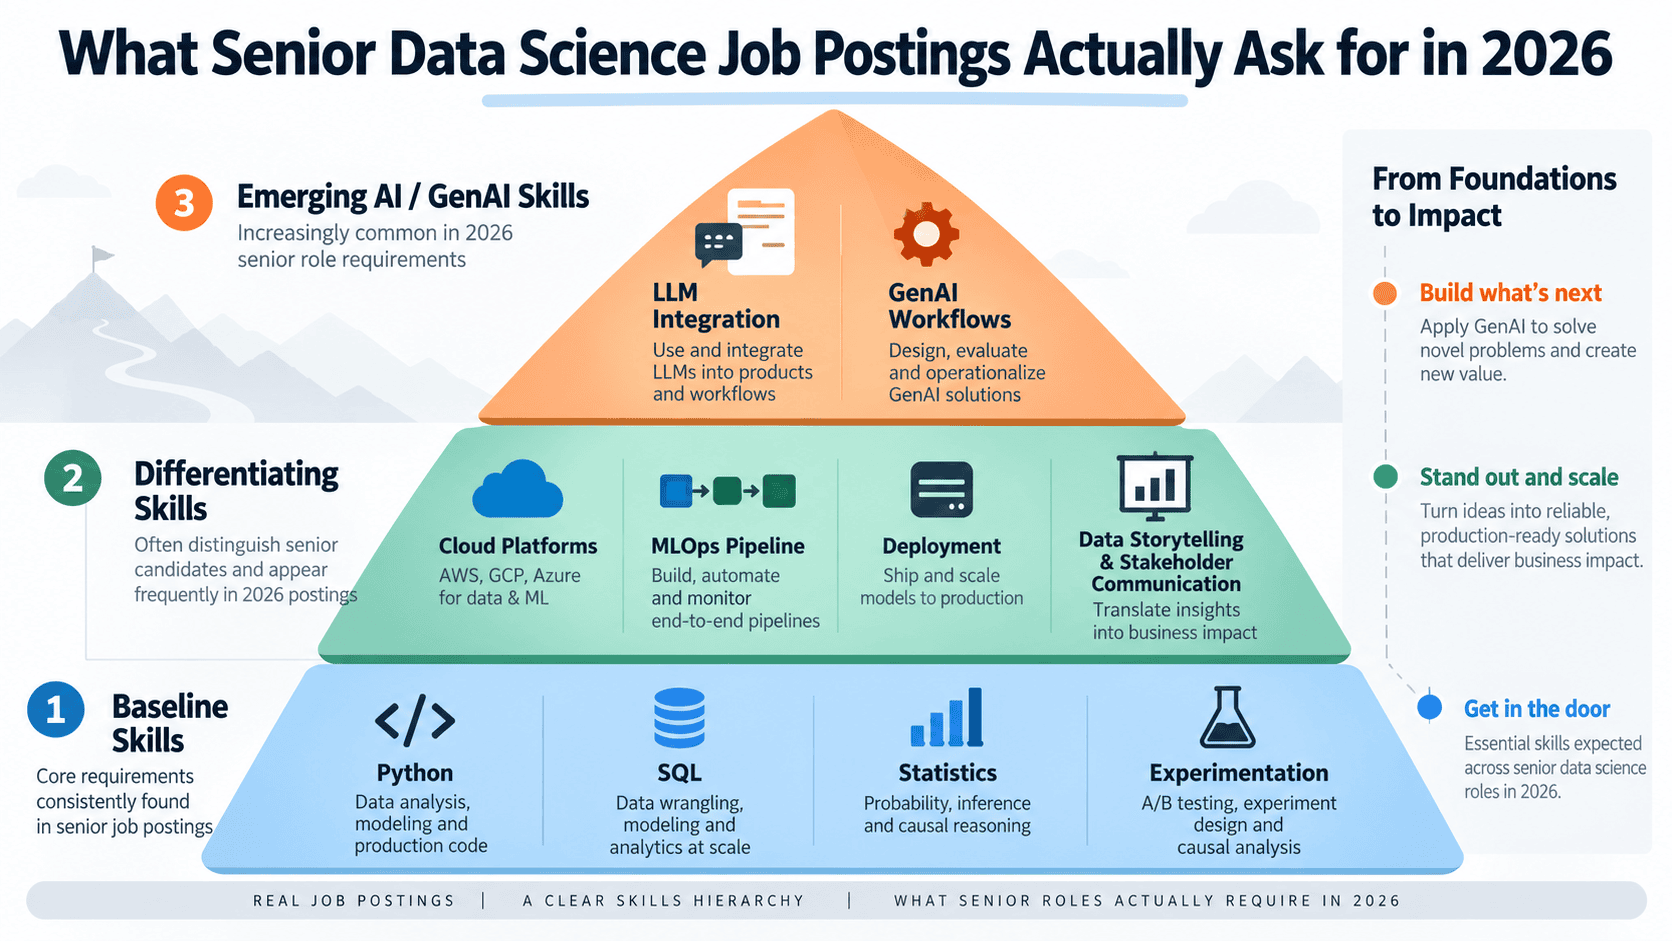
2026年高级数据科学家招聘已超越单纯的建模能力。Python(74%)、SQL(64%)和机器学习(69%)成为基本门槛,并要求具备MLOps、云平台部署(62%)和高级SQL等生产级能力。生成式AI与LLM技能(31%)增长最快,RAG、智能体工作流和提示工程成为新要求。统计深度(58%)与数据叙事(53%)仍受重视。学历要求趋松,作品集比证书更重要。沟通与跨职能影响力是招聘经理最看重、却常被候选人低估的能力。
UnitAutogen 为 PostgreSQL、Supabase 和 Neon 自动生成 pgTAP 测试,测试由代码和模式确定性推导,而非 AI 编写。它提供三类测试:单元测试验证单个函数或触发器各分支行为并自动生成模拟数据;集成测试从根函数出发,覆盖其调用的函数和触发的触发器;数据泄漏测试检查多租户、多用户及 PII 泄漏,涵盖 RLS 策略、列授权、SECURITY DEFINER 函数、视图和触发器。工具还生成覆盖率与安全报告,可集成 CI。免费版含单元测试,团队版增加集成测试,企业版含安全覆盖与 PII 审计。
完成下面两步后,将自动完成登录并继续当前操作。