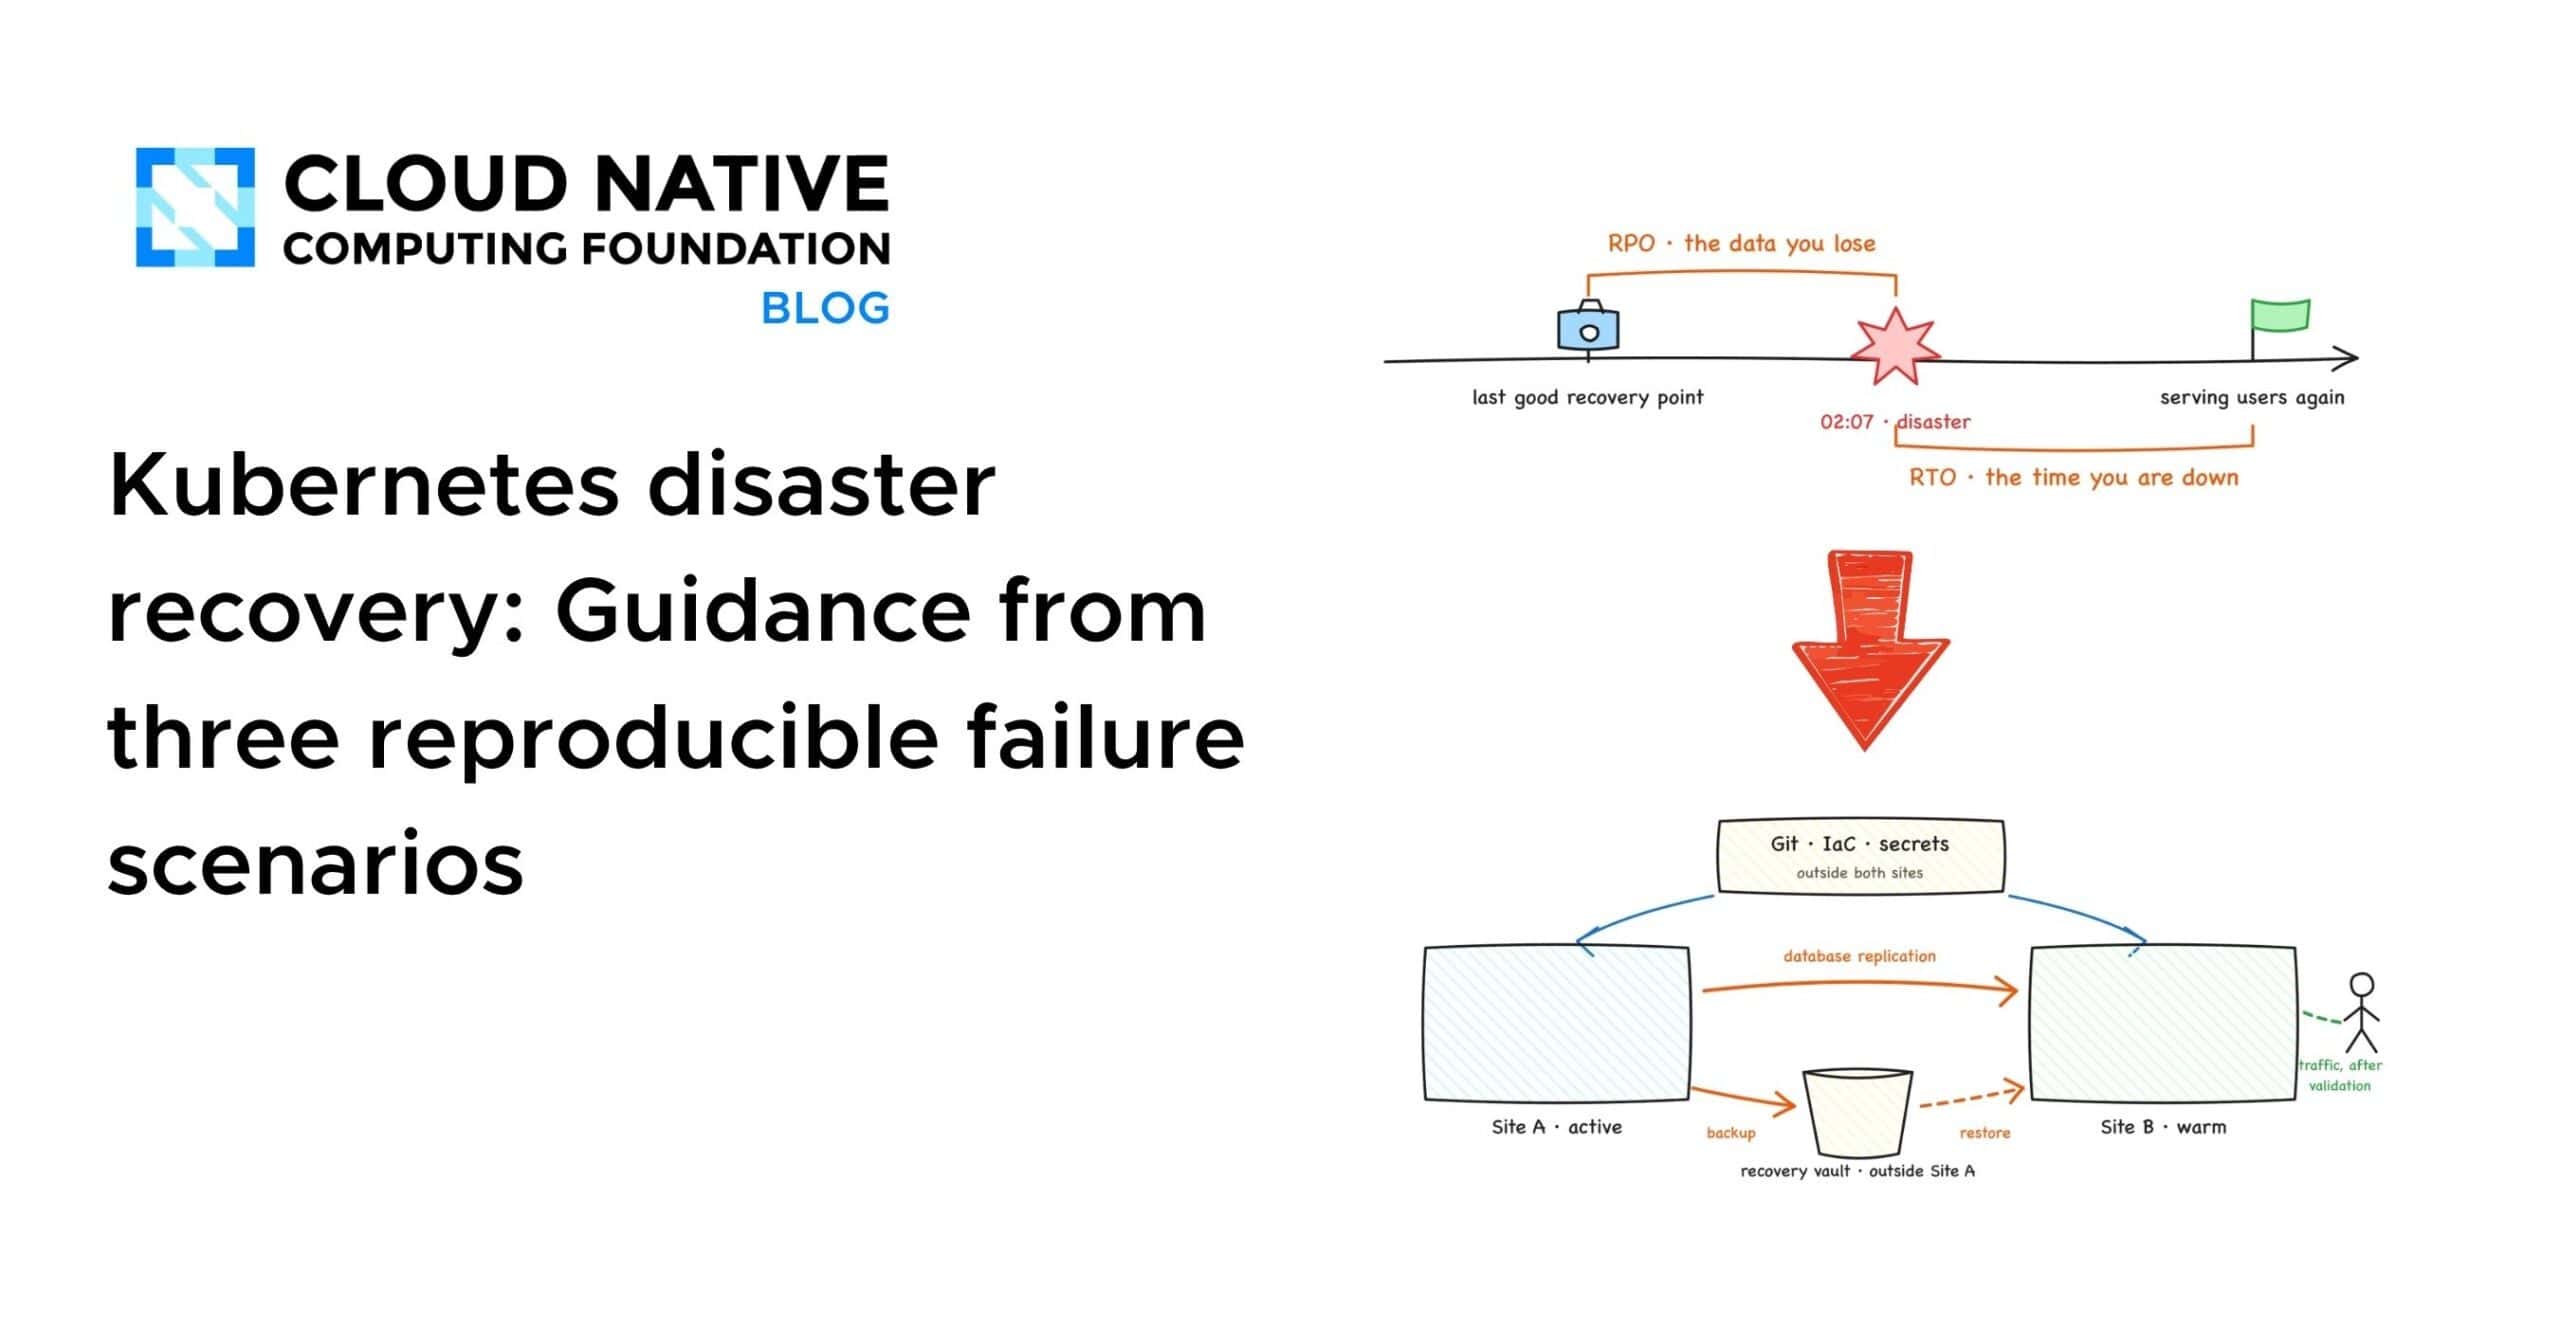
备份不等于灾难恢复。三个可复现实验表明:备份完成不代表数据可用,需验证卷数据已迁移;GitOps仅恢复声明状态,存储数据须靠备份还原;多卷应用单独快照会产生时间偏差导致数据不一致,需用VolumeGroupSnapshot保证一致性。恢复测试应还原完整应用、校验数据并计时。
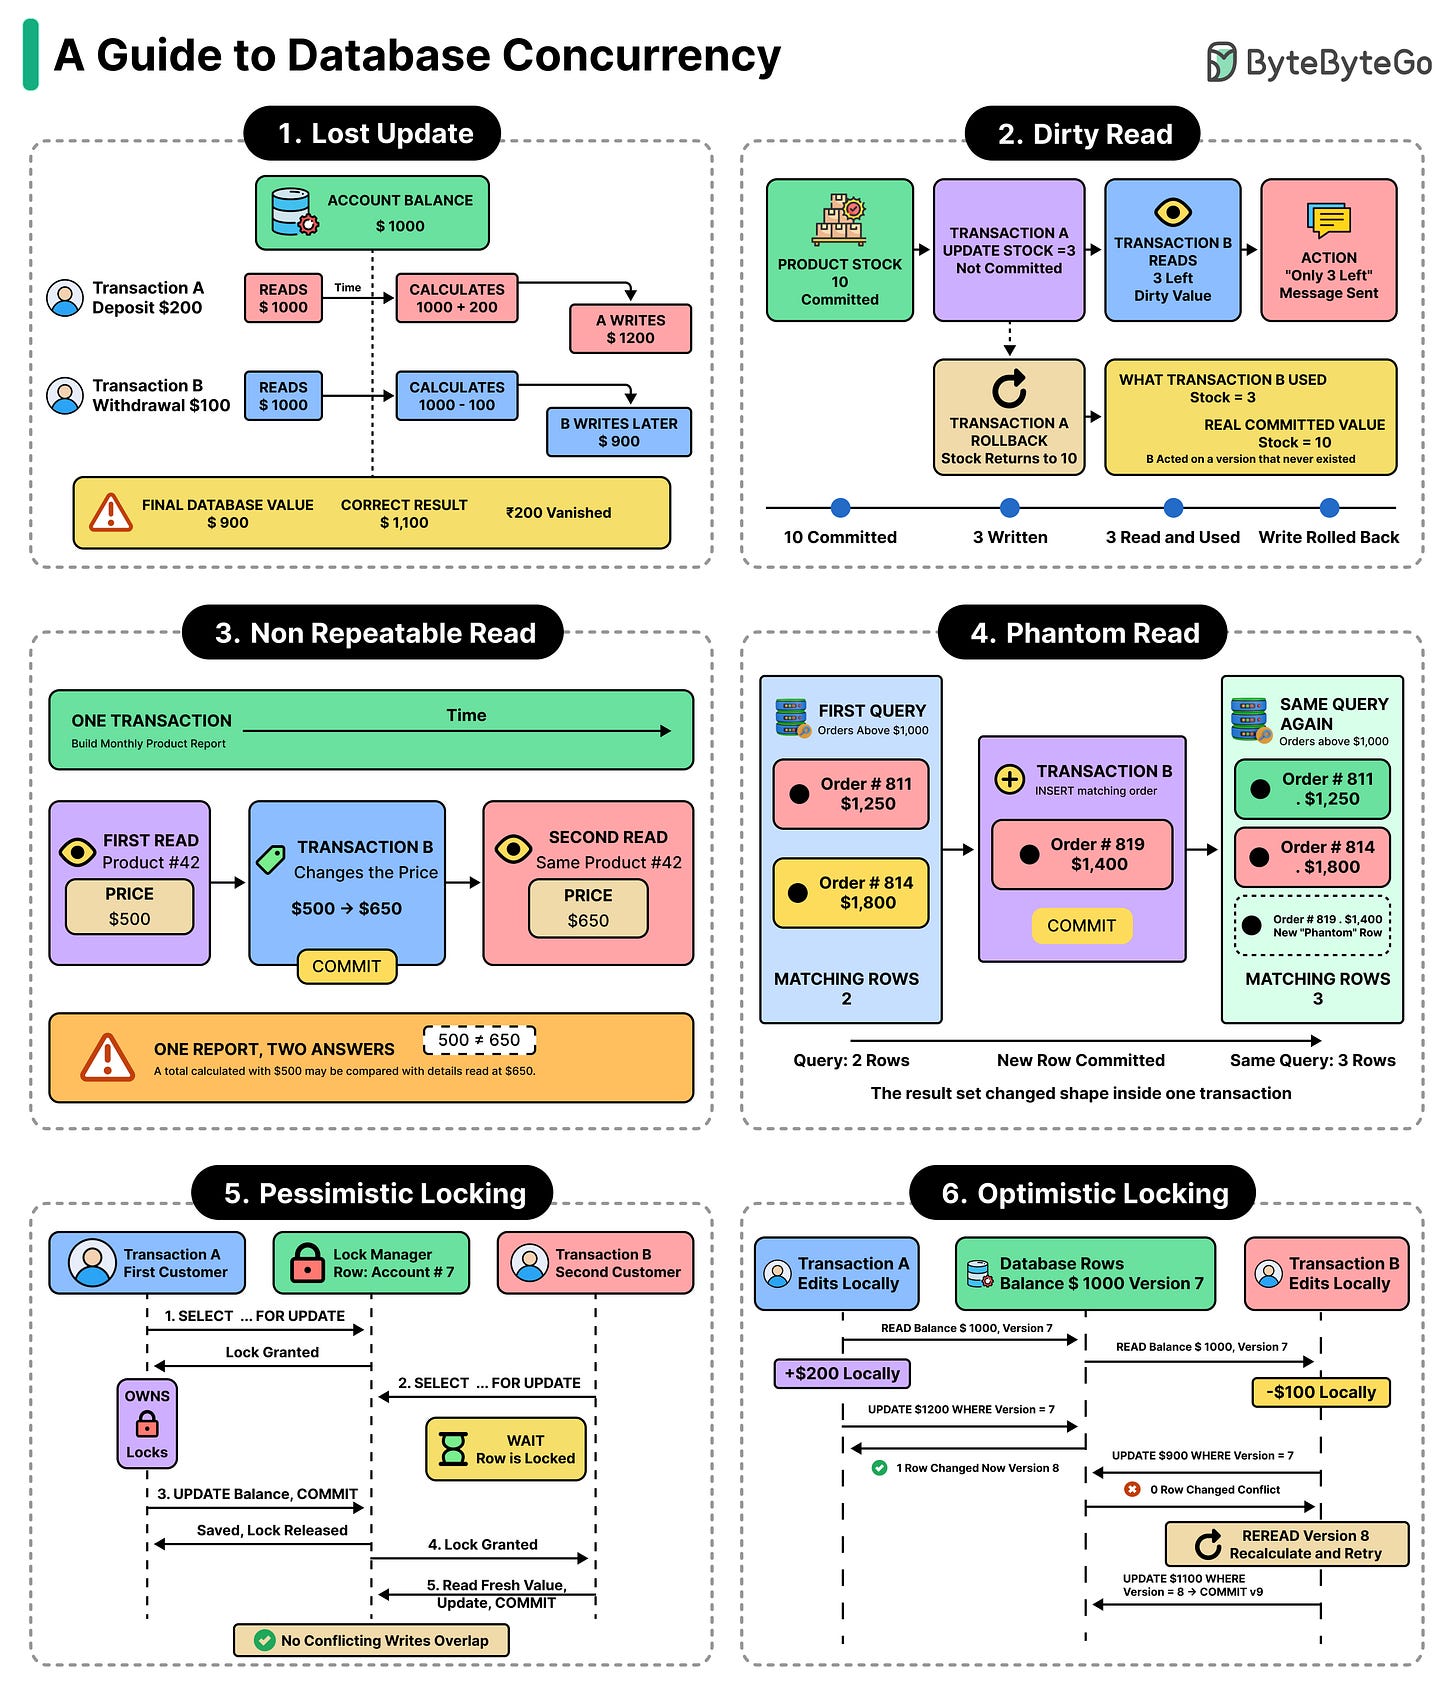
数据库通过并发控制防止数据损坏。文章以银行账户为例,说明两个并发取款事务重叠导致余额错误($90而非$80),指出重叠事务是常态。解决方案包括悲观锁(提前阻塞)和乐观锁(事后检查),并引入隔离级别平衡安全与性能,使最安全设置可用。
PostgreSQL 19新增WAIT FOR LSN命令,用于解决副本读取延迟问题。应用可在写入后获取LSN,并在副本上等待该位置重放完成后再读取,确保数据一致性。相比固定延迟或主库读取,此方法更精准高效,但需注意超时预算、连接池限制及框架兼容性。实测显示,WAIT FOR将延迟降至毫秒级,且正确率100%。
AI应用扩展至自主代理时,数据层一致性成为关键。异步复制延迟会导致代理基于过时数据决策,引发“幻觉债务”。文章提出三种复制模式:强一致性(如Aurora DSQL)用于高安全数据,条件写入(如DynamoDB)防并发覆盖,高吞吐(如Keyspaces)保实时流处理。架构师需匹配复制模型与任务需求,确保AI决策基于同步真实数据。
本文介绍WiredTiger的Rollback to Stable(RTS)机制:当stable时间戳落后于durable或存在未提交事务时,RTS扫描表并移除不稳定修改,保留稳定版本。它跳过logged表,需独占数据库,完成后常执行checkpoint。RTS通过时间聚合减少读页,并处理History Store中的不稳定条目,确保恢复后数据一致性。
本文讨论了FoundationDB的确定性模拟测试,重点在于通过模拟器测试网络、磁盘、时钟和随机数接口。模拟器使用事件队列驱动,确保恢复路径的可重放性。通过故障注入和Buggify技术,验证系统在故障情况下的恢复能力。文章强调模拟测试与生产环境的差异,以及其在确保数据一致性和恢复能力方面的重要性。
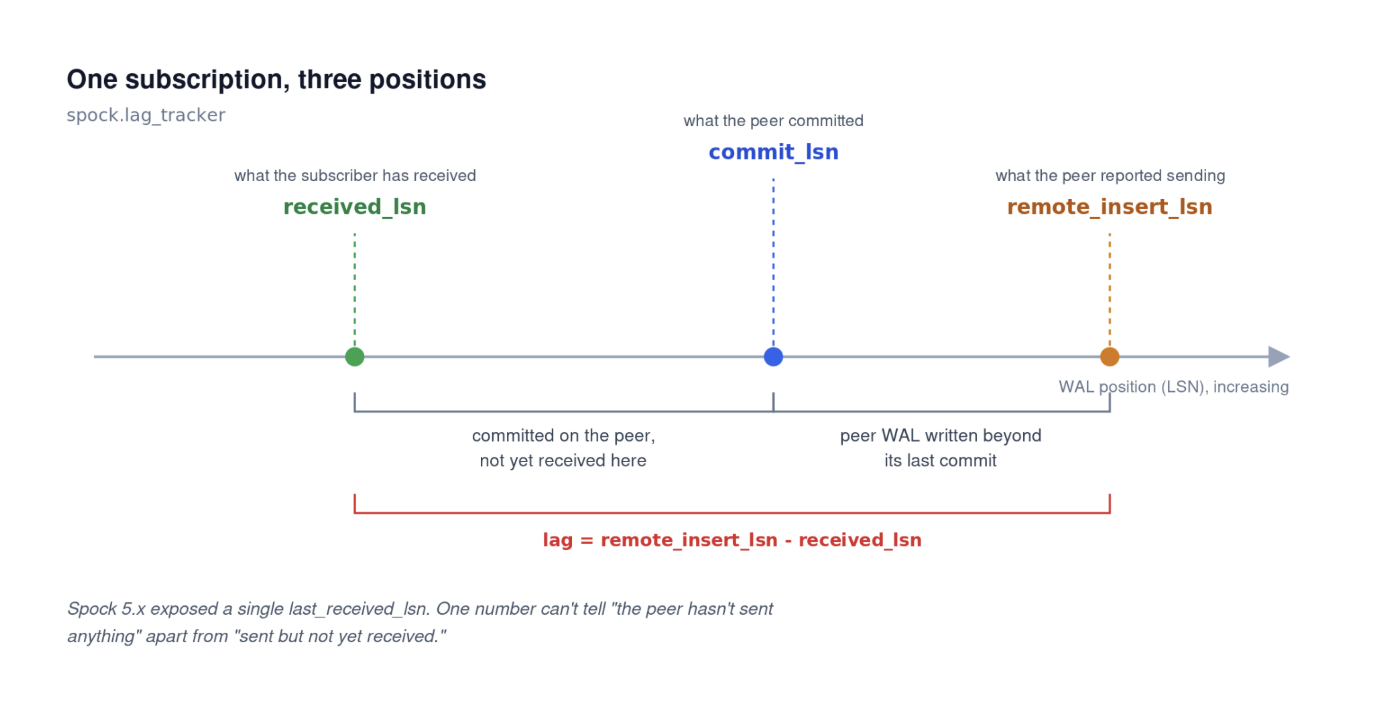
pgEdge ColdFront推出的Spock 6支持PostgreSQL 16至19的多主复制,显著提升性能并降低存储成本。新版本优化了事务进度跟踪,减少I/O争用,增强了异常处理和冲突检测,支持无停机升级,简化了集群管理。同时,改进了数据一致性和恢复机制,确保故障后准确重建复制状态。
TiFlash通过Raft Learner角色接收TiKV日志,实现行存到列存的转换,保持物理隔离和强一致性。其存储引擎DeltaTree分为Delta和Stable两层,优化写入和读取性能。TiFlash的读路径通过ReadIndex确认复制进度,确保数据一致性。存算分离架构允许独立扩展存储和计算资源,提升查询效率。
本文讨论了TiFlash中的safe-ts机制,确保数据读取的一致性和可见性。safe-ts是一个时间戳,表示所有提交的事务已在TiFlash副本上完成。可见时延通常在亚秒级,由日志复制、应用和锁解析等因素决定。TiDB与TiFlash结合实现了准实时的快照一致性,而非最终一致性。文章还探讨了故障场景下的新鲜度退化及主动接受陈旧数据的选项。
Redis 的异步复制模型可能导致副本读取到旧数据。主库通过 replication.c 向副本广播命令,副本在断连期间仍可提供陈旧数据。配置参数如 repl-backlog-size 和 replica-read-only 会影响复制行为。理解这些特性有助于优化 Redis 的使用和故障处理。
S&P Global利用Amazon FSx和NetApp ONTAP实施了一种创新的灾难恢复解决方案,确保在区域故障时15分钟内实现只读模式的快速切换。该方案通过SnapMirror复制和FlexClone技术保持数据一致性,支持金融服务的业务连续性,降低基础设施成本,并满足合规要求。
Redis 是一个高效的实时数据平台,提供低延迟的缓存层,适用于 AI 工作负载和大规模应用。其分布式缓存和一致性哈希技术确保数据均匀分布,提升系统性能。在设计缓存层时,需要关注数据一致性、故障处理和扩展策略,以避免性能下降和数据过时。
将工作流状态与业务数据存储在同一Postgres数据库中,可以通过数据库事务解决分布式系统中的数据一致性问题。这种方法确保所有更新在同一事务中处理,避免复杂的幂等性检查和出站箱维护,从而降低系统复杂度和故障率,利用事务的原子性确保状态更新的一致性,简化系统设计。
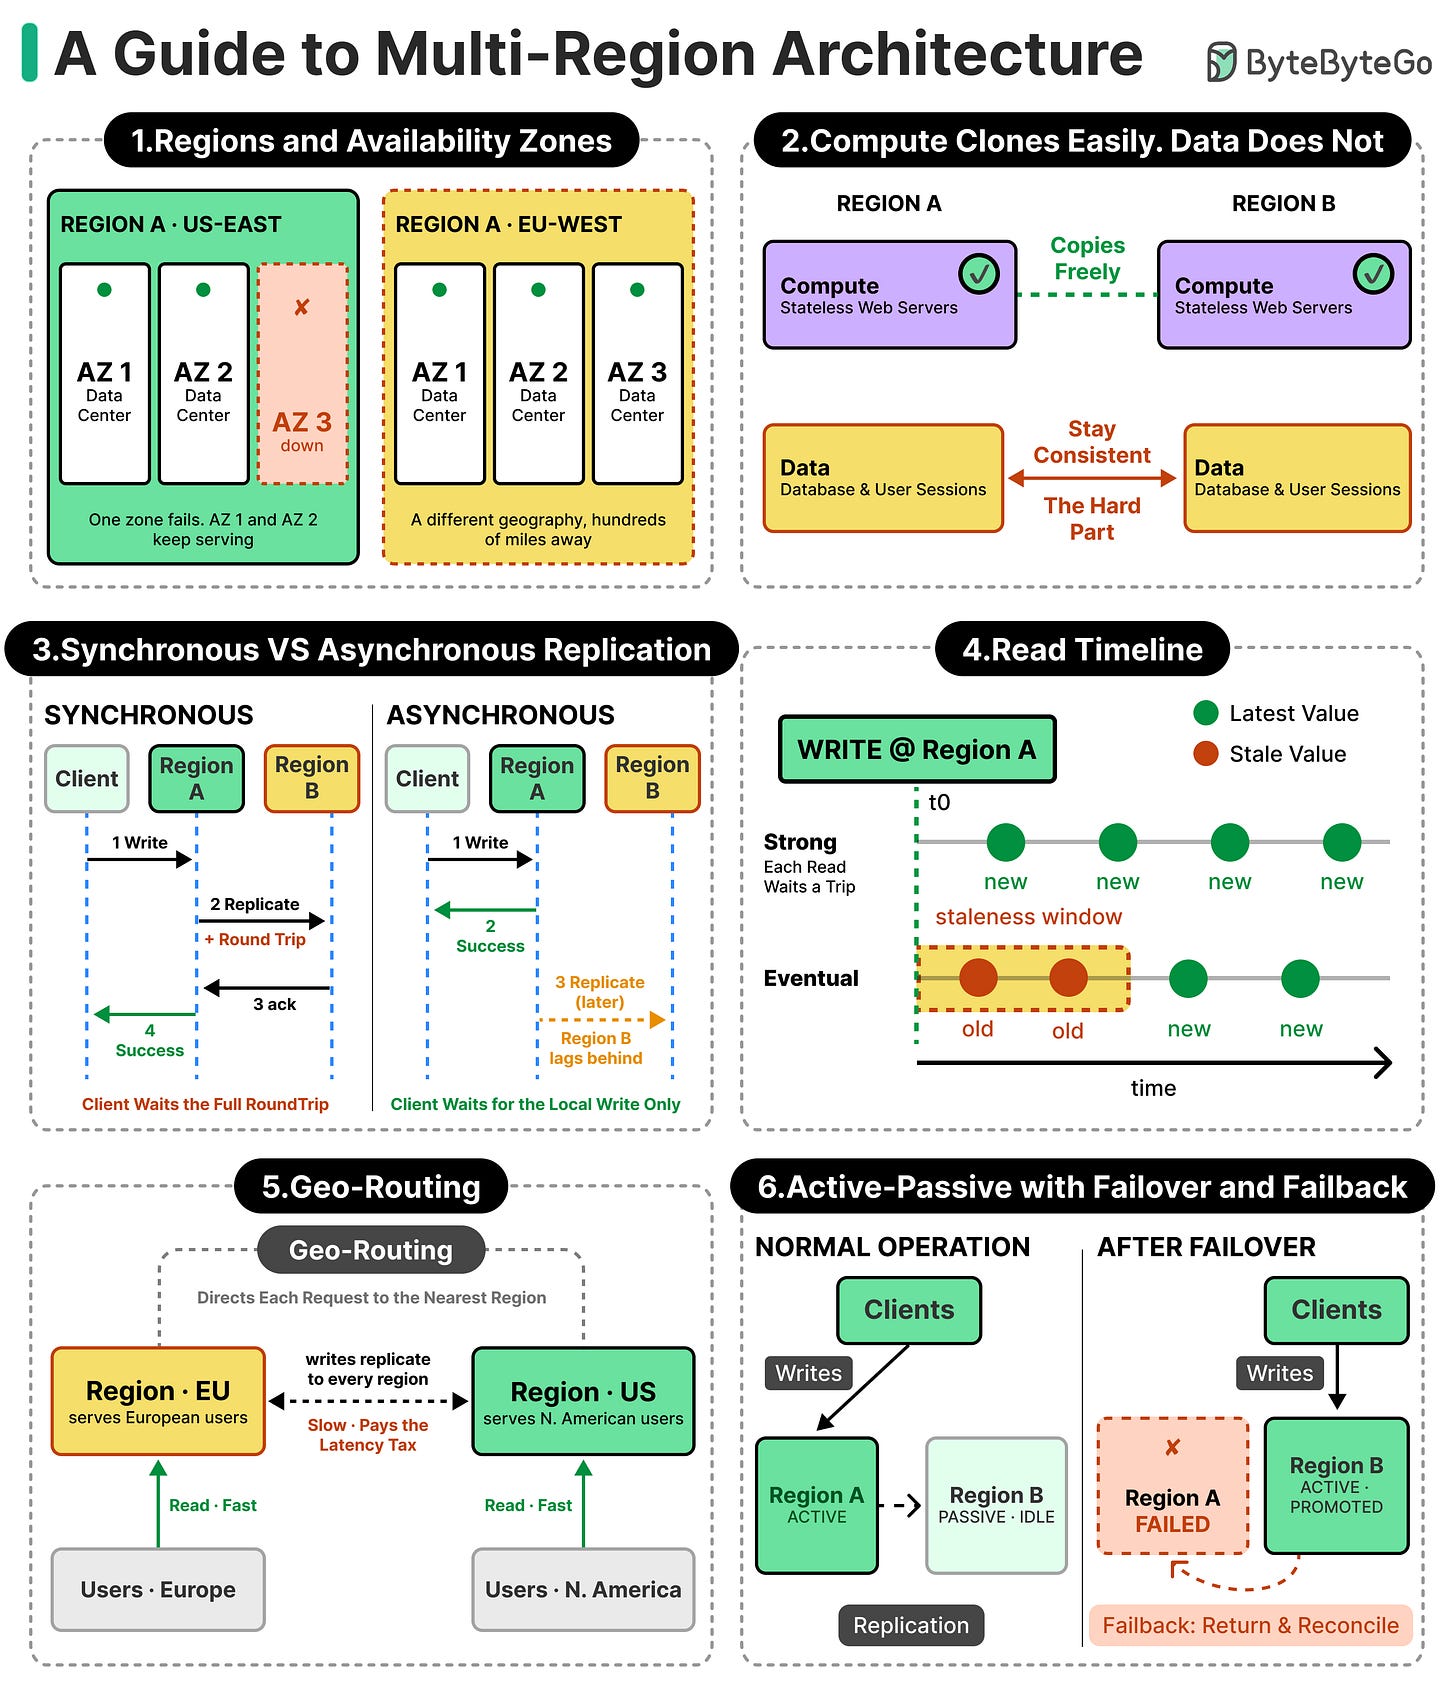
多区域架构可以提升应用的延迟和可用性,但可能导致数据一致性问题。不同地区的服务器可能对同一数据进行不同编辑,造成版本冲突。全球扩展应视为渐进过程,每一步都有成本和收益。
本文讨论了Flink中的两阶段提交(2PC)协议,强调在流式数据处理中实现“仅一次”交付语义的重要性。通过将外部写入分为“预提交”和“提交”两个阶段,确保在全局快照完成后才对外可见,从而避免数据重复或丢失。文章还分析了Kafka和Iceberg的具体实现及其在不同失败场景下的处理策略,以确保数据的一致性和可靠性。
亚马逊EKS通过自动化管理etcd生命周期和优化存储机制,提升了大规模Kubernetes集群控制平面的韧性和性能。新架构支持快速状态变化的工作负载,确保高可用性和数据一致性。此外,EKS推出了可预留的控制平面,以满足客户在高负载下的资源需求,确保稳定性和效率。
本文讨论了AI代理在生产环境中的上下文工程与提示工程的重要性。提示工程关注如何指导模型,而上下文工程则涉及信息管理。文章指出,许多问题源于数据的新鲜度和一致性,而非提示本身。Redis Iris被介绍为实时上下文引擎,旨在提高数据整合和响应速度,帮助代理在多个会话中保持一致性。
本文介绍了 ClickHouse 的 ReplicatedMergeTree 引擎及其与协调服务(如 ZooKeeper 和 ClickHouse Keeper)的关系。该引擎通过日志和副本机制实现数据一致性,支持多副本写入和同步。文章详细描述了副本架构、写入与同步过程、恢复机制及其与 Distributed 引擎的关系,强调了系统监控和运维的重要性。
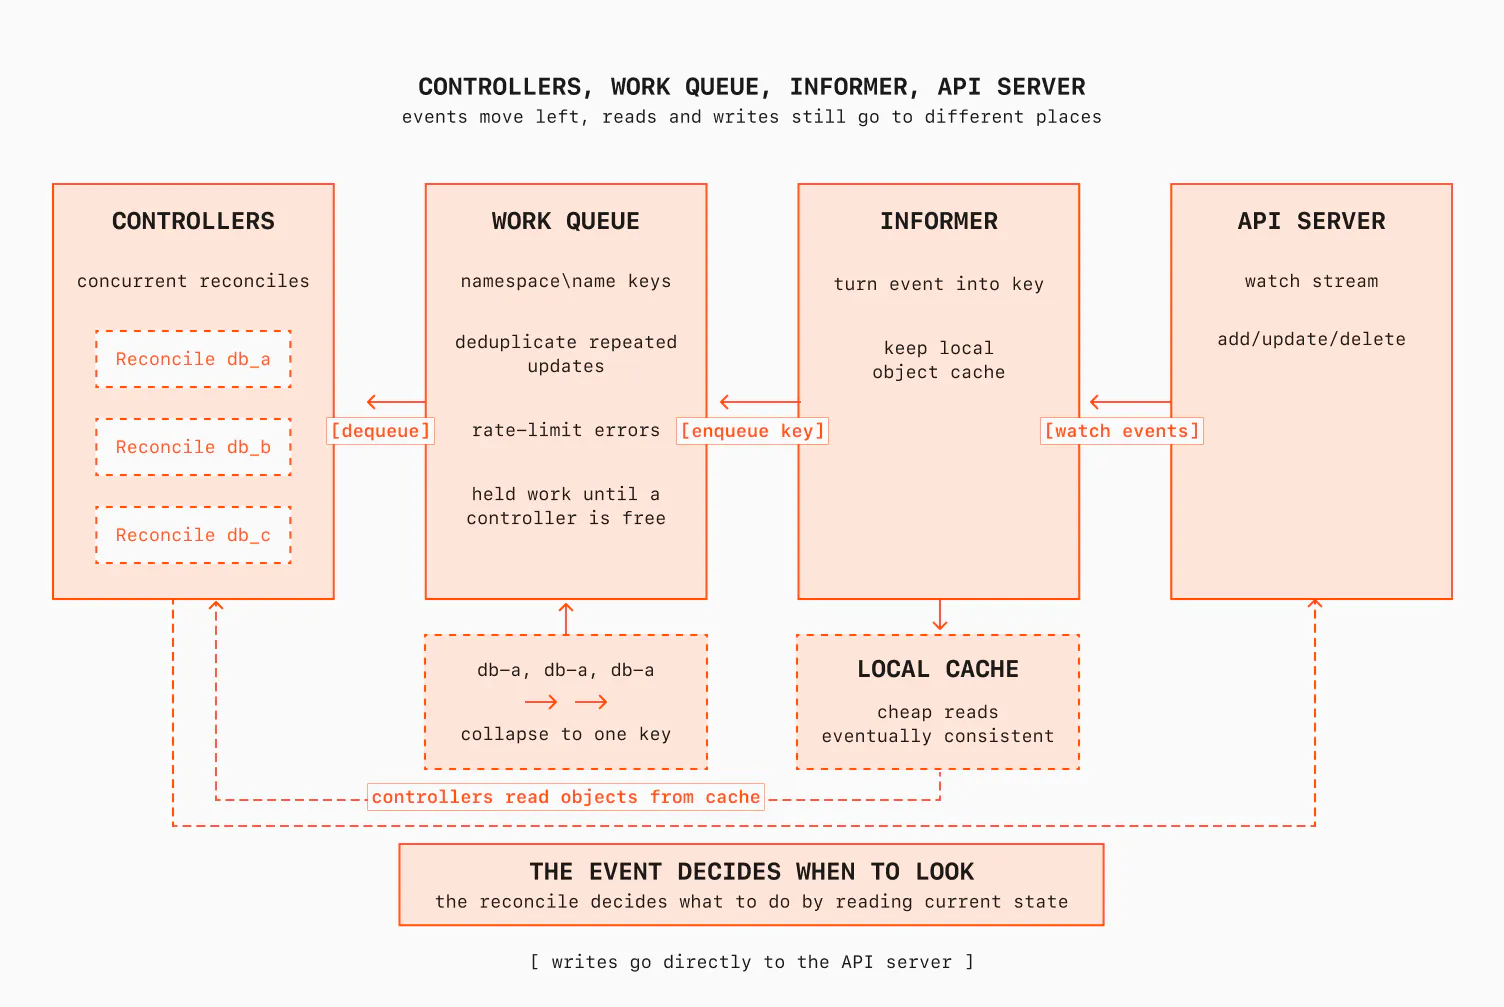
Kubernetes通过反馈控制机制有效管理大规模工作负载。文章探讨了如何手动运行Postgres数据库,并将其映射到Kubernetes的控制器模型。控制器通过观察当前状态与期望状态的差异,自动调整系统,确保高可用性和数据一致性,简化了操作过程。
本文讨论了统一命名空间(UNS)在数据建模中的重要性,强调其对数据流动和标签管理的影响。通过将身份管理与命名空间分离,避免了宽表模式带来的问题,采用窄表模式和外键关系,确保数据的持久性和一致性,保护历史数据不受设备和系统变更的影响。
完成下面两步后,将自动完成登录并继续当前操作。