小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
沉浸式翻译 immersive translate
Dify.AI
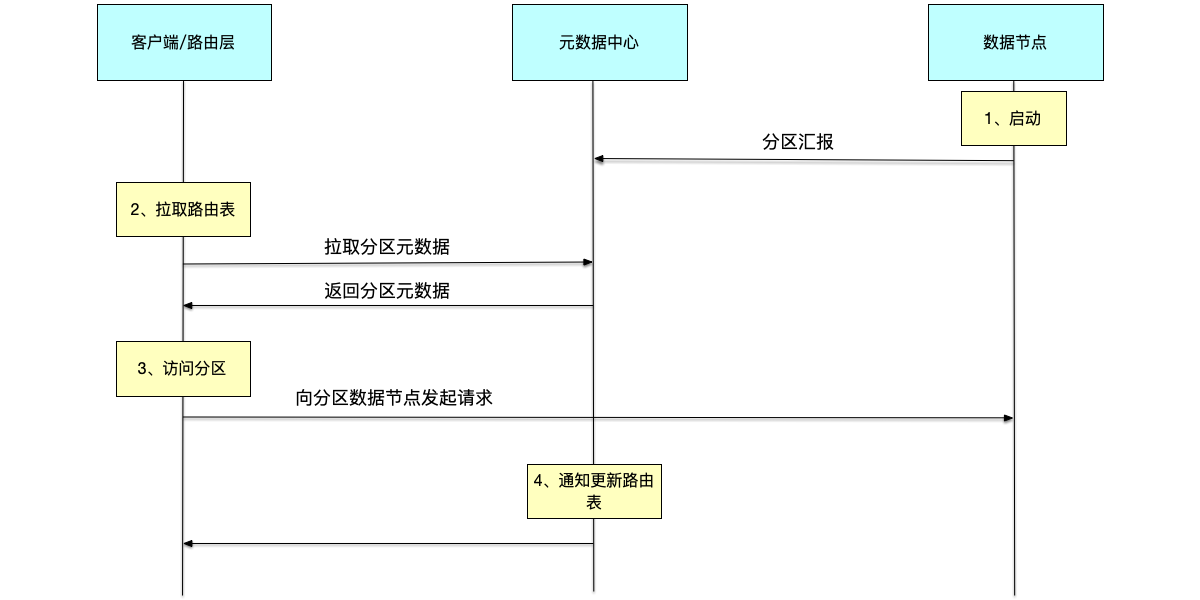
第六章:分区

本文讨论了分布式系统中的数据存储扩展策略,比较了垂直扩展和水平扩展的优缺点。垂直扩展简单但存在单点故障风险,而水平扩展通过数据分区提高可用性。范围分区适合顺序查询但可能导致数据倾斜,哈希分区则均衡负载但牺牲顺序查询能力。文章还探讨了数据迁移和请求路由机制,强调在动态环境中保持数据一致性的重要性。

第六章:分区

codedump的网络日志 codedump的网络日志 · 2026-03-29T00:00:00Z
Amazon Aurora DSQL 在 IOT 场景下的应用和实践

随着物联网技术的发展,Amazon Aurora DSQL通过自动数据分区和动态扩缩容,满足数据激增需求。其分布式架构确保高可用性和一致性,实现全自动化运维,帮助企业专注于业务创新,适用于高并发、大容量场景,提升数据处理效率,降低运维成本。

Amazon Aurora DSQL 在 IOT 场景下的应用和实践

亚马逊AWS官方博客 亚马逊AWS官方博客 · 2025-09-23T05:57:03Z
应对海量数据:为何仅仅购买更大硬盘无法解决问题

大规模应用需处理PB级数据,单个硬盘无法满足。通过数据分区和一致性哈希,避免单点故障,将用户数据分散到多个数据库,提高性能和可靠性。增加服务器时,仅需迁移受影响的数据,确保系统稳定运行。

应对海量数据:为何仅仅购买更大硬盘无法解决问题

DEV Community DEV Community · 2025-05-09T01:57:39Z
🧩 垂直分区与水平分区:大型系统如何在规模上管理数据

随着系统规模扩大,数据管理变得重要。数据分区是提升性能和可扩展性的关键策略,包括垂直分区和水平分区。垂直分区将特定列移入独立表,适合特定属性访问;水平分区按行拆分表,适合大规模系统。分区可实现水平扩展和性能提升,但需注意复杂查询和数据分布不均的问题。

🧩 垂直分区与水平分区:大型系统如何在规模上管理数据

DEV Community DEV Community · 2025-05-02T13:11:15Z

本文讨论了Hive SQL的性能优化技巧,包括查询优化、数据分区和索引使用等。通过合理策略和案例,开发人员可以显著提升查询效率,解决大数据环境中的性能瓶颈。

大数据从业者必知必会的Hive SQL调优技巧

京东科技开发者 京东科技开发者 · 2025-04-30T08:37:59Z
InsightFlow 第8部分:在InsightFlow中设置AWS Athena进行数据分析

本文介绍了如何在InsightFlow项目中设置Amazon Athena,以便从S3高效查询和分析数据。Athena是一种无服务器的交互式查询服务,支持多种数据格式。通过数据分区和Glue数据目录,InsightFlow优化了零售销售和燃料价格的趋势分析。

InsightFlow 第8部分:在InsightFlow中设置AWS Athena进行数据分析

DEV Community DEV Community · 2025-04-29T03:27:07Z
数据库优化:分区与索引

文章讨论了数据分区和索引的概念。水平分区将大表按区域分布到多个存储节点,垂直分区则根据访问模式分离敏感数据。分区提高了可扩展性、管理性和查询性能。索引通过创建查找结构加速数据检索,优化查询路径,确保数据一致性。

数据库优化:分区与索引

DEV Community DEV Community · 2025-04-13T00:33:36Z
理解数据分区与数据分片:有效数据管理的关键概念

数据分区和数据分片在数据管理中有不同的含义。数据分区是将数据集逻辑上划分为更小的部分,以提高单一系统的查询性能;而数据分片则是将数据水平分布到多个物理节点,以实现扩展性和容错性。分区通常用于单一数据库,分片适用于分布式系统。两者可以结合使用,以优化性能和扩展性。

理解数据分区与数据分片:有效数据管理的关键概念

DEV Community DEV Community · 2024-12-18T16:21:38Z

本文讨论了Hive SQL的性能优化技巧,包括查询优化、数据分区、索引和数据加载等。通过合理策略和案例,开发人员可以显著提高查询效率,减少资源浪费,确保大数据分析的高效性。

大数据从业者必知必会的Hive SQL调优技巧

京东科技开发者 京东科技开发者 · 2024-11-22T08:27:20Z

本文探讨了Hive SQL的性能优化技巧,包括查询优化、数据分区和索引使用等。通过合理策略和案例,开发人员可以显著提高查询效率,减少资源浪费,改善执行时间和内存消耗。

大数据从业者必知必会的Hive SQL调优技巧

京东科技开发者 京东科技开发者 · 2024-11-11T02:34:35Z

Apache Iceberg是一个数据湖表格格式,旨在解决大规模数据湖的问题,将其转变为数据仓库。它允许模式演化、时间旅行查询和高效的数据分区,与现有数据处理引擎兼容。metadata.json是核心组成部分,用于管理表格元数据。

理解 Apache Iceberg 的 metadata.json 文件

DEV Community DEV Community · 2024-08-21T15:49:34Z
十亿级超大表数据库注入 Amazon S3 数据湖的实践

本文介绍了使用AWS DMS将超大表注入到S3数据湖中,并利用Amazon Athena优化查询性能。通过数据分区提高查询效率和降低费用。详细介绍了架构和构建步骤,提供了先决条件。演示了如何处理Oracle数据库中超过10亿行的超大表,将数据注入到S3数据湖中,并对数据进行分区,改善业务体验。

十亿级超大表数据库注入 Amazon S3 数据湖的实践

亚马逊AWS官方博客 亚马逊AWS官方博客 · 2023-09-13T02:37:44Z
  • <<
  • <
  • 1 (current)
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。

1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码