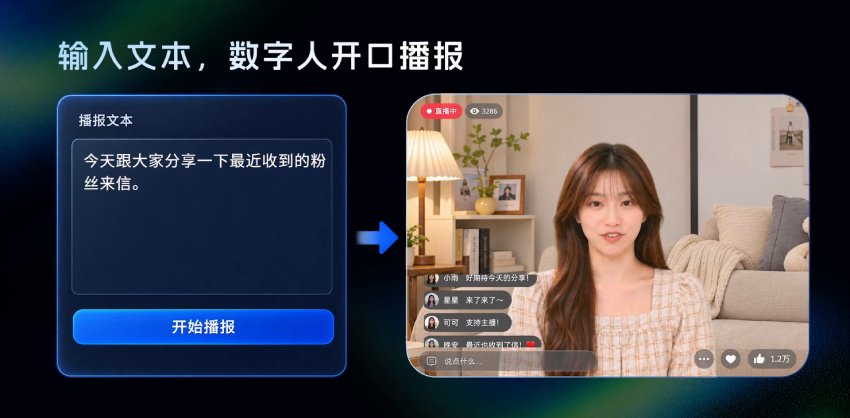
即构科技升级数字人直播能力:支持文本驱动播报,并借助大模型实时改稿回应弹幕评论,形成互动闭环;新增透明背景叠加,数字人可直接嵌入现有直播间或网页,降低搭建成本;直播流可转推抖音、快手、YouTube、TikTok等国内外平台,适配电商、社交、教育场景,缓解真人主播难以长期稳定出镜的问题。
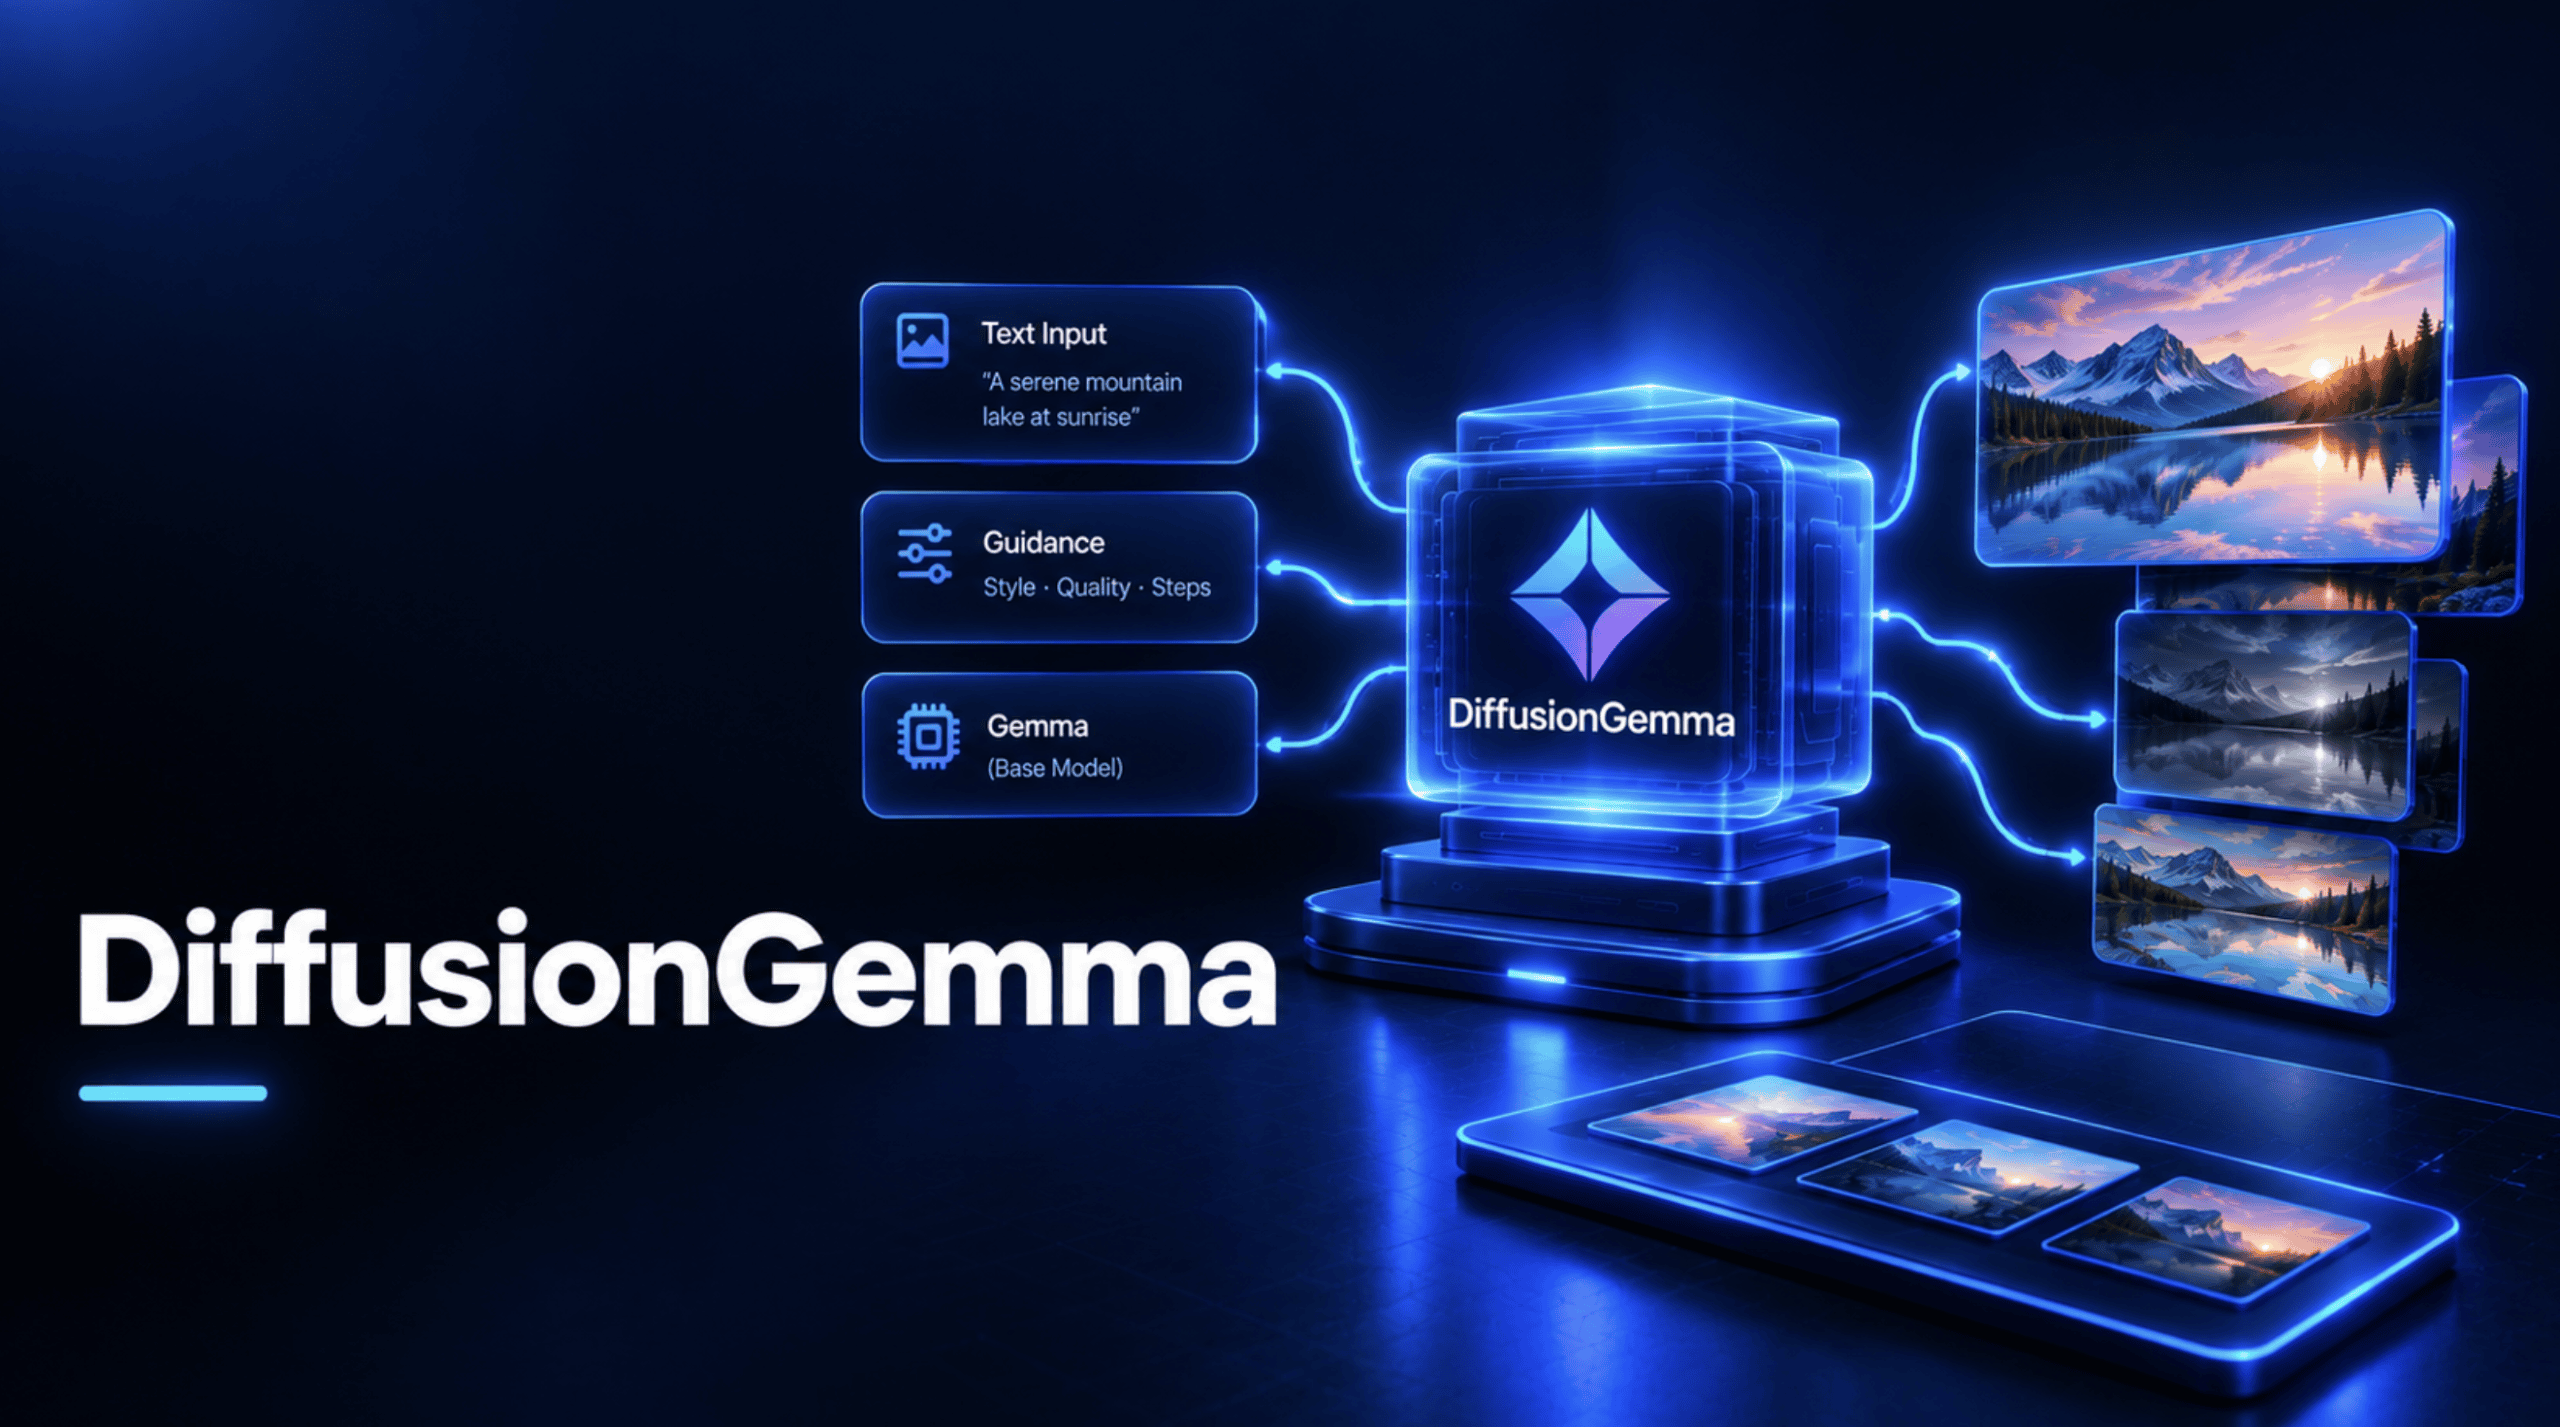
Google DeepMind发布实验性开源文本模型DiffusionGemma,基于Gemma 4 26B混合专家架构,采用扩散式并行生成:每次对256个占位token的画布同时去噪,而非逐token自回归,将瓶颈从内存带宽转向计算,并支持自我纠错。模型支持文本、图像、视频输入,量化后可在18GB显存消费级GPU运行,内置思考模式。文章演示了用Transformers加载、生成、观察去噪过程及vLLM部署,并介绍推荐采样参数。
Soniox 发布语音转文本 API Soniox STT v6,包含流式 stt-rt-v6 和异步 stt-async-v6,支持 60 多种语言。核心创新是智能体文本输入:将智能体回复文字同步送入模型,提升短回复识别并过滤泄漏的智能体回声,但不替代声学回声消除。语音输入、会议转写等也有改进。流式价格 $0.12/小时,含说话人分离。v6 尚无独立基准数据,v5 将于 2026 年 12 月 15 日退役。
论文指出,长上下文检索失败的主因并非长度,而是争抢同一键的竞争信息。126,473次试验中,中性填充下准确率保持0.97–1.00,换成同格式竞争陈述后跌至0.11–0.21,且每多一个对手损失叠加。注意力质量比长度更能预测失败,遮蔽实验也曾误将退化归因于长度。工程上应控制同键冲突条数而非总长度。
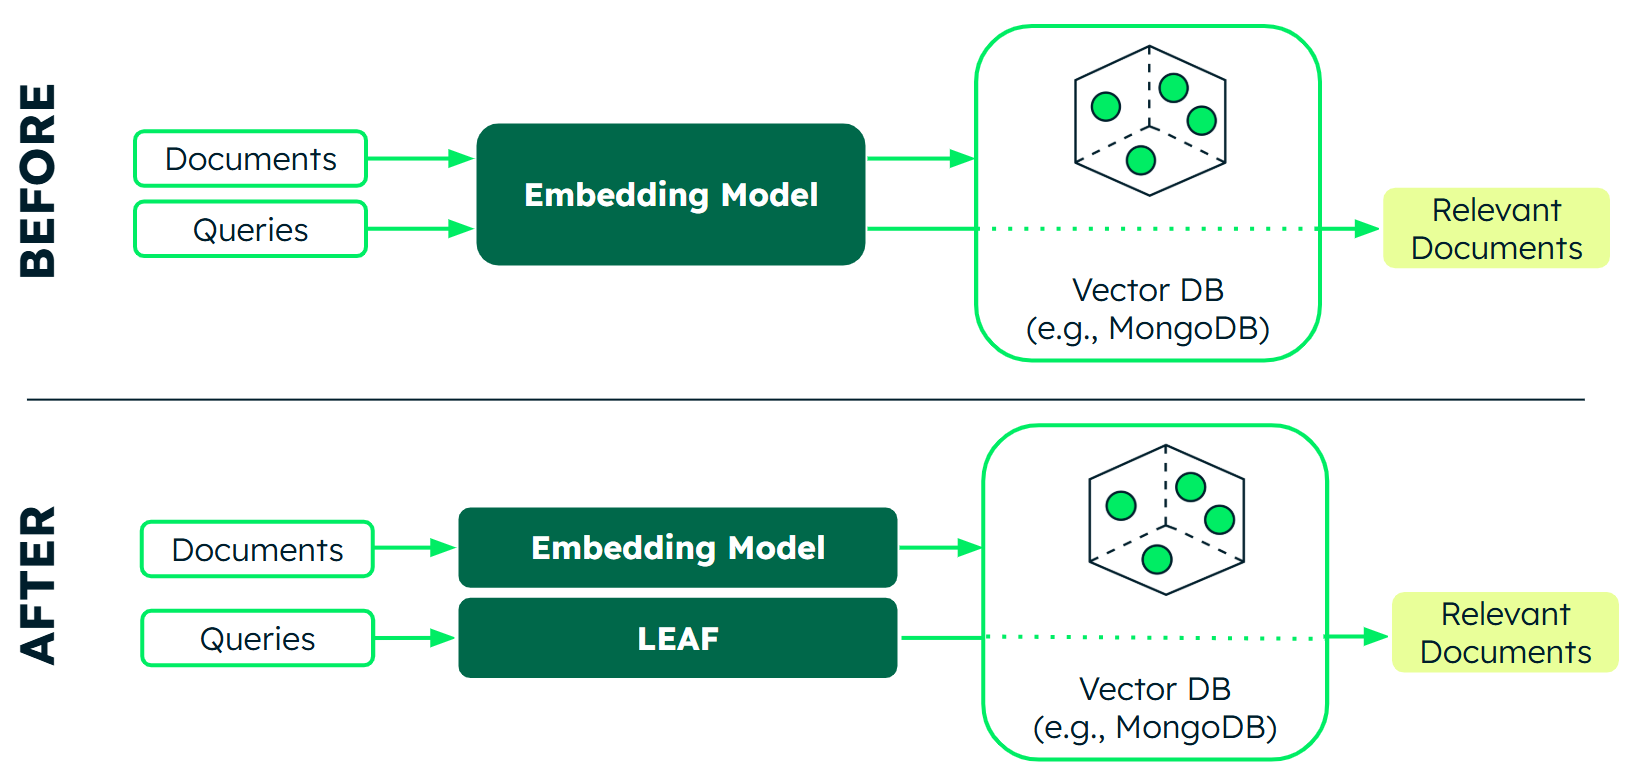
MongoDB Research 提出 LEAF 知识蒸馏框架,可将大型文本嵌入模型压缩为小型学生模型,且学生与教师模型嵌入空间兼容,便于非对称部署。基于此发布两个2300万参数模型:mdbr-leaf-ir 专注检索与RAG,mdbr-leaf-mt 面向分类、聚类等通用任务。二者可在纯CPU、物联网和移动设备上运行,性能保留教师模型最高97%,体积小5–15倍、速度快7–24倍,并以 Apache 2.0 开源。
Grok API 自2026年11月7日起默认在文本输出中添加盲水印,以满足欧盟AI法案要求,但覆盖全球用户。水印通过调整Token选择形成统计特征,不增加可见或隐藏字符,检测准确性随文本长度提高。非欧盟用户或产品不面向欧盟者可在控制台团队设置中关闭水印,约5分钟生效。
每八篇论文就有一篇是AI写的,但真正的问题在审稿人手里 一篇论文能被引用,靠的是有人读完后觉得它值得引用;一篇论文能被发表,靠的是审稿人读完后觉得它值得发表。2026年的一项统计给出了一个让人坐不住的数:生物医学论文里每八篇就有一篇含有
第 1 篇画链路的时候,画到这一行就收住了: async for ev in project_stream(agent_manager, agent_id, request, ...): yield ev 当时我说「project_stream 是这里的分界线:往里是 harness 的地盘,往外是 Octop 的地盘」。这篇把它拆开。 顺带把...
斯坦福新算法让AI打腹稿,速度翻三十一倍! 斯坦福下一概念建模论文让文本生成先搭骨架再填肉,摘要任务速度提升三十一倍,质量持平扩散模型,一亿参数验证待规模化。 ## 逐词生成被当成铁律,但斯坦福拿数据打了脸 所有主流大模型都在干同一件事:一个字一个字往外蹦。GPT如此,Claude如此,DeepSeek也如此。这
作者在福柯百岁诞辰之际记录感触,读瓦莱里《台特斯先生》时被其词语世界与自我醒悟震撼,认为未完成文本或许最好。随后买菜,观察菜市场的“附近性”与日常出口,谈及社会戾气与女性刚需困扰,并反思项目沟通成本与信息对等,晚上参加朋友生日聚餐。
Fish Audio 发布文本转语音模型 Drama 3,采用 35B 混合专家架构,每 token 激活约 3B 参数,权重开放。支持 83 种语言、16 个说话人及自然语言表演指令。发音鲁棒性测试得分 93.2%,精确序列为 86.3%。自托管需 48GB 以上 NVIDIA 显存,API 定价每百万字符 50 美元,年营收 50 万美元以下可免费商用。
Databricks 内部应用 Slide Hub 基于 Lakebase Postgres 实现混合搜索,结合向量检索与 BM25 关键词检索,无需独立搜索系统。基准测试显示:8 CU 以下时数据库为瓶颈,8 CU 以上时应用为瓶颈;缓存与索引比例决定命中率,接近 1.0 时延迟稳定。建议索引用 quality 模式、候选数设为 200,生产环境最小 0.5 CU 以避免冷启动。
Scikit-LLM 是一个 Python 库,将预训练大语言模型封装为 scikit-learn 风格的 fit() 和 predict() 接口,无需重新训练模型。文章以 IT 支持工单分类为例,演示少样本分类:仅需 3 至 5 个带标签示例即可引导模型准确分类新文本,效果优于零样本分类,尤其适合领域特定任务。
Cloudflare 发布开放权重决策模型 Clef-omni,基于 Qwen3-Omni 的 30B-A3B MoE,采用 Apache-2.0 许可,每百万 tokens 收费 0.15 美元。该模型可在一次调用中对文本、图像、音频和视频打分,省去转录步骤,在意图分类任务上领先,但推理与工作流评测弱于 Clef。同时 Clef-flash 降价至 0.038 美元,托管 Clef 迁移 SGLang 后提速 1.7 至 2 倍。
OpenAI发布GPT-6与Intelligent UI,将AI从聊天回答转向可查看、修改、确认和执行的界面化任务流。模型仅生成结构化建议,校验、权限与提交由界面负责。开发者应重视Schema、状态机、审计与权限,而非只调模型。
OpenAI推出文本水印系统textGrain,通过影响模型选词嵌入统计信号。API客户可自愿启用,欧盟ChatGPT和Codex将默认加水印以符合AI法案。检测率约80%(200词)至95%(400词),但编辑会削弱信号,代码因选择少更难水印。检测工具初期仅限研究机构。
OpenAI在欧盟为ChatGPT和Codex推出textGrain文本水印,暂不设为全球默认。API客户可自愿启用,研究机构可申请检测工具。OpenAI称水印性能不逊于SynthID,但不保证可靠检测,也不能证明作者身份或准确性。
介绍用 Python 调用语音合成 REST API 的实用方案:将长文本按标点切分为 800 字符以内片段,逐段生成 MP3;先写临时文件再改名落盘,避免中断产生半成品;重跑时跳过已有非空文件以实现断点续传。同时需校验音频完整性、管理文本哈希与清单、人工抽听数字和日期,并注意密钥安全与限流处理。
文章用Python标准库演示消费Responses的SSE流:逐行解析data事件,用delta增量打印文本,以completed事件判断回答是否完整,并设置超时与Ctrl+C取消。强调流事件只代表生成过程,片段不等于完整答案;生产环境需区分显示与完成、处理401/429、避免碎片入库,并记录首字延迟与取消率。
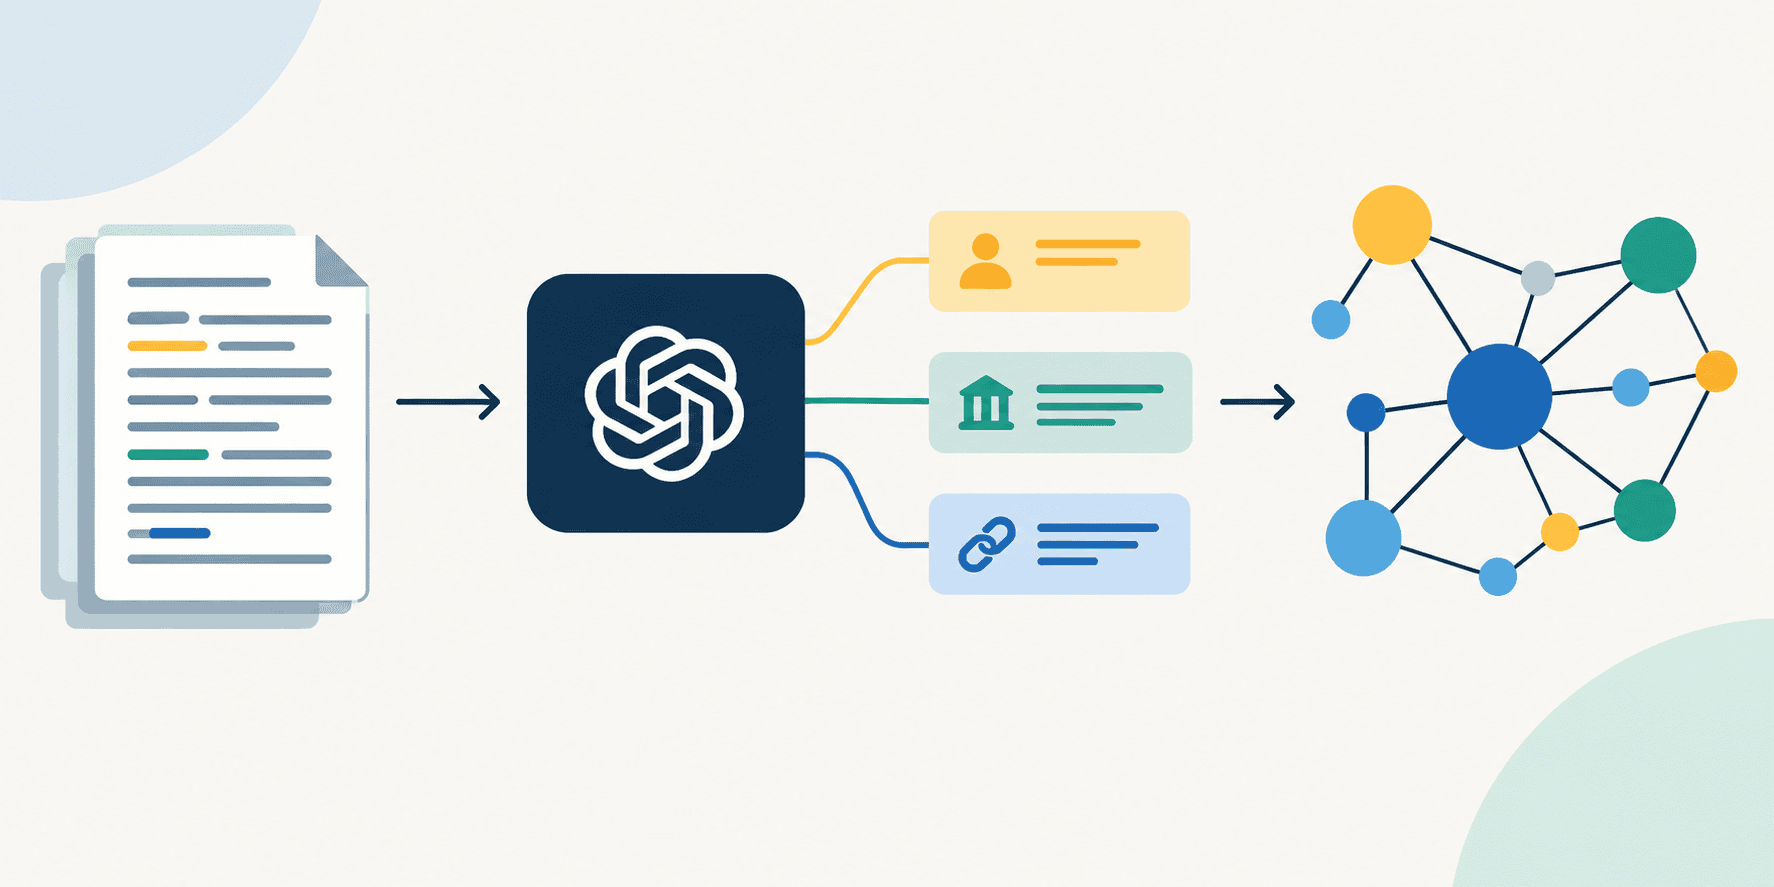
本文介绍用本地LLM从非结构化文本自动抽取知识图谱:通过Ollama运行Llama 3.2,采用少样本提示和JSON输出模式,将维基百科文本转为SPOC四元组(主语、谓语、宾语、上下文),并载入QuadStore图数据库,供Graph-RAG检索,以减少幻觉。
完成下面两步后,将自动完成登录并继续当前操作。