小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
Dify.AI
沉浸式翻译 immersive translate
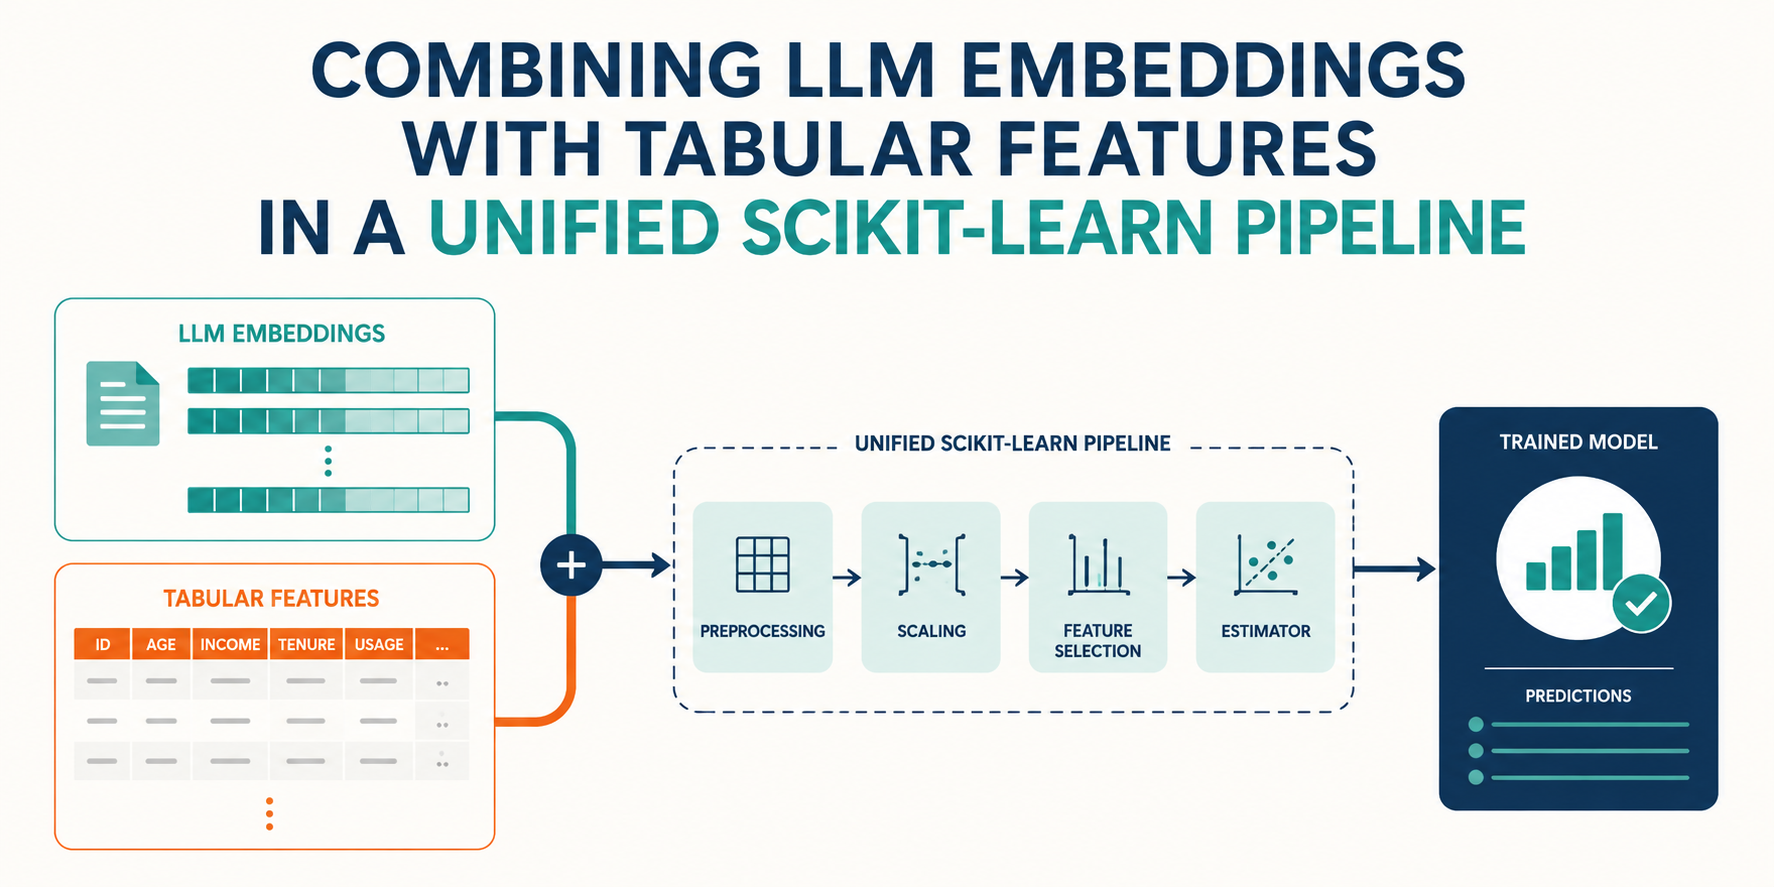
在统一的Scikit-learn管道中结合LLM嵌入与表格特征

本文介绍如何构建统一的scikit-learn管道,结合轻量级开源语言模型生成的文本嵌入与表格特征进行分类。通过自定义Transformer封装Hugging Face的sentence-transformers,利用ColumnTransformer并行处理文本、数值和分类特征,最终用随机森林分类器评估。以垃圾短信检测为例,混合真实文本与合成表格数据,实现高精度分类,提供可复用的部署方案。

在统一的Scikit-learn管道中结合LLM嵌入与表格特征

MachineLearningMastery.com MachineLearningMastery.com · 2026-08-31T12:00:18Z
FastEmbed:Qdrant的高效Python库用于嵌入生成

FastEmbed是一个高效的Python库,旨在简化文本嵌入生成。它通过量化模型和ONNX Runtime实现快速嵌入,支持多种文本模型,适合大规模数据处理,提升性能和速度。

FastEmbed:Qdrant的高效Python库用于嵌入生成

Qdrant - Vector Database Qdrant - Vector Database · 2026-07-30T07:00:00Z
FastEmbed:Qdrant 高效嵌入生成 Python 库

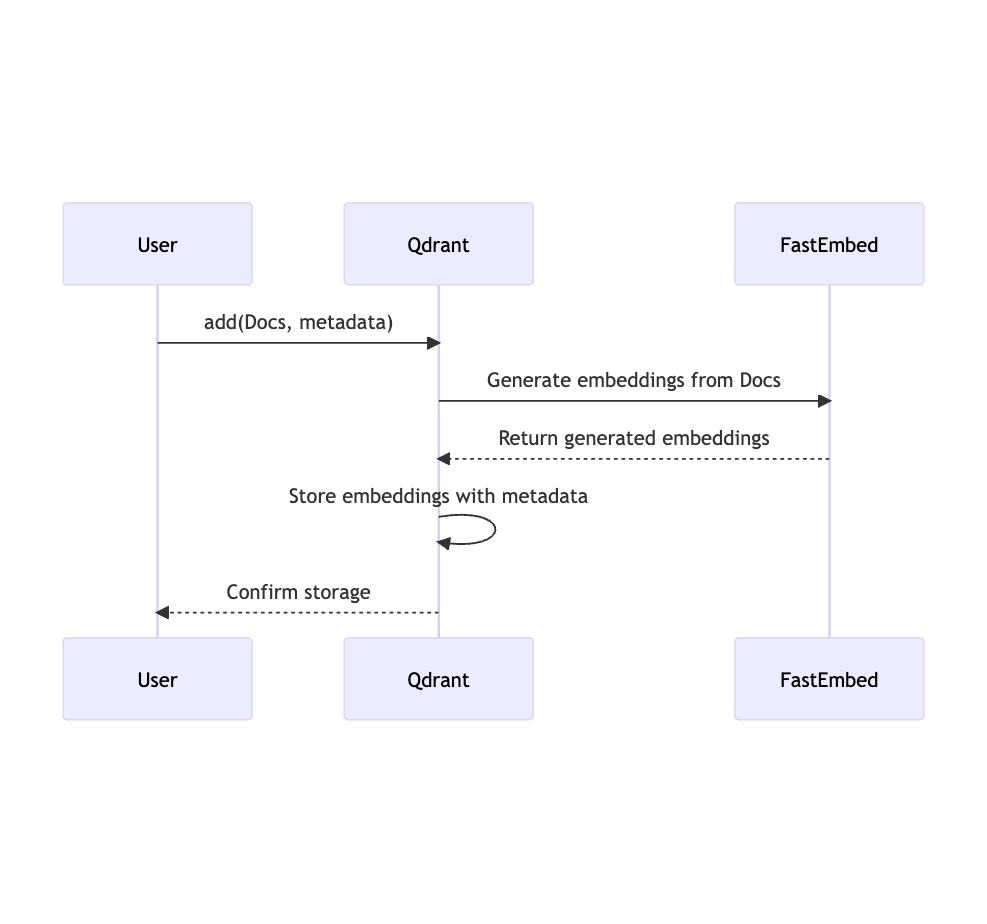
FastEmbed 是一个可在 CPU 上生成文本嵌入的 Python 库,无需 GPU、PyTorch 或 API 密钥。教程演示了如何用 qdrant-client 配合 FastEmbed 对文档进行嵌入、索引和搜索。默认模型 BAAI/bge-small-en-v1.5 为量化 ONNX 文件,输出 384 维向量。客户端在本地进程运行 FastEmbed,自动嵌入文档和查询。此外还支持稀疏、多向量、图像嵌入及重排序,并可通过 fastembed-gpu 扩展。

FastEmbed:Qdrant 高效嵌入生成 Python 库

Qdrant - Vector Database Qdrant - Vector Database · 2026-07-30T07:00:00Z
Antony Pegg:如何通过API在pgEdge Cloud上构建RAG服务器

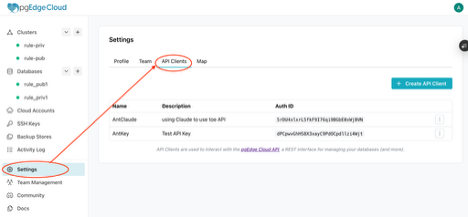
本文介绍了如何在pgEdge Cloud上设置RAG服务器,通过API将文本数据嵌入Postgres数据库。以个人兴趣为例,作者展示了如何将50本桌面角色扮演游戏规则书整合到RAG服务器中,以便快速查询规则。通过配置pgEdge的向量化工具,用户可以实现文本的自动分块和嵌入,从而高效检索和回答规则问题。

Antony Pegg:如何通过API在pgEdge Cloud上构建RAG服务器

Planet PostgreSQL Planet PostgreSQL · 2026-07-03T11:15:11Z
微软 发布全新的多语言嵌入模型 Harrier-OSS-v1,为多种语言提供高质量的语义表示

微软推出Harrier-OSS-v1,包含三种多语言文本嵌入模型,支持32,768词元的长上下文,采用解码器架构,需指令调优以提升检索性能。在多语言MTEB v2基准测试中表现优异。

微软 发布全新的多语言嵌入模型 Harrier-OSS-v1,为多种语言提供高质量的语义表示

实时互动网 实时互动网 · 2026-04-01T03:03:14Z
利用LLM嵌入构建语义搜索

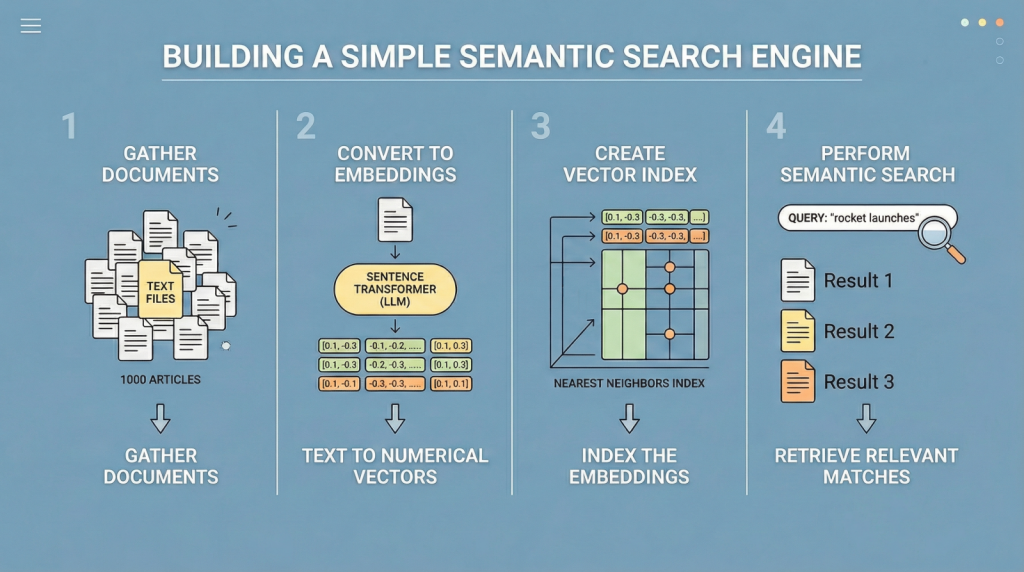
本文介绍了如何利用句子嵌入和最近邻算法构建语义搜索引擎。与传统关键词搜索相比,语义搜索能够更好地捕捉文本的意义。文章提供了使用Python实现语义搜索的步骤,包括数据集加载、嵌入生成和最近邻搜索,最终展示了如何根据查询返回相似文档。

利用LLM嵌入构建语义搜索

MachineLearningMastery.com MachineLearningMastery.com · 2026-03-02T13:37:01Z
Voyage 4模型系列:采用混合专家架构的共享嵌入空间

Voyage 4系列推出四种文本嵌入模型,具共享嵌入空间,支持不同模型间的互用。voyage-4-large采用混合专家架构,提升检索准确率并降低40%成本,适合高效检索需求的客户和开发者,支持多维度嵌入,优化查询与文档嵌入的独立调优。

Voyage 4模型系列:采用混合专家架构的共享嵌入空间

Voyage AI Voyage AI · 2026-01-15T14:55:00Z
10种在表格机器学习任务中使用嵌入的方法

嵌入表示是处理非结构化数据的有效工具,广泛应用于机器学习。本文介绍了十种利用嵌入的策略,如编码分类特征、聚合文本嵌入、聚类和自监督学习等,旨在提高数据利用效率和模型性能。

10种在表格机器学习任务中使用嵌入的方法

MachineLearningMastery.com MachineLearningMastery.com · 2026-01-12T11:00:31Z
MANZANO:一个简单且可扩展的统一多模态模型,采用混合视觉标记器

Manzano是一个简单且可扩展的统一多模态模型框架,结合了混合图像标记器和优化的训练方法,能够有效理解和生成视觉内容。该模型通过共享的视觉编码器和轻量适配器,实现图像到文本和文本到图像的连续嵌入,尤其在文本丰富的评估中表现突出。

MANZANO:一个简单且可扩展的统一多模态模型,采用混合视觉标记器

Apple Machine Learning Research Apple Machine Learning Research · 2026-01-11T00:00:00Z

BGE系列模型包括多语言文本嵌入模型BGE-M3和重排序模型BGE-Reranker-v2-M3,支持高效推理。TEI框架简化了模型部署,适用于自然语言处理任务。结合TEI和vLLM可构建高性能AI应用,提升检索和生成的准确性与效率。

常用AI模型介绍及多模型组合使用场景

安志合的学习博客 安志合的学习博客 · 2025-12-07T21:37:51Z

本文探讨了Discourse论坛如何利用文本嵌入模型生成相关话题和语义搜索。作者尝试了多种模型,最终选择了适合中文的gte-base-zh和Qwen3-Embedding系列,其中0.6B版本在资源需求上表现较好。论坛的文本嵌入算力主要依赖群友提供的设备。

给论坛用上了文本嵌入模型

依云's Blog 依云's Blog · 2025-11-11T07:14:52Z
利用LLM嵌入进行文本数据的7个高级特征工程技巧

大型语言模型(LLMs)不仅能理解和生成文本,还能将文本转化为数值嵌入。本文介绍了七种高级Python示例,利用LLM生成的嵌入来增强文本特征工程,从而提高情感分析和主题分类等任务的准确性和鲁棒性。

利用LLM嵌入进行文本数据的7个高级特征工程技巧

MachineLearningMastery.com MachineLearningMastery.com · 2025-10-29T15:44:41Z
Qwen3 Embedding 技术解析:多语言文本嵌入与重排序的新标杆

阿里巴巴通义实验室发布的Qwen3 Embedding系列模型在文本嵌入和重排序任务上取得了突破,解决了多语言支持和专业领域表现不足的问题。该模型通过多阶段训练流程,结合弱监督预训练和高质量数据微调,显著提升了性能,尤其在代码检索和多语言任务中表现优于其他模型。

Qwen3 Embedding 技术解析:多语言文本嵌入与重排序的新标杆

我爱自然语言处理 我爱自然语言处理 · 2025-06-06T02:08:33Z
如何利用文本嵌入构建索引

本文介绍了如何利用文本嵌入构建索引并通过自然语言进行查询。流程包括读取文本文件、分块、嵌入并存储到向量数据库,使用Postgres跟踪数据,最后通过SQL查询索引以获取结果。

如何利用文本嵌入构建索引

DEV Community DEV Community · 2025-05-24T00:23:59Z

康奈尔大学提出的无监督文本嵌入转换方法vec2vec,基于强柏拉图表示假说,能够在无配对数据的情况下实现文本模型间的转换。实验表明,vec2vec在多个数据集上表现优异,能够保留嵌入的语义和几何结构,但也存在数据安全风险。

无需数据配对,文本嵌入也能互通?康奈尔研究:所有模型殊途同归

量子位 量子位 · 2025-05-23T10:24:15Z

本研究提出了一种新方法,通过识别嵌入空间中的语义方向向量,将文本嵌入限制在安全区域,以应对扩散模型生成不安全内容和社会偏见的问题。该方法增强了模型对潜在不安全提示的鲁棒性,并在多个基准数据集上显著减少了NSFW内容和社会偏见。

Responsible Diffusion Models via Constraining Text Embeddings within Safe Regions

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-05-21T00:00:00Z

本研究提出了现代GBERT系列德国编码器模型,旨在满足资源有限时对编码器模型的需求。该模型在自然语言理解、文本嵌入和长上下文推理任务上表现优异,推动了德国NLP生态系统的发展。

Modern GBERT: German Independent Encoder Model Trained from Scratch

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-05-19T00:00:00Z

随着Dify知识库的增长,传统的相似度计算已无法满足需求,重排序模型变得越来越受欢迎。本文介绍如何搭建HuggingFace的文本嵌入推理,并将其整合到Dify中,以改善检索结果的排序。使用Docker可以轻松部署,并通过重排序器提升检索性能。

自行架設Dify使用的重排序模型:Text Embeddings Inference / Self-Hosting a Dify Reranking Model: Text Embeddings Inference

布丁布丁吃什麼? 布丁布丁吃什麼? · 2025-05-12T04:00:00Z
个性化图像:自回归模型在新研究中与扩散模型相媲美

个性化图像合成在文本到图像生成中至关重要,尤其在数字艺术和广告领域。研究探讨了自回归模型的潜力,提出了两阶段训练策略以优化文本嵌入和微调变换器层。实验结果表明,该方法在主题保真度和提示跟随方面与主流扩散模型相当,展示了自回归模型的有效性和应用前景。

个性化图像:自回归模型在新研究中与扩散模型相媲美

DEV Community DEV Community · 2025-04-24T21:54:22Z
文本嵌入的长度偏见及其在搜索中的影响

文本嵌入模型的相似性评分受输入长度偏见影响,长文本通常得分较高,导致相关性评估不准确。即使相似文本得分更高,长文本的偏见使得相似性评分不可靠。因此,应结合其他方法判断文本的实际相关性,而非仅依赖余弦相似度。

文本嵌入的长度偏见及其在搜索中的影响

Jina AI Jina AI · 2025-04-16T01:40:03Z
  • <<
  • <
  • 1 (current)
  • 2
  • 3
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。

1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码