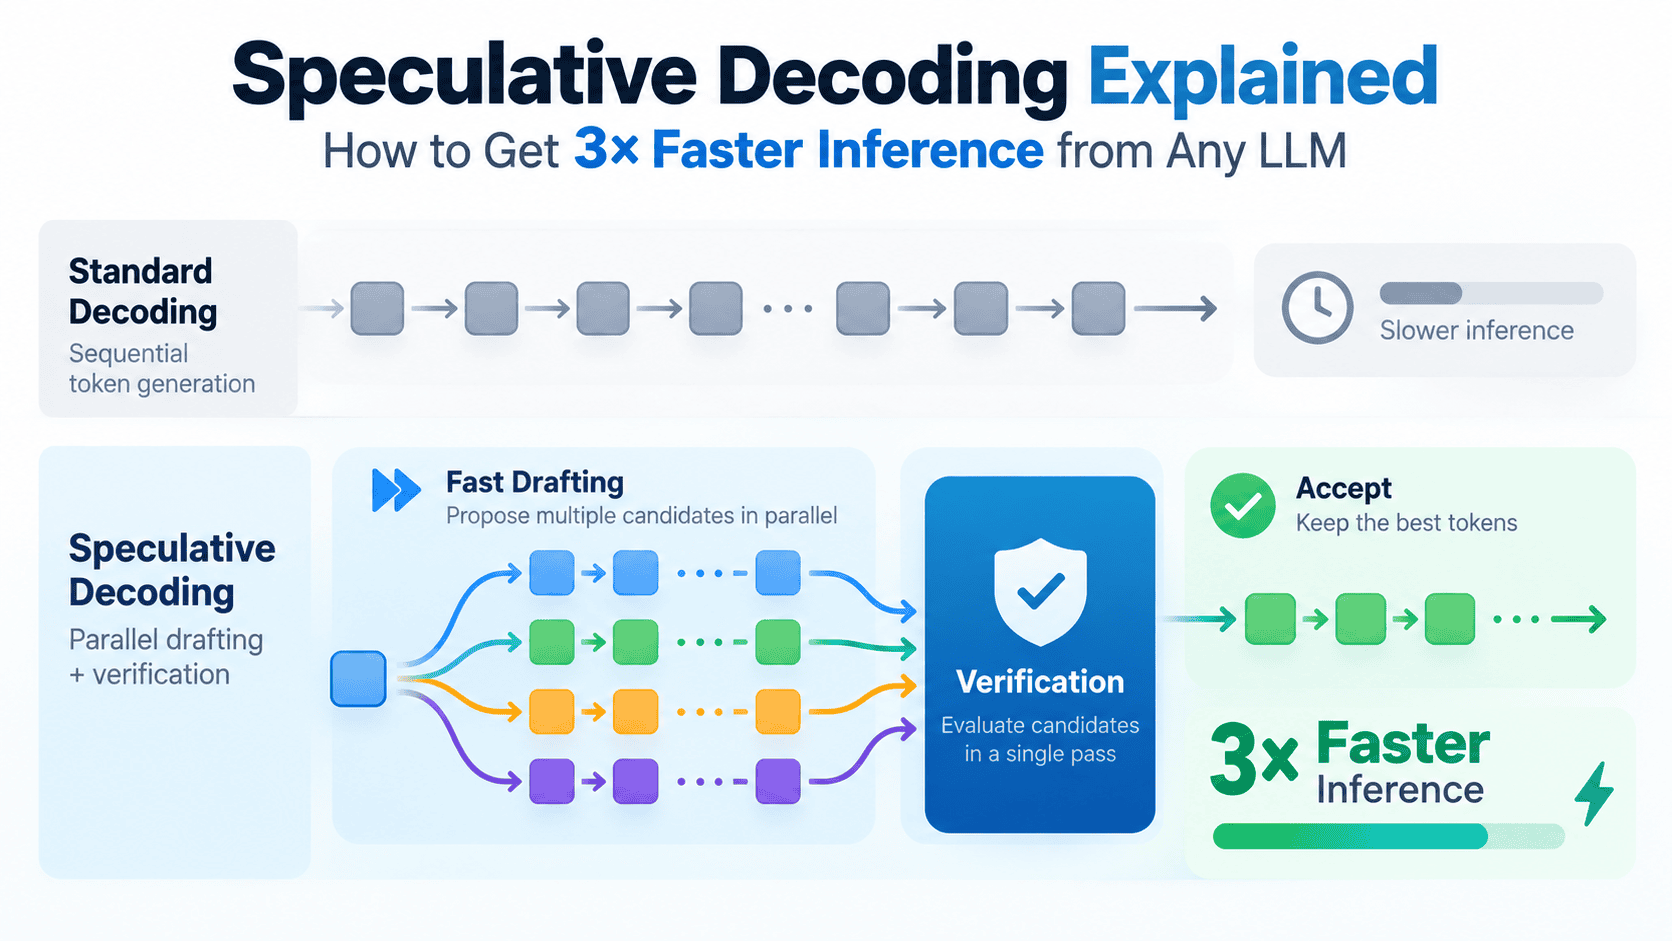
投机解码通过“草稿—验证”机制加速大模型推理:小模型快速生成候选token,大模型并行验证,保证输出分布与原模型一致。瓶颈在显存带宽而非算力,接受率约70%—80%时可达2—3倍加速。Medusa、Eagle、Prompt Lookup等变体无需独立草稿模型。该技术适合长输出、低并发场景,高批量服务可能降低吞吐。
完成下面两步后,将自动完成登录并继续当前操作。