


投机解码详解:如何让任意大语言模型实现3倍速推理
内容提要
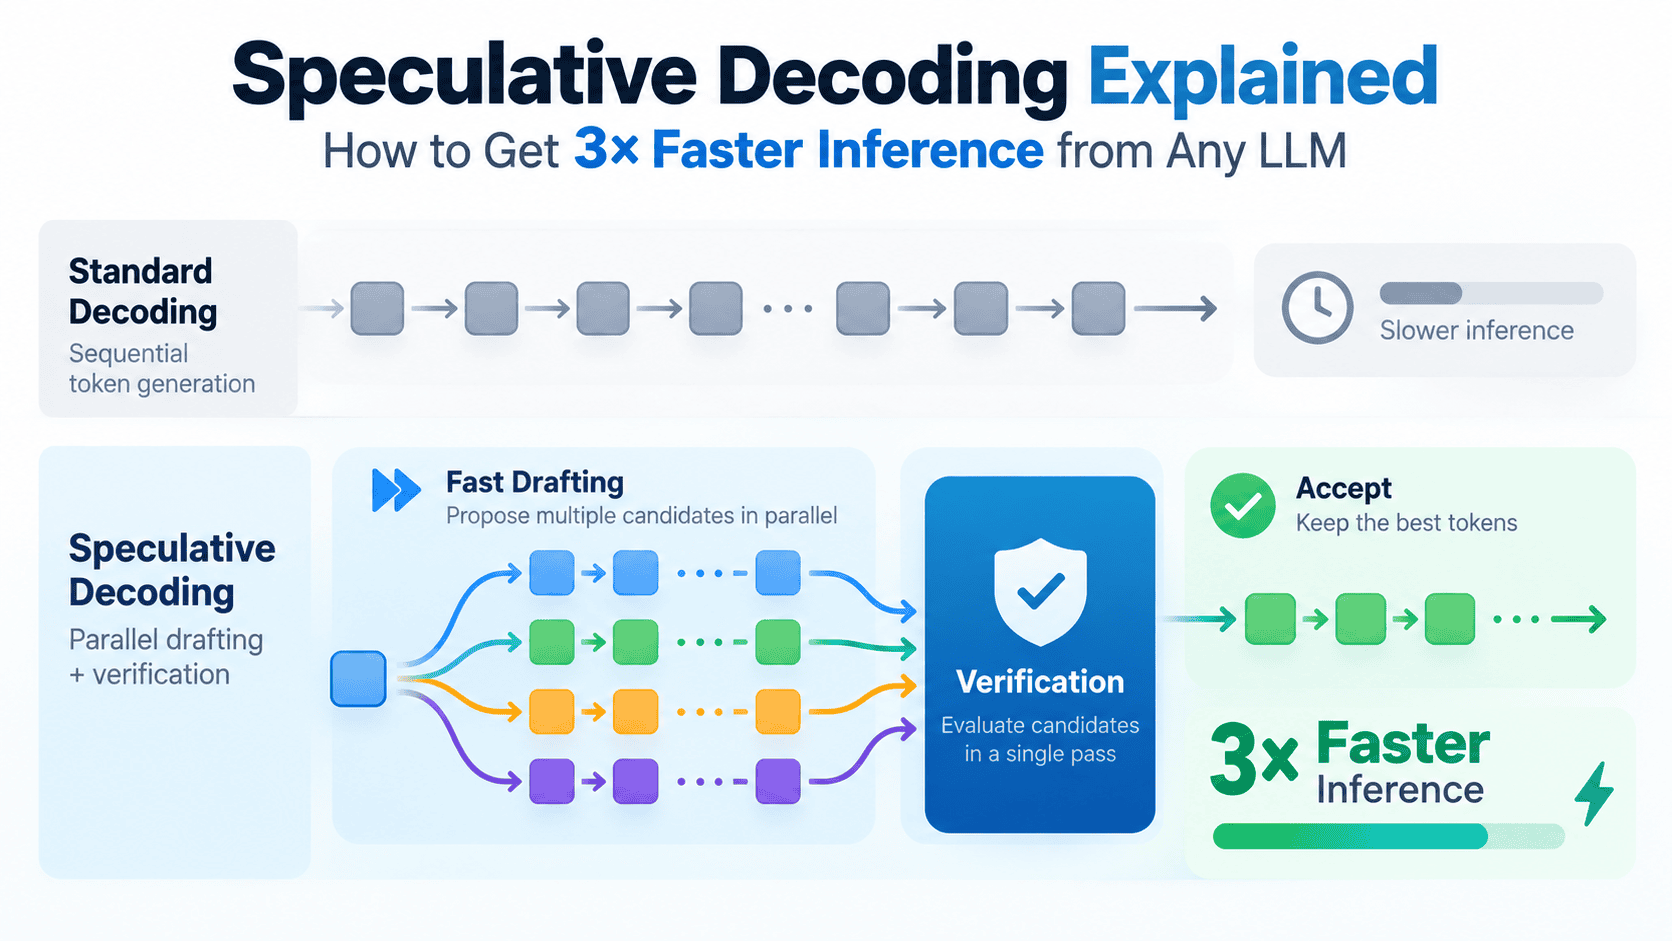
投机解码通过“草稿—验证”机制加速大模型推理:小模型快速生成候选token,大模型并行验证,保证输出分布与原模型一致。瓶颈在显存带宽而非算力,接受率约70%—80%时可达2—3倍加速。Medusa、Eagle、Prompt Lookup等变体无需独立草稿模型。该技术适合长输出、低并发场景,高批量服务可能降低吞吐。
延伸解读
加速的硬件逻辑:显存带宽是瓶颈
文章指出,大模型逐token生成时,每次都要将数十亿参数从显存搬运到处理器,计算单元大部分时间在等待数据,而非算力不足。投机解码让目标模型一次加载权重后并行验证多个候选token,把原本闲置的并行计算能力利用起来。因此,增加算力对标准解码帮助有限,而投机解码直接针对带宽瓶颈,这是其能实现2—3倍加速的根本原因。
接受率决定收益,模型配对不当可能反变慢
实际加速比主要取决于草稿模型候选被目标模型接受的比例。文章给出,配对良好的模型在常见任务上接受率约70%—80%,对应2—3倍加速;可预测或重复性强的文本接受率更高。但若草稿模型与目标模型不匹配,首个候选即被拒绝时,反而比标准解码略慢,因为草稿生成时间已付出。因此启用前应评估任务类型与模型配对,而非默认开启。
变体方案:去掉独立草稿模型,但可能牺牲严格保证
Medusa在目标模型末层加多个预测头自行草稿;Eagle利用内部隐藏状态预测未来token,在复杂或领域文本上接受率更高;Prompt Lookup直接从提示和历史中找重复片段作候选,适合代码编辑和摘要。文章提醒,部分变体用更简实现或更高吞吐换取了原始方法的严格分布保证,不过对输出质量的实践影响通常可忽略。选择时需权衡实现复杂度与保证强度。
适用场景:长输出、低并发受益,高批量服务可能降吞吐
文章明确,投机解码最适合生成长输出、单请求服务、且提示与回复共享词汇或结构的场景,如问答、摘要、代码补全。但在高吞吐批量服务中,草稿token会占用显存和算力,可能挤占本可服务更多请求的资源,反而降低整体吞吐。因此生产部署时应根据并发模式决定是否启用,而非一概而论。
Q&A
为什么大语言模型推理速度慢?瓶颈在哪里?
大语言模型自回归生成,每次只产生一个token。瓶颈不在算力,而在显存带宽:模型的数十亿参数存储在GPU显存中,每生成一个token都需要将所有参数从显存传输到处理器,计算单元大部分时间在等待数据传输。
投机解码是如何工作的?它如何保证输出质量不变?
投机解码使用小模型(草稿模型)快速生成4-8个候选token,大模型(目标模型)并行验证这些候选。验证时根据概率比较接受或拒绝,拒绝时从调整后的分布中采样修正token。这种统计方法保证最终输出分布与目标模型单独生成完全一致,因此质量无损。
投机解码实际能加速多少倍?受什么因素影响?
实际加速比主要取决于接受率。当草稿模型与目标模型匹配良好、接受率在70%-80%时,通常可获得2-3倍加速。对于可预测或重复性文本,接受率更高,加速更大。
除了原始的两模型方案,还有哪些现代投机解码变体?
现代变体包括:Medusa在目标模型最后一层添加多个预测头,自行生成候选;Eagle基于目标模型的内部隐藏状态预测未来token,接受率更高;Prompt Lookup Decoding无需额外模型,直接从提示和对话历史中查找可能重复的短语作为候选。
在什么场景下适合启用投机解码?什么场景下可能适得其反?
适合长输出、低并发(一次处理一个请求)且提示与回复共享词汇或结构的场景,如问答、文档摘要、代码补全。高批量服务中,投机解码可能降低吞吐量,因为草稿token消耗了本可用于服务更多请求的内存和计算资源。
如何在现有推理框架中启用投机解码?需要重新训练模型吗?
投机解码已内置于Hugging Face的text-generation-inference、vLLM和llama.cpp等推理框架中,通常只需修改配置即可启用,无需重新训练模型或改变提示工作流。
