bstorm 是仓颉版嵌入式 JSON 文档数据库,通过 @Index 标注建立索引。索引使等值查询提速约 44 倍(2015ms 降至 46ms),但写入性能从 21k/s 降至 11.5k/s,成本主要来自事务提交次数,合并主数据与索引写入可挽回部分损失。范围查询在 LSM 上走索引反而更慢,因此采用流式扫描。建议只为高频等值查询字段建索引,因为成本随索引数量线性叠加,而收益并不叠加。
Databricks 推出 Lakehouse//RT 实时数据仓库,支持空间 SQL 与空间连接,可直接在 Delta 和 Iceberg 表上运行地理空间查询,无需复制数据。基准测试显示,空间查询平均快 3 倍,高并发下最高快 38 倍,延迟低至 10 毫秒,每秒可处理 1.2 万次查询。该功能已进入 Beta 阶段,无需修改代码即可使用。
PostgreSQL 19 查询优化新特性:新增 pg_plan_advice 扩展,可记录并回放计划器决策以稳定执行计划;pg_stash_advice 支持按查询标识自动应用建议。EXPLAIN 计时改用 TSC 寄存器降低开销。优化器可将非空列的 IS NOT DISTINCT FROM 转为等值连接,NOT IN 子查询在无 NULL 时可用反连接,虚拟生成列可建扩展统计,postgres_fdw 支持导入远程统计,JIT 默认关闭。
ExoBench实测显示,外键数据倾斜(10个大客户占80%订单)导致同一三表连接查询比均匀数据慢约千倍:Postgres从1毫秒升至1572毫秒,SQL Server升至2340毫秒。两引擎均因单列直方图无法识别跨连接相关性而低估约3000倍。修复方式不同:Postgres关闭嵌套循环即可降至约310毫秒;SQL Server需覆盖索引、批处理模式与哈希连接三者叠加才达约330毫秒。
以无索引查询为例:当表大于 shared_buffers 的四分之一时,Postgres 默认启用 synchronize_seqscans,新的顺序扫描会从上次停止处开始。首次扫描耗时 78 毫秒、读取 31598 页;后续仅 0.07 毫秒、读取 14 页,快约 1100 倍,这并非缓存所致。单次 EXPLAIN ANALYZE 只是样本量为 1,应多次运行并比较标准差与均值之比,以识别异常单次结果或累积效应。
老董工具箱提供域名DNS查询功能,支持A、AAAA、CNAME、MX、TXT、NS等记录类型,可选择Google、Cloudflare、114、阿里、腾讯等DNS服务器,输入域名即可查询解析记录与服务器信息。
“老董工具箱”提供生肖查询工具,用户输入公历年份或出生日期即可查生肖,并显示五行、性格、幸运数字、颜色、方位及相配相冲生肖。
湖仓查询阶段中,SELECT 查询先解析表与快照,获取该快照的数据文件,再利用列统计信息裁剪文件,跳过不可能匹配的文件。存活文件随后过滤删除行、读取 Parquet、按谓词筛选并投影列。统计裁剪、删除过滤、列投影和缺失列补 nil 共同实现高效扫描与模式演进。
StackGres 1.19 为 Citus 引入查询路由器,突破单协调器瓶颈。查询路由器不存分片数据,仅保存元数据并规划路由查询,可水平扩展,由 Kubernetes Service 负载均衡。基准测试显示,单协调器约 55 万 TPS 即达上限,加三个查询路由器后升至 143 万 TPS,延迟仍低,实现近线性扩展。
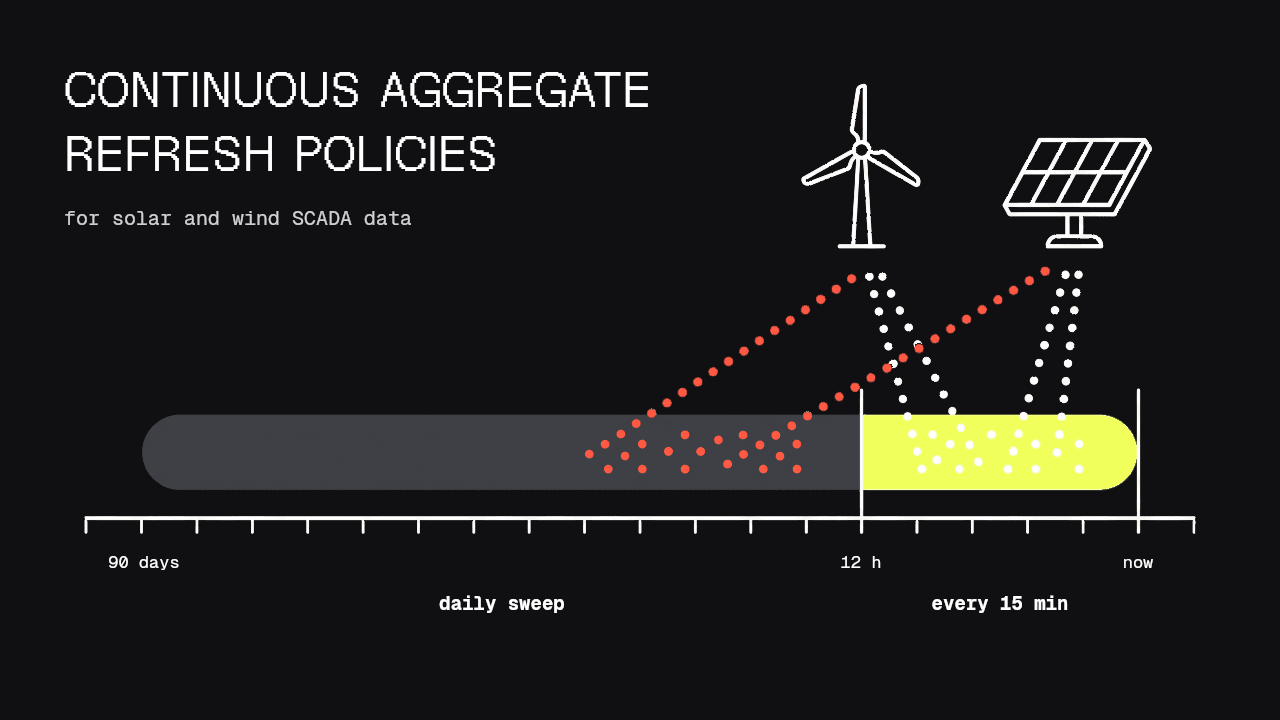
文章讨论太阳能和风电SCADA数据在TimescaleDB中的连续聚合刷新策略,提出高频刷新、每日刷新、分层刷新、保留期感知刷新和手动刷新五种策略,建议根据具体任务选择合适方案。
文章测试了五种让 PostgreSQL 做多余工作的写法:UNION 因去重耗时 13.6 秒,而 UNION ALL 仅 0.68 秒;MATERIALIZED 强制物化 CTE 耗时 1973 毫秒;ORDER BY random() 取一行需 1313 毫秒;SELECT * 比只选索引列多一倍缓冲;WHERE 中函数无表达式索引则全表扫描。修复通常只需一个关键字、一列或一个索引。
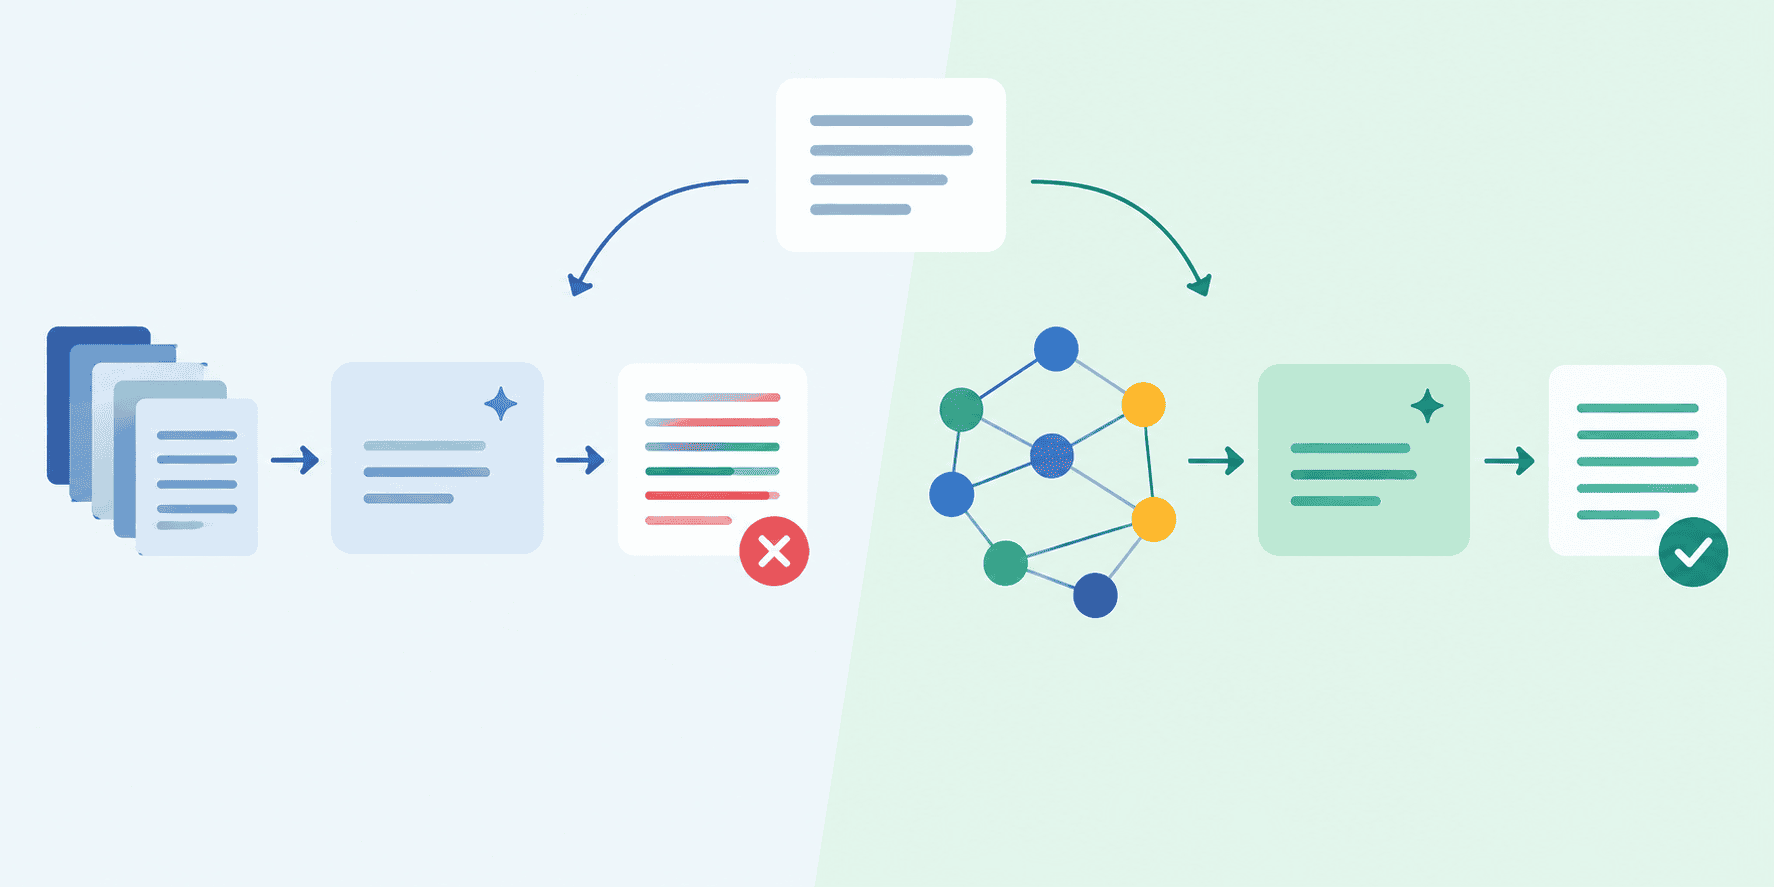
本文对比标准向量RAG与三层Graph-RAG在事实密集型查询中的幻觉表现。作者用合成篮球数据构建基准:图数据库存真实数据,向量库存含矛盾数字的噪声文本。使用Flan-T5-base模型测试50个查询,标准RAG准确率为96%,Graph-RAG为92%。结论是复杂冲突消解提示需更强模型,小模型反而表现更差。
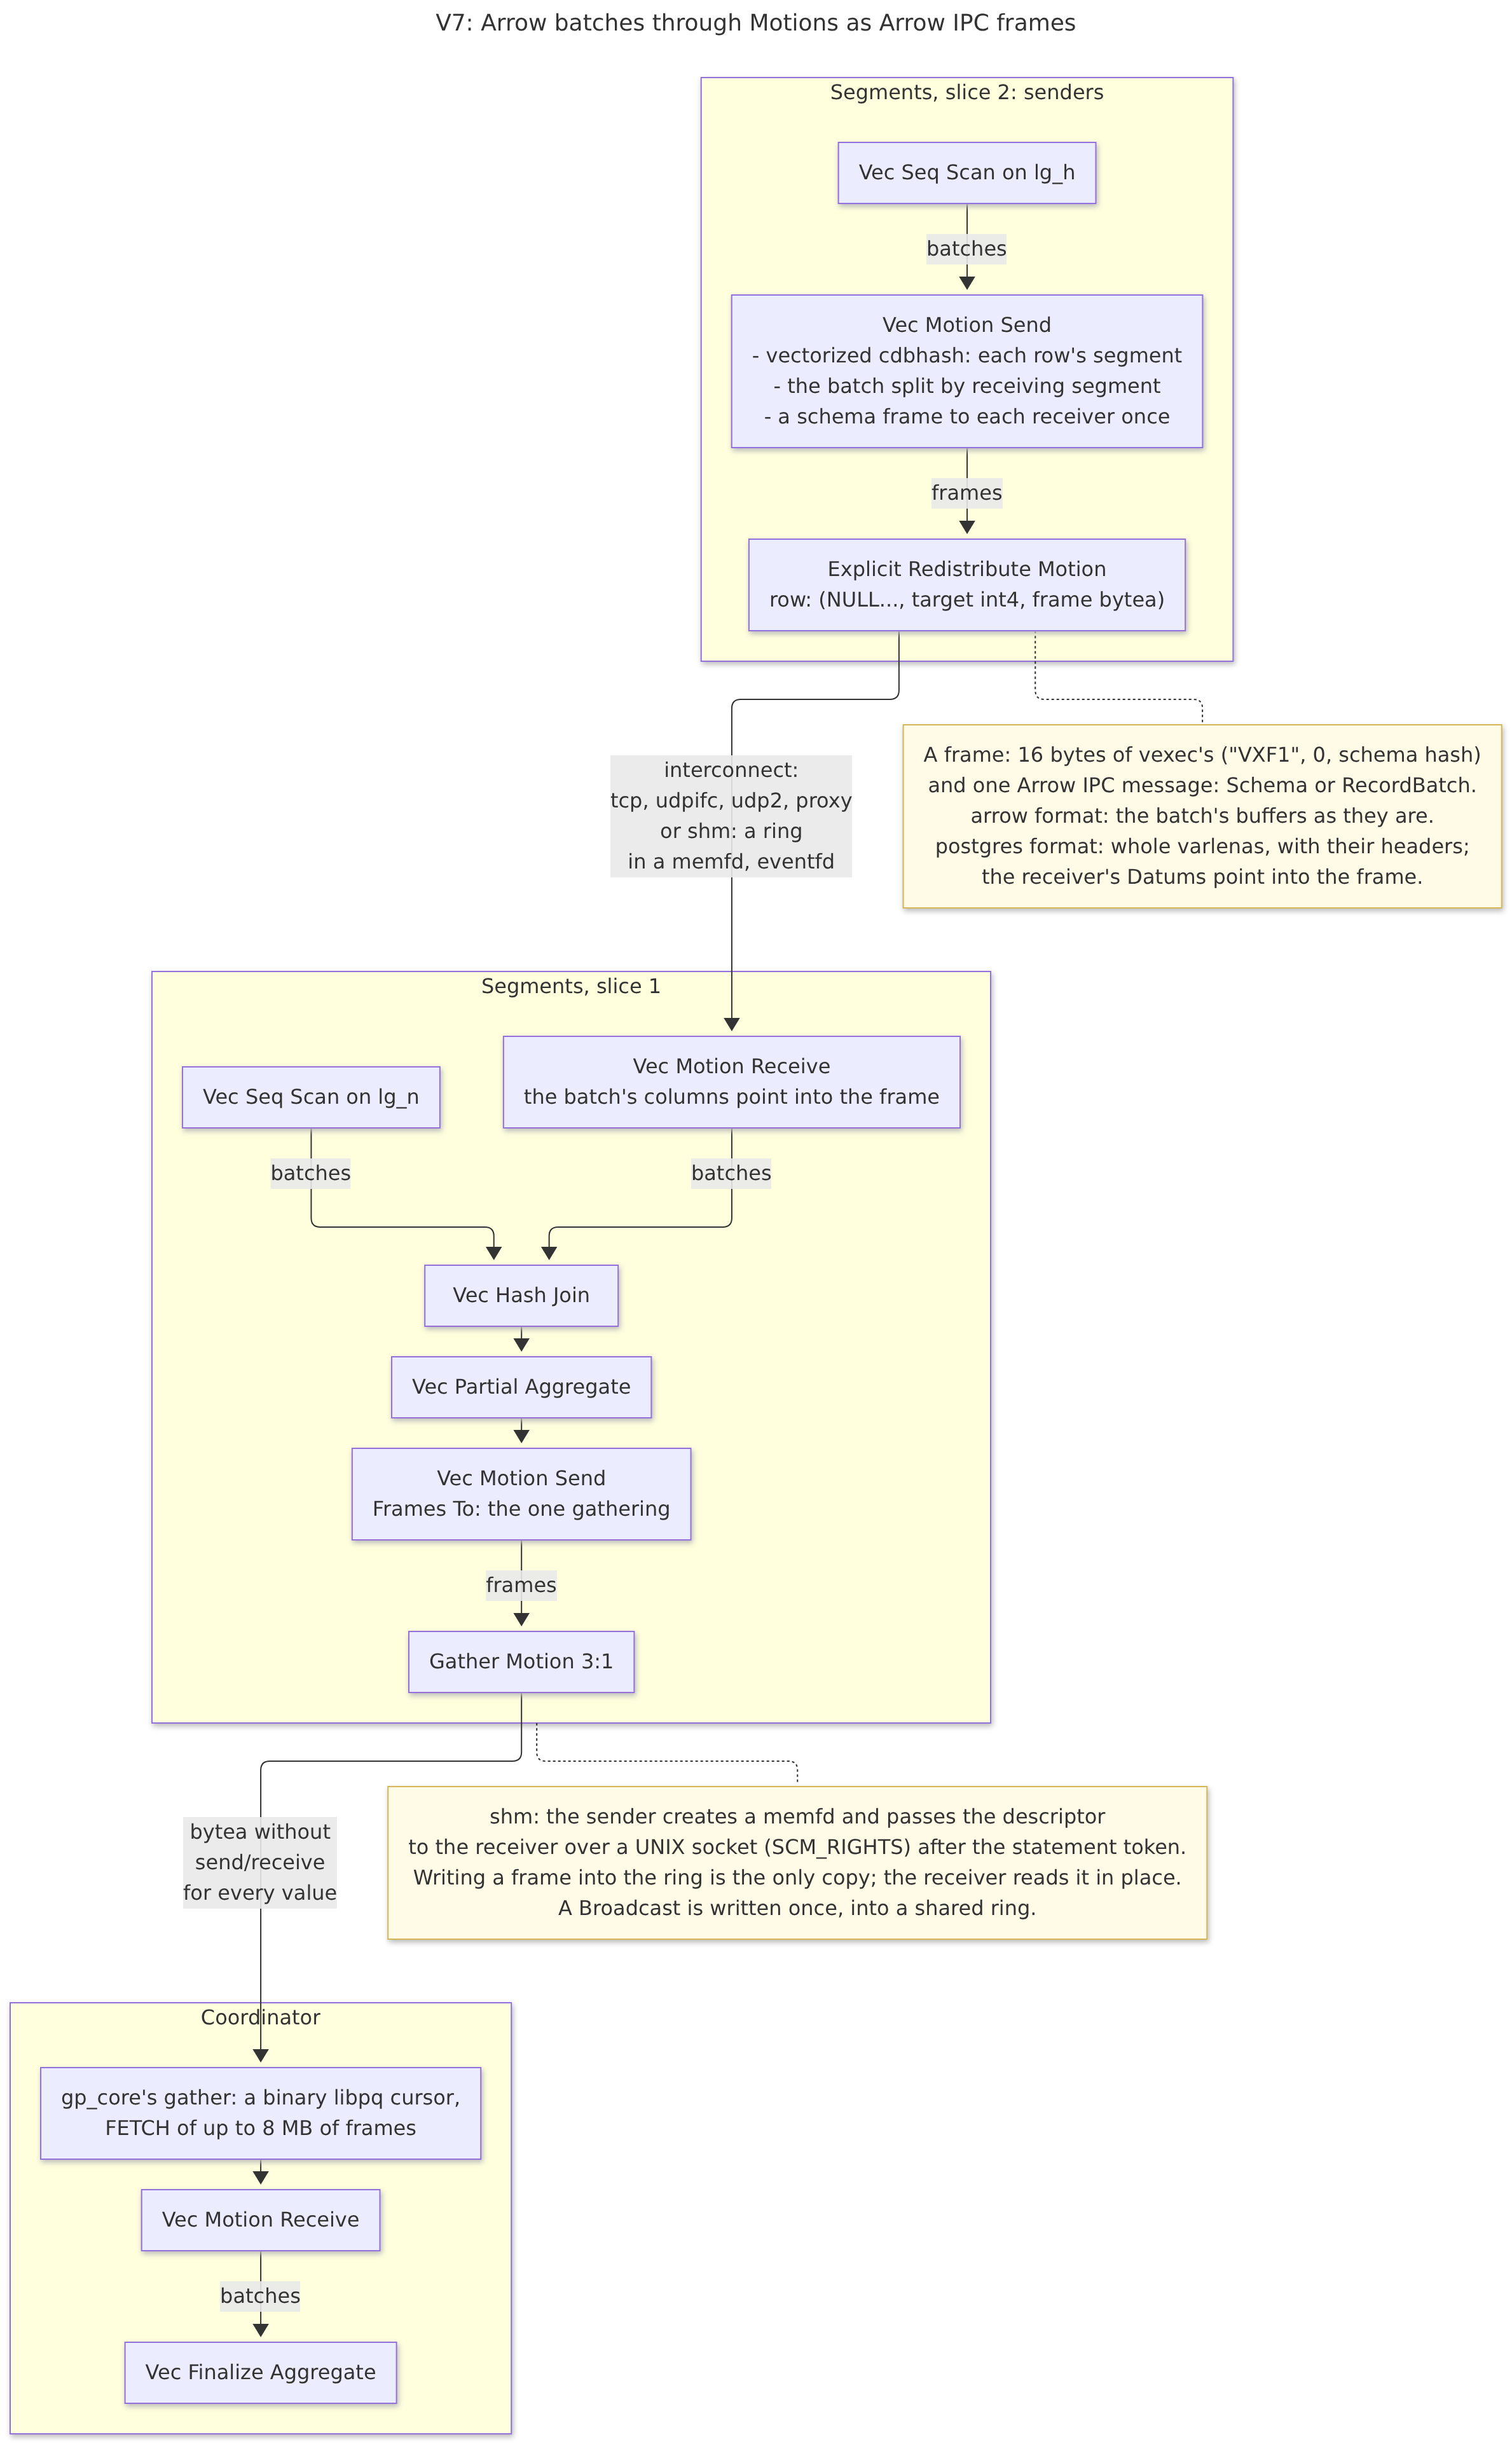
作者开发了pg_vexec扩展,为PostgreSQL 19实现向量化查询执行,无需修改内核。该扩展通过规划器钩子让向量节点与行式路径按代价竞争,支持ORCA向量化规划、PAX列存批量读写、Arrow IPC帧跨节点传输及Flight SQL接口。239项回归测试通过,ClickBench提速19–24%,Flight SQL比二进制COPY快4.7倍。
作者实测PgLens的179条索引建议,发现18%反而拖慢查询,最差一条估算省91%但实测慢约十倍,原因是规划器低估行数;另有34条因值过长无法建索引。规划器排序尚可,但单条提速估算不可靠。作者因此将数字标为估算,并新增真实建索引计时与超长值警告。
Cohere发布Embed 5,包含Pro和Fast两个版本,共享同一嵌入空间,可分别用于索引和查询,无需重建索引。测试显示,Pro索引配Fast查询的检索质量达98.4,接近Pro对Pro的100。Fast吞吐量高2.4倍,价格更低。支持多语言、图文输入及多种向量维度与格式,适合RAG和智能体场景。
PostgreSQL 19 将新增查询提示功能,通过 pg_plan_advice 等扩展模块,用户可指定连接顺序、扫描方式和索引,覆盖优化器默认计划。该功能适用于无法修改的查询或函数估算错误场景,但官方提醒优化器通常正确,应优先分析表和调优索引,提示仅按查询 ID 精准使用,并常检查执行计划。
Constella 提出可替换查询模型的检索方案:文档用 Stella 编码一次,查询可用 Zero、Nano 或 Stella 编码,共用同一向量库,无需重新嵌入。Nano 保留 Stella 约 91% 的平均得分,Zero 更快但精度较低。在 15 个 BEIR 数据集上,Nano 查询速度约为 Stella 的 12 倍,Zero 约 480 倍。适合离线搜索、高并发 API 和边输入边搜等场景。
文章对比四家Postgres托管服务在内存压力下的可靠性:递归UNION查询会生成不受work_mem限制的哈希表,可能耗尽内存。测试中,ClickHouse Managed Postgres通过内存上限使查询干净失败,集群保持存活;RDS触发OOM崩溃并进入恢复;Cloud SQL和PlanetScale则杀掉连接。结论是较低内存上限虽牺牲部分查询,但换取了数据库整体可用性。
本文提出“上下文饥饿”概念:多意图查询经分解检索后,打包器按相关性贪心分配固定上下文预算,导致部分子意图虽已检索到证据却被挤出,且召回指标仍显示正常。实验用GitLab文档构建多意图查询,发现默认流程饿死31.1%子意图。按子查询分数预留名额可将覆盖率从68.9%提至89.4%,优于升级检索器。饥饿多导致无依据回答而非沉默。
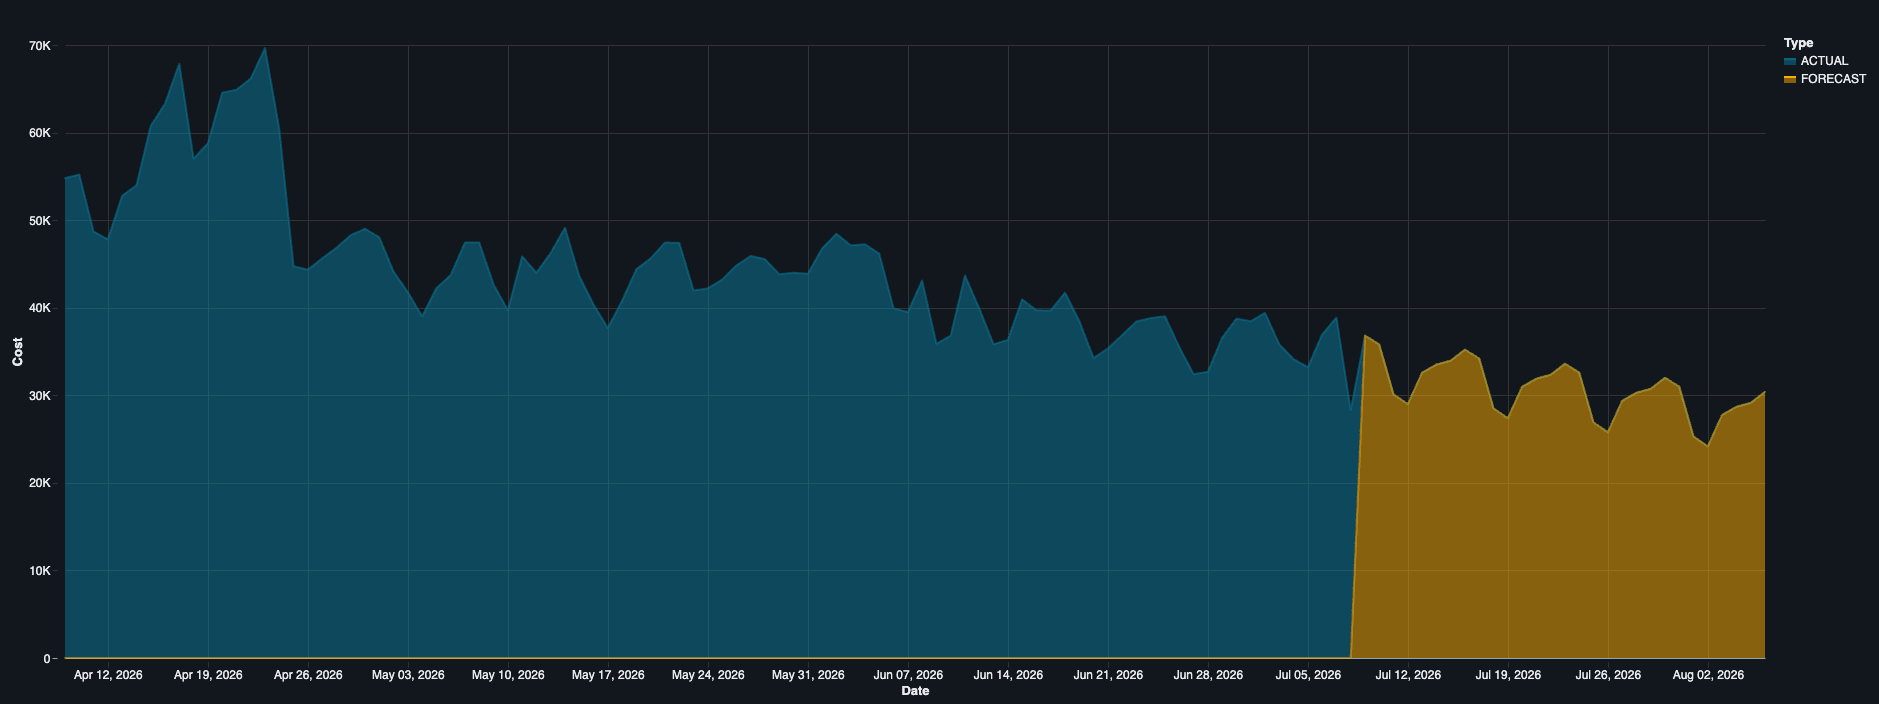
Databricks系统计费表可用于成本分析。本文提供五个SQL查询:按日与产品统计支出、按SQL仓库和标签归因成本、用14天滚动均值标记异常支出,并用AI函数预测下月账单。建议将这些查询嵌入AI/BI仪表板,用于每周成本审查与预算规划。
完成下面两步后,将自动完成登录并继续当前操作。