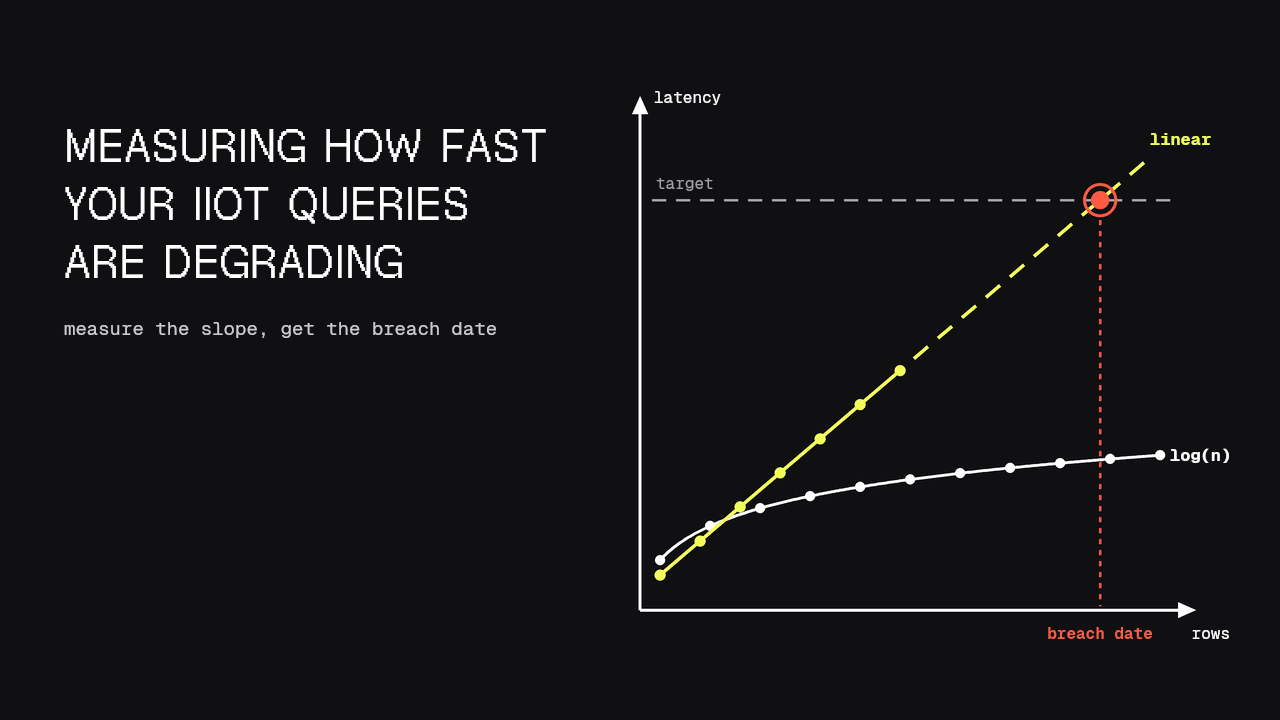
通过记录工业物联网数据库查询延迟与数据行数的关系并拟合曲线,可预测查询何时超出目标延迟,提前发现仪表板变慢问题,避免被动等待。
Companion.energy 借助 Tiger Cloud 优化实时能源数据处理,实现查询延迟降低25倍、压缩率达43.5倍,并通过连续聚合与统一架构处理海量数据。
Qdrant批量导入后,优化器积压会导致查询延迟飙升。基准测试显示:启用持续索引时,排空阶段p50延迟为780毫秒,优化完成后降至4.3毫秒;禁用索引则稳态延迟高达256毫秒。实验性prevent_unoptimized标志可将排空延迟降至10.2毫秒,但新写入点暂时不可搜索。单段配置稳态最快,但恢复超一小时;限制段大小可加速恢复12.7倍。串行化优化线程可降低p95延迟,但延长排空时间。提高deleted_threshold可避免vacuum干扰搜索。
IBM与英伟达、三星联合展示了一种内容感知存储系统,支持千亿级别向量的存储与检索,查询延迟为694毫秒,召回精度达90%。该系统利用IBM Storage Scale System 6000、英伟达H200 GPU和三星固态硬盘,显著缩短索引构建时间,适用于PB级非结构化数据的企业级解决方案。
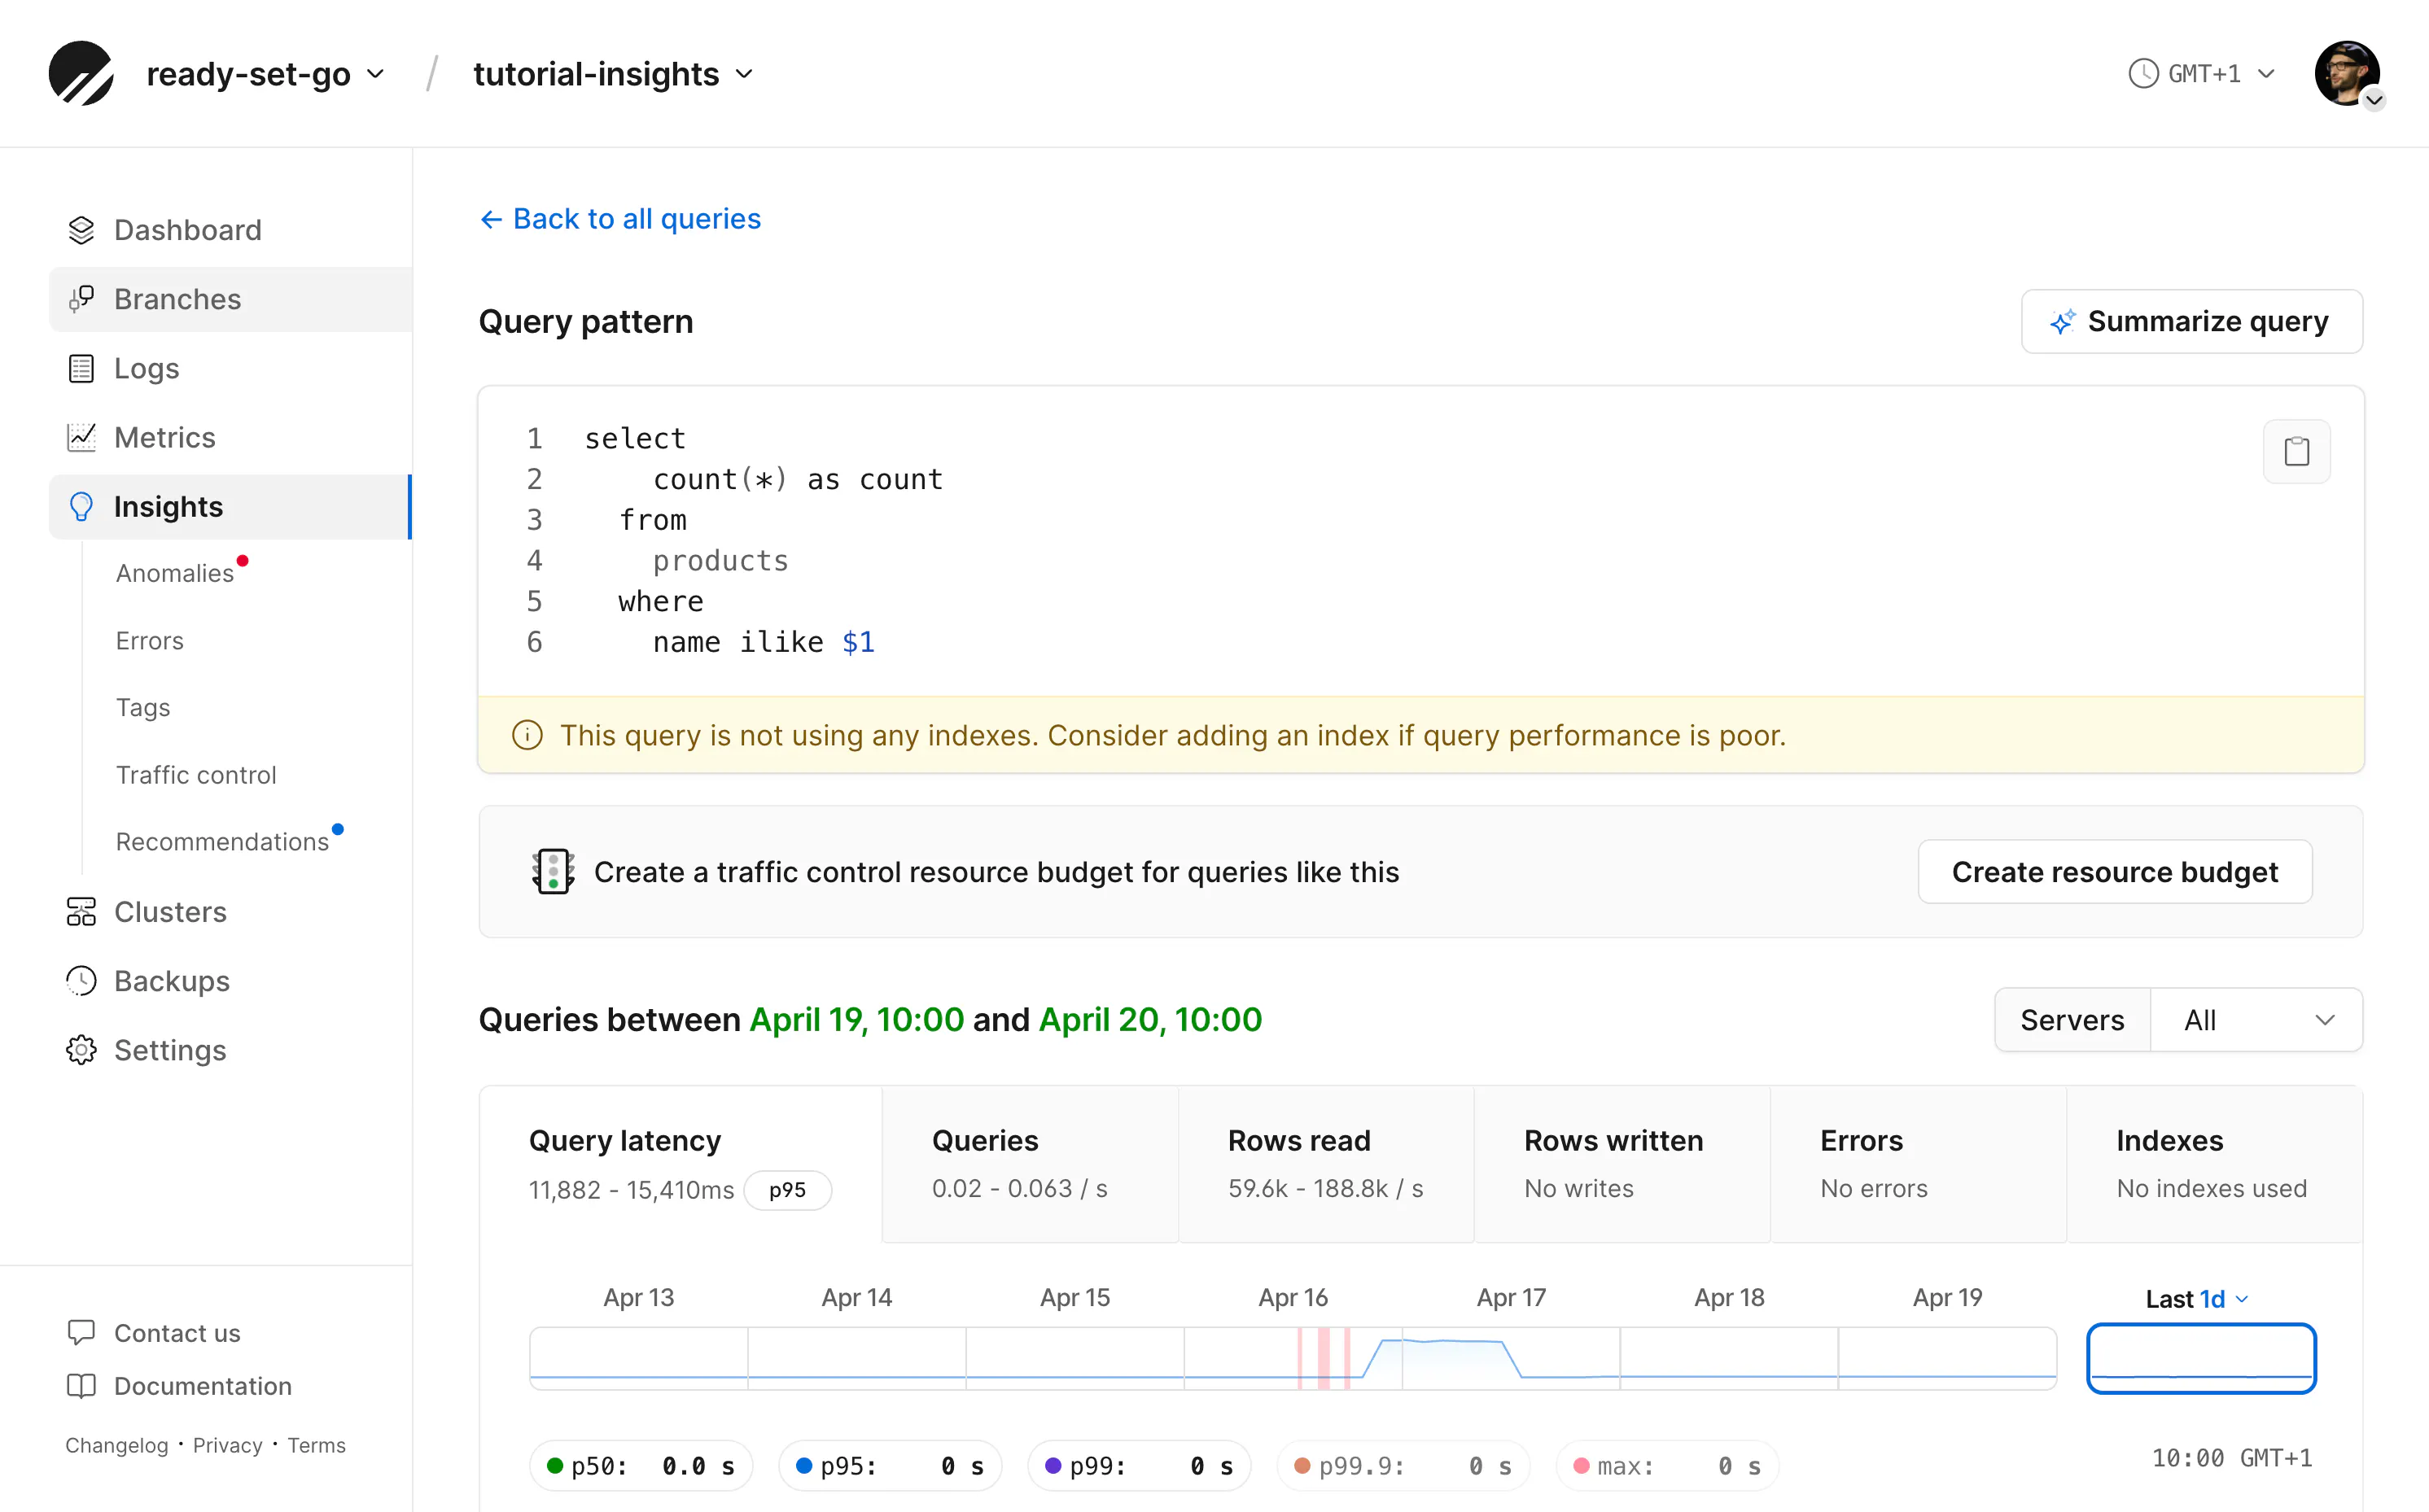
PlanetScale Insights 提供数据库性能监控工具,帮助开发者识别和解决查询延迟问题。通过分析查询延迟的百分位数,用户可以发现性能瓶颈并优化查询。该工具支持查询标签和流量控制,自动识别异常行为并提供改进建议,提升数据库性能。
本文讨论了在高数据量系统中,关系型数据库的标准规范化可能导致性能下降。随着数据量增加,连接操作的开销增大,查询延迟加长。通过数据扁平化和列式压缩可以提高查询速度。建议识别高延迟查询,优化表结构,减少连接操作,以提升数据库性能。使用列式存储可显著减少存储占用并提高查询效率。
本文讨论了在检索增强生成(RAG)管道中,文档分块的重要性。分块策略影响检索精度、索引大小和查询延迟。常见的分块方法包括固定大小分块、递归分块和语义分块。选择合适的分块策略需考虑文档类型和查询模式。较小的分块适合精确检索,而较大的分块则有助于叙述性查询。
PostgreSQL的列限制为1600列,但宽表会导致查询延迟、备份增大和模式变更困难,增加I/O和维护成本,影响系统性能。建议通过垂直分区、使用JSONB和优化模式来降低风险和成本。
文章讨论了pg_blocking_pids()函数对PostgreSQL数据库性能的观察者效应。频繁调用该函数可能导致锁管理器争用,影响查询延迟约10%。尽管影响不大,但在高负载情况下应谨慎使用。
KVectors 向量数据库已基本成型,支持三类向量集合,具备快速构建索引和查询延迟在100毫秒以上的能力。该数据库使用Java/Scala开发,利用现代CPU特性加速向量计算,计划应用于智能客服等领域。
PostgreSQL的缓冲管理器有效地在共享内存和磁盘之间移动数据。冷页读取会增加查询延迟,特别是在全表扫描时。通过调整effective_io_concurrency和random_page_cost等设置,可以减少冷页读取的延迟,从而提升性能,尤其在处理大数据集时,查询执行时间显著降低。
OpenSearch 3.0正式发布,基于Apache Lucene 10,性能提升显著,查询延迟降低60%。新界面更直观,支持用户定制工作区,架构模块化,便于开发和维护。迁移简单,鼓励团队尽快升级以享受更强大的功能和支持。
许多用户在使用New Relic时遇到高成本、查询延迟和复杂配置的问题。SigLens提供实时性能,成本降低80%,且无需调优,专为工程师设计。
中型电商公司在实施向量搜索时遇到内存错误和查询延迟,主要因未调整默认配置和内存不足。为确保可靠性和性能,需优化内存管理、索引选择和备份策略,以提升搜索效率。
Uber Eats团队讨论了扩展后端架构以满足更多商家和用户需求的重要性,强调选择多样性对用户体验的影响。他们介绍了技术挑战,如餐厅和杂货店接入、搜索优化及延迟问题,并通过改进数据布局和索引策略,成功降低了查询延迟,提高了检索效率。
Lyzr通过使用Qdrant提升了AI代理性能,解决了高并发和大数据量下的延迟和瓶颈问题。Qdrant将查询延迟降低至20-50毫秒,索引速度提升2倍,基础设施成本降低30%,确保了Lyzr在高负载下的稳定性能。
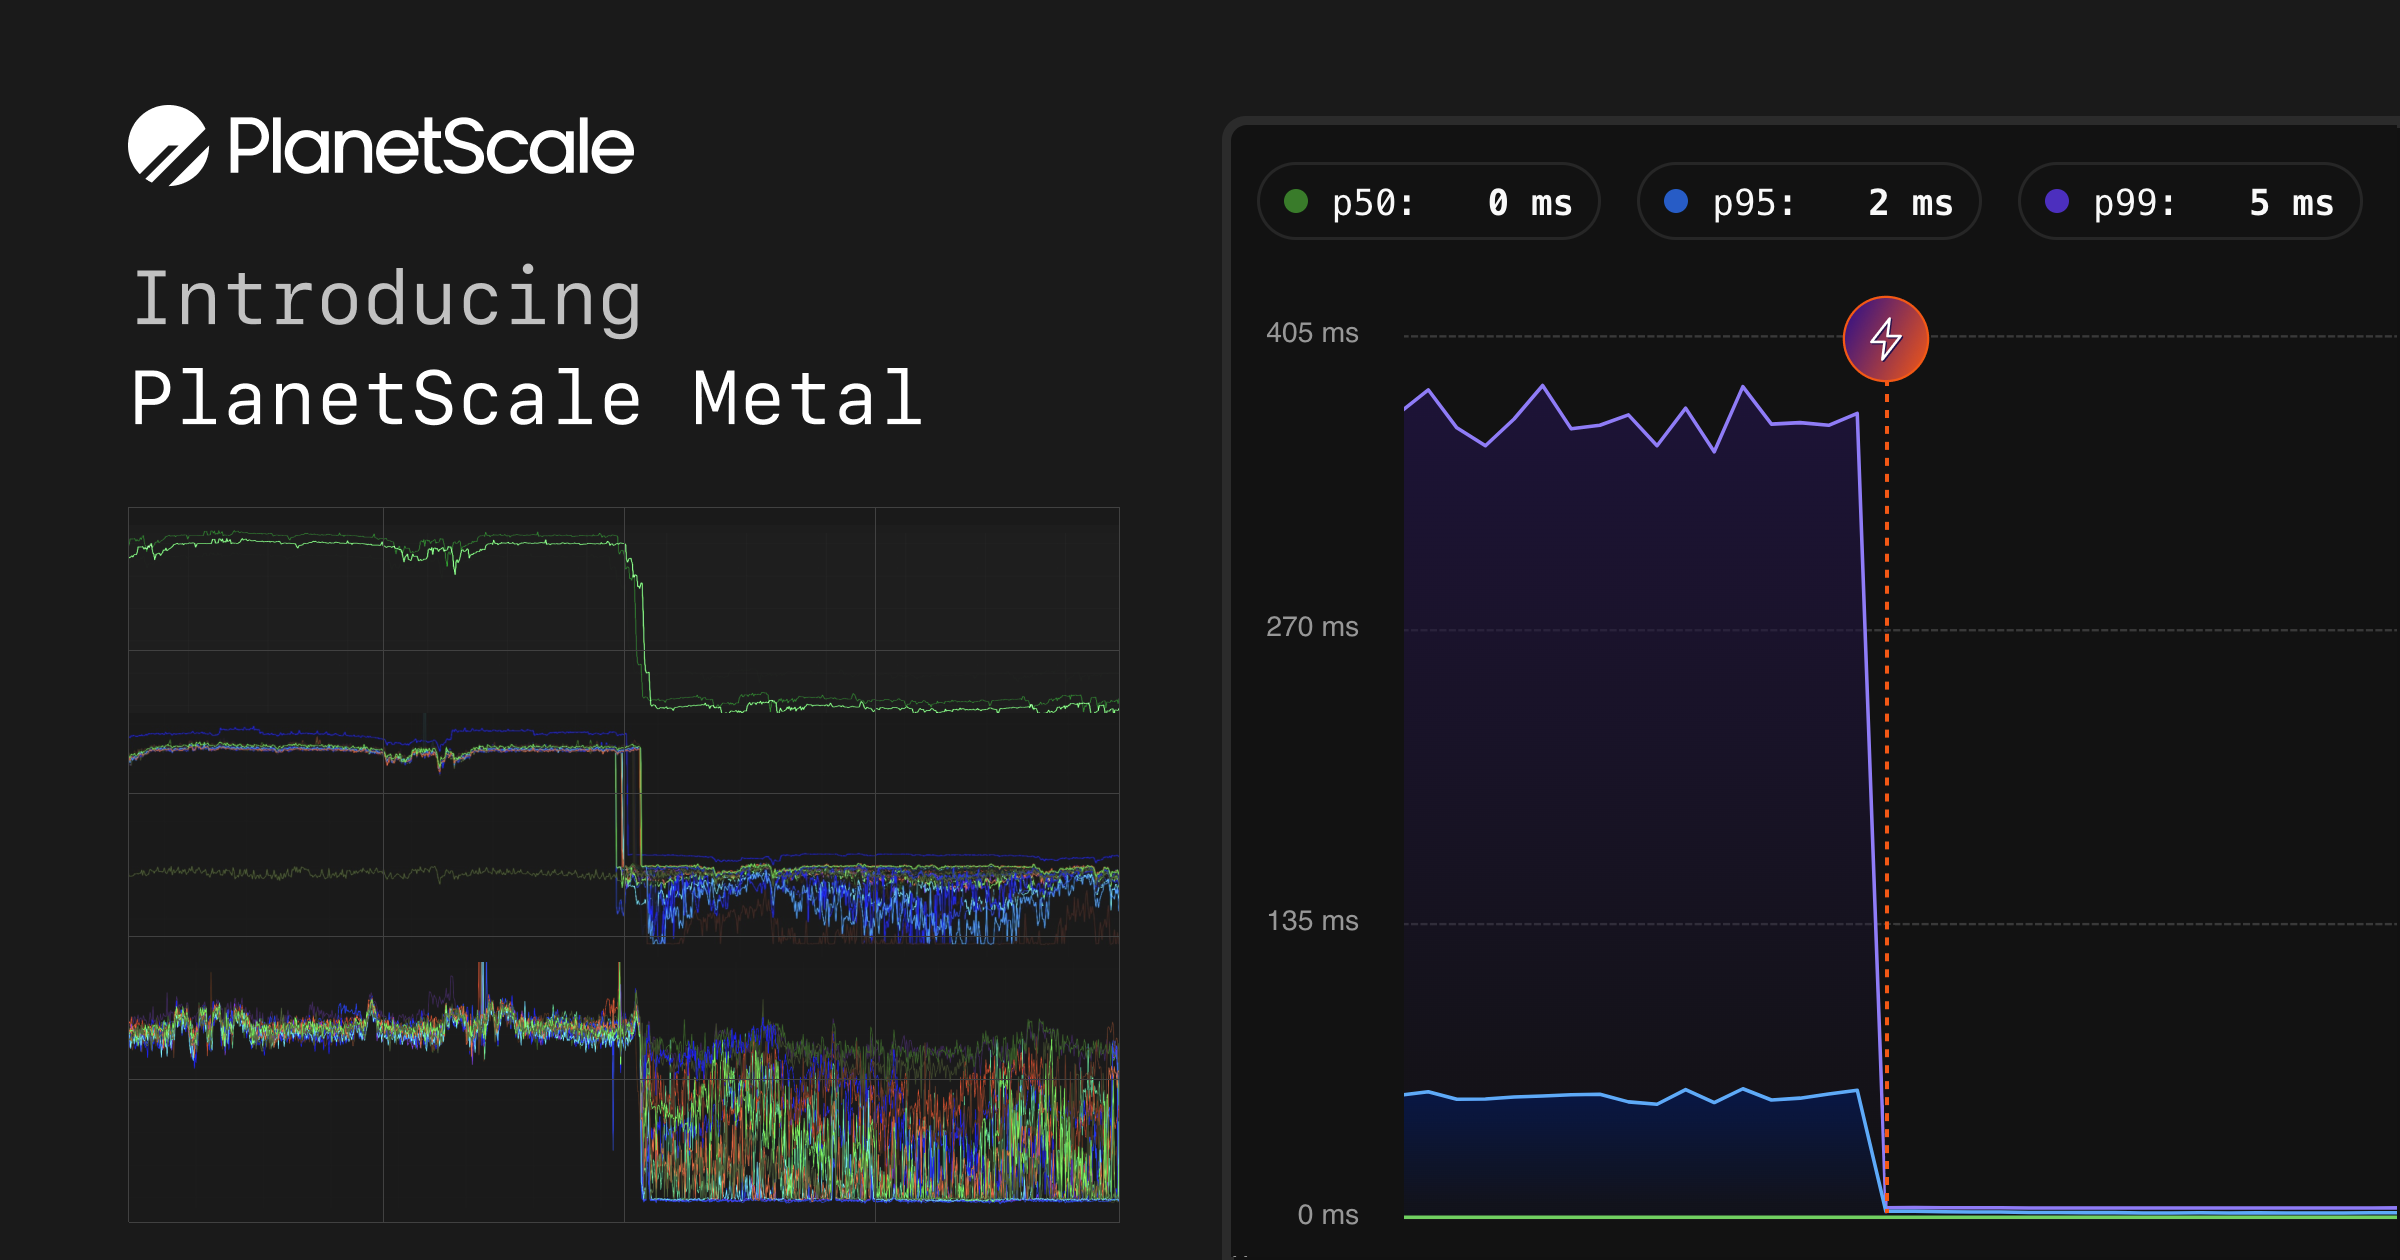
PlanetScale推出新的Metal节点,采用本地NVMe SSD,提供无限I/O,性能与成本比显著提升。经过三个月的测试,处理超过5万亿查询,查询延迟降低65%,成本节省53%。现已向所有用户开放。
随着向量嵌入规模的扩大,内存使用和查询延迟增加,导致成本上升和用户体验下降。通过低精度格式存储嵌入,可以显著降低内存需求并加快检索速度。MongoDB Atlas简化了压缩向量的创建、存储和索引,支持AI应用的高效扩展。量化技术在保持准确性的同时,压缩高维嵌入,解决了大规模AI工作负载的内存、延迟和成本问题。
最近审查生产数据库索引时发现许多未使用的索引占用大量存储。索引管理至关重要,因为它们消耗存储和CPU资源,增加查询延迟。通过特定查询可以识别未使用和重复的索引,定期审查索引是数据库维护的重要环节。
通过索引优化、数据库规范化、查询优化和云原生架构迁移,Class54数据库成功解决了查询缓慢、CPU利用率高和锁定问题,查询延迟从10-15秒降至200毫秒以下,显著提升了用户体验并降低了成本。
完成下面两步后,将自动完成登录并继续当前操作。