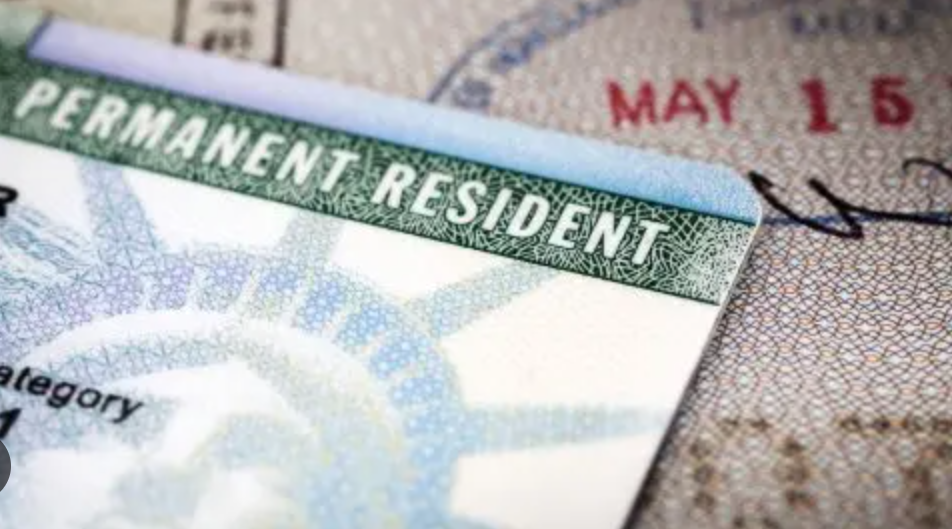


美国移民政策新规对华人家庭产生影响,特别是针对有条件绿卡持有者和婚姻移民。移民局加强背景审查,部分贷款项目不再向绿卡持有者开放,出入境监管升级,生物识别系统将追踪旅行记录。这些变化使身份稳定性和经济支持面临挑战。
本研究针对全球化和信息化背景下日益严重的虚假信息问题,提出了一种基于提示调优的事实核查价值评估分类方法。通过设计提示模板并应用于大型语言模型,该方法在有限或未标记数据的情况下显著提高了评估准确性。实验结果表明,该方法在F1分数和准确率等评估指标上超过了多种基线方法,证明了其在事实核查价值评估任务中的有效性与创新性。
Ryan与Vectara创始人Amr Awadallah讨论了检索增强生成(RAG)的进展、事实核查的重要性,以及Vectara的Mockingbird模型如何减少幻觉。Vectara是一个帮助用户构建AI助手的平台。
Meta在美国的事实核查计划即将结束,取而代之的是“社区笔记”功能。用户可以在Facebook、Instagram和Threads上撰写和评分笔记,为帖子提供额外背景信息。该功能将逐步上线,Meta仍在其他国家使用第三方核查程序,并计划未来推广社区笔记。
RePanda结合大型语言模型与pandas,实现数据表验证,准确率达到88%。该框架将自然语言声明转化为可执行代码,提供可读证据,展现出在各种表格推理任务中的强大能力。
市场监管总局针对3·15晚会曝光的违法行为迅速行动,查处卫生巾、纸尿裤等问题,强化消费者权益保护。同时,发布《人工智能生成合成内容标识办法》以规范内容标识。特斯拉研发低成本Model Y应对竞争,谷歌将用Gemini取代Google Assistant。
本研究针对在线错误信息的日益增多,评估了多种开源大型语言模型在事实核查中的有效性。通过实验发现,这些模型在识别声明与事实核查文章之间的关系及核实已核查故事方面表现良好,但在确认事实新闻时表现不佳,且引入外部知识并未显著提升其性能。这表明大型语言模型在自动化事实核查中具备潜力,但在可靠性上仍需进一步改进。
本研究探讨了在线虚假信息的挑战,特别是驳斥声明的编辑形式对嵌入模型的影响。研究提出了六种虚假信息编辑分类法,发现标准嵌入模型对这些编辑反应不佳,而大型语言模型提取的嵌入在计算成本更高的情况下表现出更强的鲁棒性和准确性,为虚假信息核查提供了改进方案。
本研究解决了自动化事实核查中多跳推理所面临的挑战,提出了GraphCheck框架,将声明转化为实体关系图以进行全面验证。通过识别多个路径中显性和潜在实体之间的关系,该方法显著提升了核查的适应性和鲁棒性,其性能优于现有的核查方法,并能广泛适用于其他相关的事实核查流程。
本研究解决了自动事实核查系统在多语言环境中的不足,尤其是在非英语语言的应用。提出的MultiSynFact是首个大规模多语言事实核查数据集,包含220万个声明-来源对,旨在支持西班牙语、德语和其他低资源语言。研究表明,该数据集生成方法有效地提升了模型在多语言事实核查中的表现,并开放源代码以推动该领域的进一步研究。
本研究提出了一种利用大型语言模型(LLMs)进行自动化事实核查的新方法,解决了传统方法效率低和资源消耗大的问题。研究表明,Llama-3模型在分类准确性和解释质量上表现优越,证据整合提升了所有模型的性能,展示了自动化事实核查的潜力。
CheckMate是一个基于Agent.ai的事实核查助手,帮助用户快速验证可疑标题和谣言。它通过聊天界面查询可靠的事实核查来源,促进批判性思维,打击虚假信息。
本研究解决了自动事实核查中索赔匹配任务的不足,首次探讨了零样本和少样本学习方法。通过使用指令跟随的大型语言模型,提出了一种新的索赔匹配数据集ClaimMatch,并展示了该任务可以通过借鉴更成熟的自然语言推理或同义句检测任务来有效处理。研究发现,这种方法对不同长度文本的评估表现良好,具有显著应用潜力。
谷歌拒绝遵守欧盟关于搜索和YouTube的事实核查承诺,并撤回自愿反虚假信息协议。谷歌全球事务总裁表示,这些要求不适合其服务且无效,尽管欧盟的反虚假信息行为准则要求与事实核查机构合作,谷歌仍不打算进行整合。
Meta旗下的Facebook、Instagram和Threads将借鉴X/Twitter的社区笔记功能,允许社区成员标记和投票帖子,以取代第三方事实核查。这一机制旨在提高内容处理速度并减少偏见,预计将在未来几个月在美国市场推出。
Meta首席执行官扎克伯格宣布停止第三方事实核查,正值特朗普即将上任之际。FCC委员卡尔威威胁对科技公司采取行动,指责其参与审查。尽管Meta可能早有此计划,但在政治压力下显得软弱。
Meta宣布将Facebook、Instagram和Threads的第三方事实核查员替换为社区笔记程序,旨在减少偏见并鼓励用户提供信息。该程序将在美国推出,同时Meta将信任与安全团队迁至德克萨斯州,并逐步放宽对移民和性别认同等话题的限制。
本研究针对大型语言模型在处理复杂逻辑查询时表现出的逻辑不一致性问题,提出了一种新的评估方法及改进策略。通过引入基于知识图谱的三个逻辑事实核查数据集,证明了当前的语言模型在复杂查询中缺乏逻辑一致性,并通过监督微调提升了其在事实核查任务中的表现。
人工智能在各领域生成内容,但信息可能不准确或过时,因此进行事实核查至关重要。核查步骤包括识别关键事实、与权威来源对比、使用元分析验证数据及检查信息相关性。可利用Google Scholar和FactCheck.org等资源进行核查,确保AI生成文本的准确性和可靠性。
本文提出了ZeFaV,一个零-shot事实核查框架,旨在提升大语言模型在事实核查任务中的表现。该框架通过提取实体关系和重组证据信息,在HoVer和FEVEROUS数据集上取得了良好效果。
完成下面两步后,将自动完成登录并继续当前操作。