小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
Dify.AI
沉浸式翻译 immersive translate
myrtle.ai VOLLO刷新梯度提升树推理STAC-ML纪录

Myrtle.ai的VOLLO推理加速器在梯度提升树STAC-ML基准测试中刷新纪录,p99延迟降低超30%,吞吐量提升至少5倍。该加速器运行于AMD Alveo V80LL加速卡,三个模型p99延迟均低于2微秒,最小模型每秒5000万次推理、延迟1.77微秒。VOLLO已支持实盘交易数十万小时,并应用于电信、网络安全及国防领域。

myrtle.ai VOLLO刷新梯度提升树推理STAC-ML纪录

全球TMT-美通国际 全球TMT-美通国际 · 2026-10-15T09:21:56Z

这是一款在线角度转换计算器,支持度、弧度、梯度三种单位互换,并提供常用角度快速输入、转换公式参考及常用角度对照表,如90°等于π/2弧度或100梯度。

角度转换计算器

老董日志 老董日志 · 2026-10-04T13:52:04Z

本系列前面八篇文章,都是在围绕SGD及其学习率讨论。而从本文开始,我们将正式进入自适应梯度算法的世界。可以说,现在所有的自适应梯度算法,都有一个共同的源头,那就是2011年的经典之作《Adapt...

让炼丹更科学一些(九):经典自适应梯度算法

科学空间|Scientific Spaces 科学空间|Scientific Spaces · 2026-09-05T08:34:00Z

一个以动量为状态变量的优化器,基本形式如下:\begin{equation}\begin{aligned}\boldsymbol{M}_t =&\, \beta \boldsymbol{M}_{...

动量的新理解:逼近特征层面的梯度下降

科学空间|Scientific Spaces 科学空间|Scientific Spaces · 2026-08-23T10:01:00Z
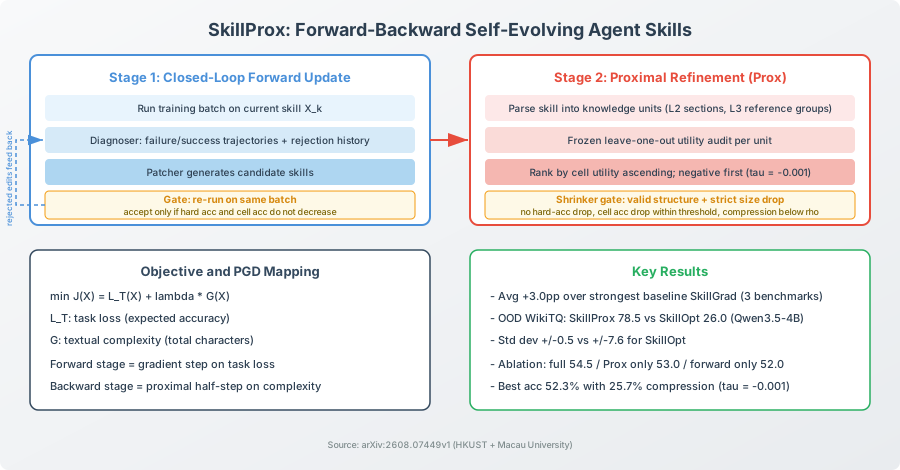
一分钟读论文:《近端文本梯度下降驱动的智能体技能自进化》

香港科技大学与澳门大学提出SkillProx框架,用于智能体技能演化,采用前向-后向双阶段优化:前向闭环诊断验证编辑效果,后向近端精炼审计并压缩冗余知识。在SpreadSheetBench、WikiTQ和HiTab基准上,相比基线平均提升约3个百分点,分布外泛化显著更稳,但评估限于结构化表格场景,存在计算开销和过拟合风险。

一分钟读论文:《近端文本梯度下降驱动的智能体技能自进化》

Micropaper Micropaper · 2026-08-17T00:00:00Z
AI论文评述:通过估计数据分布的梯度进行生成建模

本文介绍2019年Song与Ermon提出的基于分数的生成建模框架。该方法不直接学习数据分布,而是学习其分数(对数密度梯度),通过分数匹配训练噪声条件分数网络(NCSN),并用退火朗之万动力学从噪声中采样。多级高斯噪声扰动解决了流形假设和低密度区域问题,在CIFAR-10上取得先进结果,为现代扩散模型奠定基础。

AI论文评述:通过估计数据分布的梯度进行生成建模

freeCodeCamp.org freeCodeCamp.org · 2026-08-12T21:35:20Z
Agent 系统的不确定性治理:当软件工程遭遇"梯度下降" - 张善友

本文探讨Agent系统评测难题:传统软件调用链编译期确定,而Agent工具调用运行时涌现,缺乏绝对正确性参照。核心挑战是任务目标不可计算,需用代理指标近似,但方向可能偏差。工程策略非求解而是约束:用确定性DAG骨架封装不确定性,为Skill定义多维评估向量,并插入可判定的Reflection Gate。最终目标非全局最优,而是预算内“足够好且可解释”的满意解,强调可靠性胜过聪明。

Agent 系统的不确定性治理:当软件工程遭遇"梯度下降" - 张善友

张善友 张善友 · 2026-08-11T11:53:00Z

大模型训练不稳定是常见问题,表现为loss尖峰、发散或NaN。关键预警信号是梯度范数异常,而非loss本身。常用修复手段各有针对:warmup解决Adam早期方差,Pre-LN保持恒等映射,BF16扩大数值范围,梯度裁剪仅作保险丝。loss spike根因包括数值、优化和数据问题。小模型稳定超参放大后失效,因学习率安全窗口随规模收窄,可用μP等方法解决。

【Transformer 与注意力机制】36|训练稳定性:损失尖峰、混合精度与梯度爆炸

土法炼钢兴趣小组的博客 土法炼钢兴趣小组的博客 · 2026-08-08T00:00:00Z
Q-Guided Flow——RL中基于流策略的推理时梯度引导:不直接在噪声动作上求Q的梯度,也不对整条去噪链做BPTT,而是一步Euler积分且把Jacobian直接换成单位矩阵

本文讨论了QGF(Q引导流)方法在强化学习中的应用,解决了扩散和流策略训练不稳定性的问题。通过预训练参考策略和价值函数,QGF利用价值梯度引导生成高价值动作,避免复杂的反向传播,从而提升策略的稳定性和可扩展性。

Q-Guided Flow——RL中基于流策略的推理时梯度引导:不直接在噪声动作上求Q的梯度,也不对整条去噪链做BPTT,而是一步Euler积分且把Jacobian直接换成单位矩阵

结构之法 算法之道 结构之法 算法之道 · 2026-06-24T04:32:42Z

本文讨论了策略梯度方法在语言模型训练中的应用,重点介绍了REINFORCE算法。通过log-derivative技巧,策略梯度能够优化期望回报,而无需对不可微奖励求导。文章还分析了高方差问题及其在长序列和稀疏奖励中的影响,并介绍了RLOO等现代改进方法,以降低方差并提高训练稳定性。

【强化学习与大模型后训练】03|策略梯度与 REINFORCE

土法炼钢兴趣小组的博客 土法炼钢兴趣小组的博客 · 2026-05-29T00:00:00Z

关注视觉生成模型的读者都知道,FID一直是其关键的评价指标之一,它越小往往意味着生成效果越真实。那么一个自然的问题是:为什么不干脆直接以FID为损失函数来训练生成模型呢?难道是因为FID不可导?...

直接以FID为Loss:从梯度计算到流式训练

科学空间|Scientific Spaces 科学空间|Scientific Spaces · 2026-05-08T04:57:00Z
基于梯度的世界模型长时间规划

GRASP是一种新型的基于梯度的规划方法,旨在提高现代世界模型的长时间规划能力。通过提升轨迹至虚拟状态、添加随机性和重塑梯度,GRASP增强了优化过程的稳健性,有效解决了长时间规划中的脆弱性问题,提升了高维空间中的规划成功率和速度。

基于梯度的世界模型长时间规划

The Berkeley Artificial Intelligence Research Blog The Berkeley Artificial Intelligence Research Blog · 2026-04-20T09:00:00Z

文章讨论了优化器的选择与学习率的调整,指出不同任务对优化器的需求。SGD在某些视觉任务上优于Adam,学习率过小可能导致训练缓慢和局部极小值问题。此外,梯度消失与爆炸仍是深度学习中的挑战,需要理解其在现代架构中的表现。

【Transformer 与注意力机制】06|梯度下降与反向传播

土法炼钢兴趣小组的博客 土法炼钢兴趣小组的博客 · 2026-04-15T00:00:00Z
咖啡因梯度 — 演出

文章讲述了咖啡文化的演变,特别是测试协调员Vlad在瑞典办公室的咖啡经历。他通过WhatsApp引发了Yagnipedia的咖啡条目扩展,揭示了办公室咖啡的质量问题和个人对咖啡的严格标准。文章探讨了优质咖啡与劣质咖啡的转变,以及个人健康与饮食的关系,强调了对工艺的关注和咖啡文化的重要性。

咖啡因梯度 — 演出

Lifelog — A Mythology-Driven Devlog Lifelog — A Mythology-Driven Devlog · 2026-03-19T07:03:28Z

本文介绍了神经网络的结构,包括输入层、输出层和多个隐藏层,并使用激活函数(如ReLU)引入非线性。反向传播通过计算梯度和链式法则,将误差从输出层向后传播以学习参数。

CS231n 讲义 IV:神经网络与反向传播

Louis Aeilot's Blog Louis Aeilot's Blog · 2026-02-13T20:45:09Z

前面四篇文章中,我们探讨了SGD从有界域到无界域、从平均损失到终点损失的一系列收敛结论。或许有读者觉得,说来说去都还是SGD,这恐怕是“上古时代”的结果了吧?还真不是!像第四篇《让炼丹更科学一些...

让炼丹更科学一些(五):基于梯度精调学习率

科学空间|Scientific Spaces 科学空间|Scientific Spaces · 2026-01-09T02:56:00Z
梯度下降:机器学习优化的引擎

本文介绍了梯度下降的基本概念,作为一种迭代算法,它通过调整模型参数来最小化损失函数。过程包括计算梯度、更新参数和根据学习率调整步长。主要有三种类型:批量梯度下降、随机梯度下降和小批量梯度下降。学习率对优化的成功至关重要。

梯度下降:机器学习优化的引擎

MachineLearningMastery.com MachineLearningMastery.com · 2026-01-02T11:00:17Z
使用torch.compile和梯度累积加速模型训练

本文介绍了加速深度变换器语言模型训练的两种技术:使用torch.compile()优化模型性能,以及通过梯度累积实现更大的有效批量大小。torch.compile()提升执行速度,梯度累积通过多次前向传播减少反向传播次数,从而节省时间。

使用torch.compile和梯度累积加速模型训练

MachineLearningMastery.com MachineLearningMastery.com · 2025-12-25T16:44:48Z
在内存受限环境中使用混合精度和梯度检查点训练模型

训练语言模型需要大量内存,尤其是处理长序列数据。本文介绍了在内存受限环境中训练模型的技术,包括低精度浮点数、混合精度训练和梯度检查点,这些方法能有效节省内存并提升训练效率。

在内存受限环境中使用混合精度和梯度检查点训练模型

MachineLearningMastery.com MachineLearningMastery.com · 2025-12-24T17:43:03Z
FPO——流匹配策略梯度:避开复杂的对数似然计算,通过「最大化基于CFM损失计算优势加权比率」做策略优化,兼容PPO-CLIP

本文讨论了流策略优化(FPO)在强化学习中的应用,强调其通过条件流匹配损失替代传统高斯似然损失,从而提高策略表达能力。FPO有效处理多峰决策问题,适用于复杂任务,如机器人控制,并通过优化证据下界(ELBO)简化计算过程,提升学习效率。

FPO——流匹配策略梯度:避开复杂的对数似然计算,通过「最大化基于CFM损失计算优势加权比率」做策略优化,兼容PPO-CLIP

结构之法 算法之道 结构之法 算法之道 · 2025-11-25T09:59:55Z
  • <<
  • <
  • 1 (current)
  • 2
  • 3
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。

1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
友情链接: MOGE.AI 九胧科技 1tok 菜鸟教程 Remio.AI DeekSeek连连 53AI 神龙海外代理IP IPIPGO全球代理IP 东波哥的博客 匡优考试在线考试系统 开源服务指南 蓝莺IM Solo 独立开发者社区 AI酷站导航 极客Fun 我爱水煮鱼 周报生成器 He3.app 简单简历 白鲸出海 T沙龙 职友集 TechParty 蟒周刊 Best AI Music Generator 模力方舟 Gitee AI

小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码