选择美颜SDK时,优先级应根据应用场景而定。直播场景重视处理延迟,拍照场景关注效果精度,中低端设备需考虑模型大小和内存占用,多平台产品需确保效果一致性。构ZegoEffects在这些方面表现优异,开发者应根据核心场景确定优先级。
本文探讨了通过双向长短期记忆网络(bi-LSTM)提高语言识别准确性的方法。研究表明,该方法在字符级别处理语言识别,错误率降低15%至60%,模型大小减少40%至80%。这改善了苹果平台的多语言输入体验,提升了自动纠正和预测功能。
近年来,AI实验室通过增加参数、数据和计算能力推动大型语言模型(LLMs)发展。然而,AI界开始质疑这种方法是否已到极限,或需新范式。谷歌DeepMind的Chinchilla模型表明,训练数据的充分性比模型大小更为重要。尽管取得成功,专家担心规模法则的边界已现,未来可能需要新的思维模型和计算方法以推动AI进步。
本研究系统评估了量化推理模型,发现W8A8或W4A16量化可实现无损,但较低比特宽度会影响准确性。模型大小、来源和任务难度是影响性能的关键因素,适当调整模型规模或推理步骤可提升性能。
宝可梦3D API v0.2.1发布,模型大小显著减少至127MB,性能提升,修复JSON路径错误,增加优化文档,支持自动化优化,改善加载速度和移动设备性能。开发者应更新项目以利用这些改进。
本研究提出了一种基于条件互信息的结构化滤波器修剪方法,旨在解决深度卷积神经网络在资源有限硬件上的部署问题。该方法有效减少模型大小,且准确率几乎不变。在CIFAR-10数据集上,VGG16的滤波器数量减少超过三分之一,准确率仅下降0.32%。
本文研究了语言模型性能与交叉熵损失的关系,发现模型大小、数据集规模和计算量之间存在幂律关系。提出了神经缩放定律,强调训练数据和模型参数对测试损失的影响。通过分析485个预训练模型,提出了提高预测准确性的最佳实践,为模型选择提供参考。
本研究探讨音乐生成模型是否编码西方音乐理论。通过SynTheory数据集,提出框架检验模型对音乐理论概念的编码能力,发现模型大小和层次影响可检测性。这一发现推动音乐生成技术在理论理解和应用方面的进步。
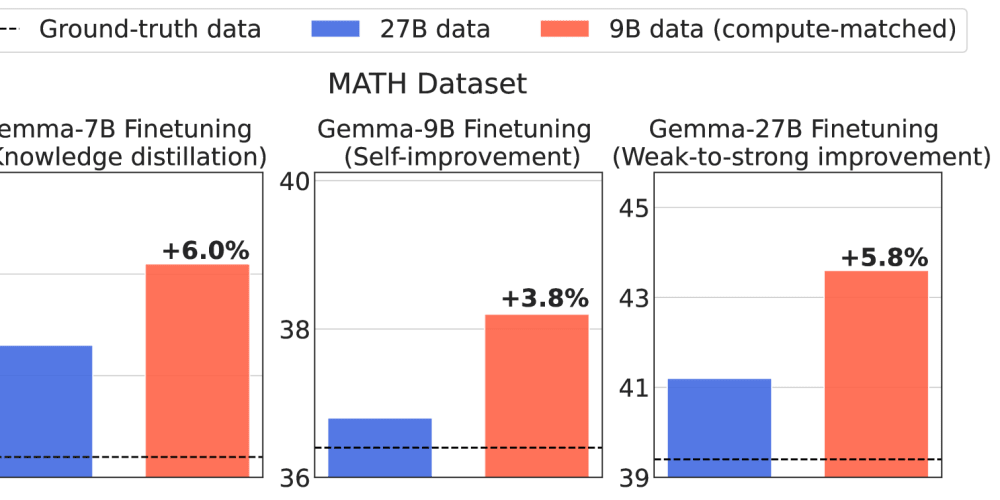
这篇文章介绍了一种名为“计算优化采样”的新训练方法,可以提高大型语言模型(LLMs)的推理能力,同时减小模型大小和计算需求。研究表明,这种方法可以在一系列推理任务上比较大且更强大的模型表现更好。文章认为,计算优化采样是一种有前景的技术,可以开发更高效和能力更强的人工智能系统。
本文探讨了卷积神经网络的量化技术,指出逐通道和逐层量化可以显著降低模型大小并保持高准确率。介绍了量化网络的基准测试,量化实现速度提升2至3倍。强调量化在深度神经网络高效部署中的重要性,并展示了新方法AdaQAT在训练中的优势。
本文研究了语言模型性能与交叉熵损失之间的关系,发现损失与模型大小、数据集大小和计算量呈幂律关系。通过训练大型模型和适量数据可以实现最优效率。此外,研究表明迁移学习能够改善未标注数据的性能,并提出了基于参数、数据和计算的可预测缩放规律。
3D高斯喷涂技术的修剪方法优化了渲染性能,保持高质量。新方法Pixel-GS和GaussianPro通过考虑像素覆盖和先验知识,提升了重构精度和效率。EfficientGS在高分辨率场景中显著减小模型大小,同时保持渲染保真度。SRGS方法通过亚像素约束增强表示能力,实现高质量渲染。Scaffold-GS动态布局3D高斯,减少冗余,提升渲染质量。
随着开源LLM的成熟,业务接入LLM推理需考虑显卡和模型大小。选显卡需看VRAM容量和CUDA核心数,推荐12GB起。模型大小需根据需求选硬件,如20B适用于低规格设备,400B适合数据中心级硬件。模型优化技术可降低资源需求。
本文研究了自动生成摘要与源文件不一致的问题,发现现有的一致性指标存在限制。通过对11个大型语言模型进行实际一致性评估,引入TreatFact数据集,并分析了模型大小、提示、预训练和微调数据的影响。研究发现,开源模型性能较差,但通过增加模型大小、扩展预训练数据和开发精心策划的微调数据,有潜力提升性能。实验结果表明,先前的方法和基于大型语言模型的评估器无法捕捉到临床摘要中的实际不一致性,给评估提出了新的挑战。
该论文介绍了一种针对边缘计算环境中深度神经网络的块剪枝方法,有效地减小模型大小并保持高准确性,尤其适用于资源有限的边缘计算场景。
本文强调了基础模型在深度学习中的重要性,以及模型大小和训练数据对AI开发的影响。基础模型在各种任务中表现出色,并通过改进不断提升性能。然而,模型的单一化可能导致对AI权力和控制的转移,并出现新的行为方式。
大型语言模型(LLMs)在上下文学习(ICL)方面展示了显着的能力,通过少量训练示例学习新任务。研究发现黄金标签对下游上下文性能有显著影响,不平衡标签对ICL影响较小。ICL对标签扰动的敏感性较低,随着模型大小的增加,ICL逐渐获得与SL相当的性能。
大型语言模型(LLMs)在上下文学习(ICL)方面展示了显着的能力,通过少量训练示例学习新任务。黄金标签对下游上下文性能有显著影响,不平衡标签对ICL影响较小。ICL对标签扰动的敏感性较低,随着模型大小的增加,ICL获得与SL相当的性能。
裁剪的小型语言模型在信息检索任务中表现出强大竞争力。压缩和稠密模型在实际应用中更受欢迎,但模型大小和早期查询文档交互对泛化能力有重要影响。增加模型大小对相同领域测试数据集几乎没有增益,但在新领域上有更大提高。reranker在几个任务中优于稠密模型。最大reranker在18个数据集中的12个达到最先进水平,平均超过以前最优结果3个点。域内有效性是零-shot有效性的好指标。
大型语言模型(LLMs)在上下文学习(ICL)方面展示了显着的能力,通过少量训练示例学习新任务。研究发现黄金标签对下游上下文性能有显著影响,不平衡标签对ICL影响较小。ICL对标签扰动的敏感性较低,随着模型大小的增加,ICL获得与SL相当的性能。
完成下面两步后,将自动完成登录并继续当前操作。