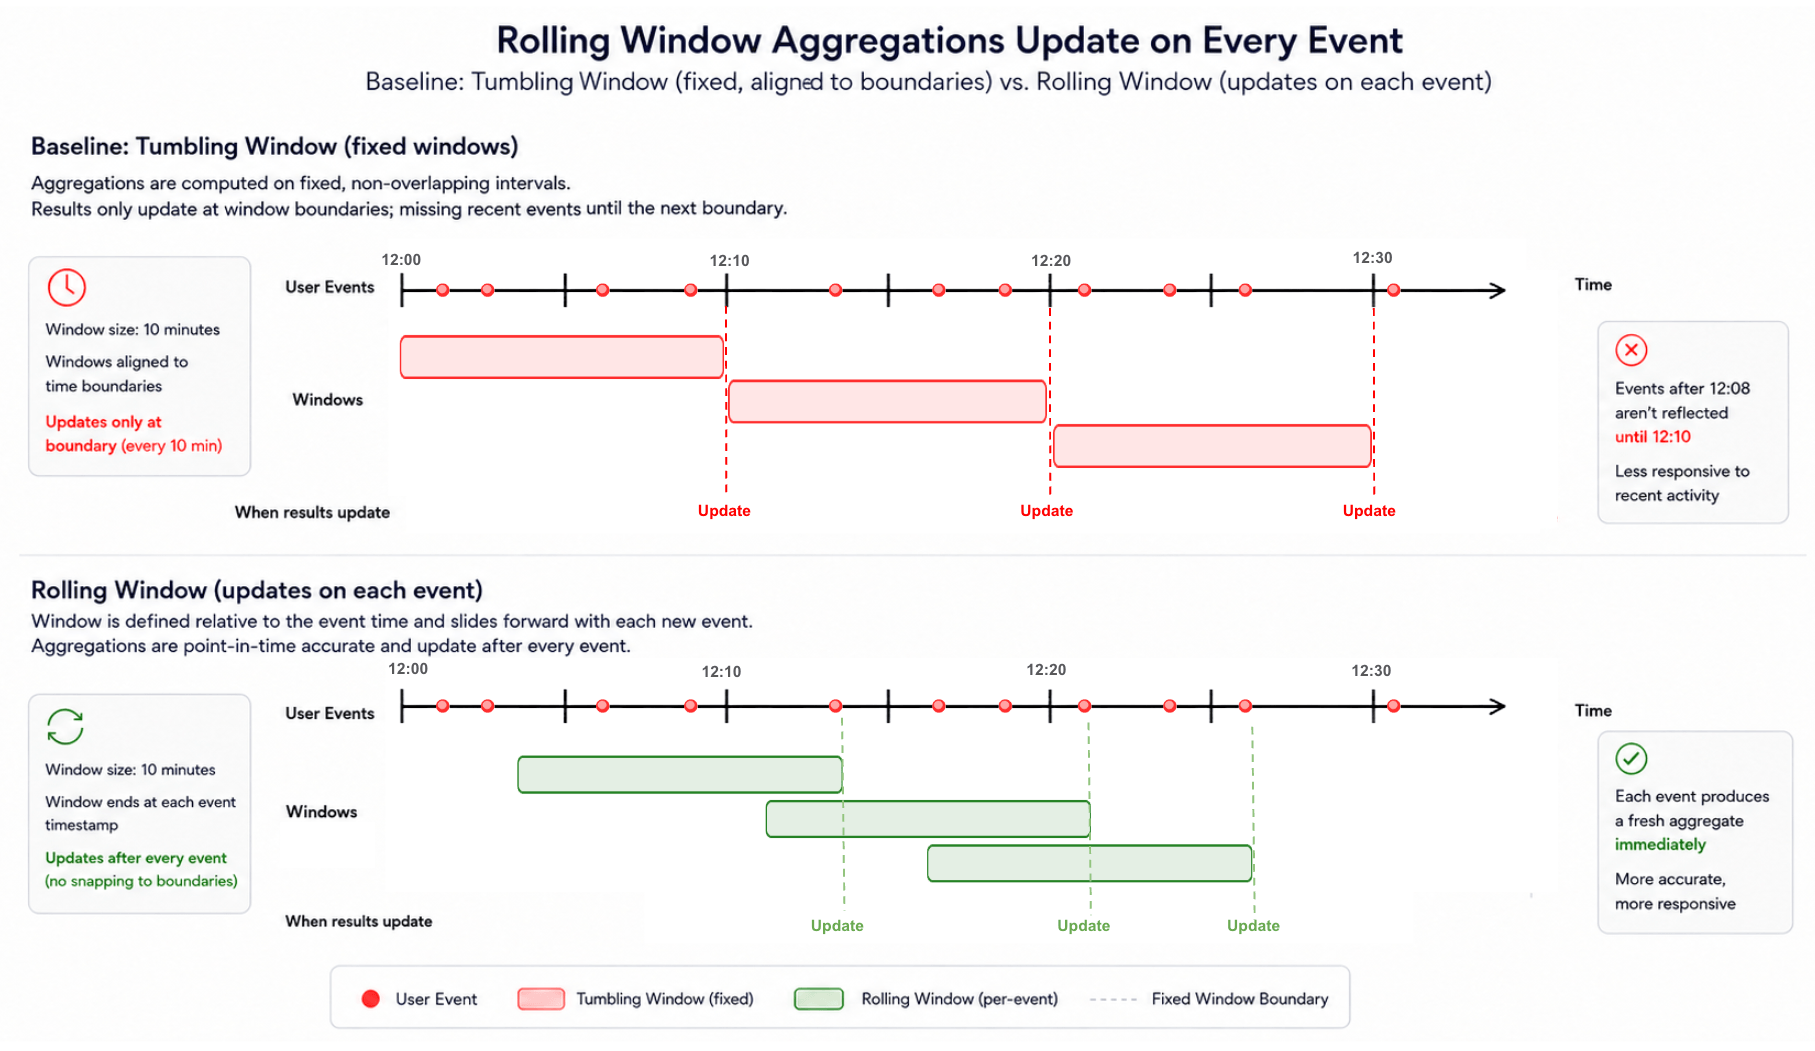



Databricks Feature Store通过Spark RTM、Lakebase和Model Serving实现亚秒级特征新鲜度,端到端延迟200毫秒。它支持滚动窗口聚合,实时处理Kafka事件,减少WAL放大,并自动检索特征供模型推理。该平台简化基础设施,提供治理和血缘追踪,适用于欺诈检测等实时ML场景。
本地AI代理实验:用户用799美元Mac mini M4 24GB运行Hermes Agent和Qwen3.8-27B模型,夜间花1小时42分钟生成AI新闻播报,全程本地推理、零API费用。对比RTX 5090,速度慢30倍但成本低,电费不足一美分。文章分析显性成本(硬件、电费)与隐性成本(调试时间、折旧、机会成本),并质疑模型基准真实性,探讨速度与数据主权的权衡。
本文探讨了如何将开源语言模型转化为可用的API服务,涵盖模型推理、请求调度和显存管理等技术细节。强调了LLM推理过程,包括输入文本和生成下一个token的预测,介绍了模型生命周期、文件结构、量化技术及其对显存的影响,并讨论了服务框架选择和并发处理的重要性。
本文讨论了通过调整 llama.cpp 的采样参数(如温度、TopP、MinP、TopK)来提高模型推理速度和效果,减少重复、幻觉和语法降解。强调现代采样方法(如 DRY、XTC 和 Mirostat)的优势,合理配置可显著提升本地模型的生成质量和效率。
低精度算子(如INT8/FP8)在大模型推理和训练中至关重要,能够显著减少访存和提高算力。量化通过将浮点值映射到低位宽整数,采用对称或非对称量化方式。粒度选择影响精度,per-channel量化能更好保留精度。反量化应尽量晚进行,以减少精度损失。设计时需注意累加精度、舍入方式一致性和离群值处理等问题,以确保数值正确性。
AI实时语音技术中的延迟问题影响用户体验,主要源于网络传输和模型推理。通过就近接入、智能路由和流式推理等策略可以有效减少延迟,同时客户端的自适应缓冲和抢先播放也能提升体验。未来,随着技术进步,AI语音的延迟将进一步降低。
文章讨论了在Linux平台上使用Intel UHD 600核显和OpenVINO进行轻量模型推理的尝试。由于UHD 600的OpenCL版本仅为1.2,无法支持OpenVINO所需功能,导致模型加载失败。结论是需要更换为支持OpenCL 2.0以上的设备。
本文介绍了如何在PyTorch中实现自定义操作,包括使用C++和CUDA编写自定义函数和类。通过示例代码,展示了如何注册和使用这些自定义操作,确保它们在PyTorch模型和AOTInductor编译的推理程序中正常工作,并讨论了模型导出及推理验证。
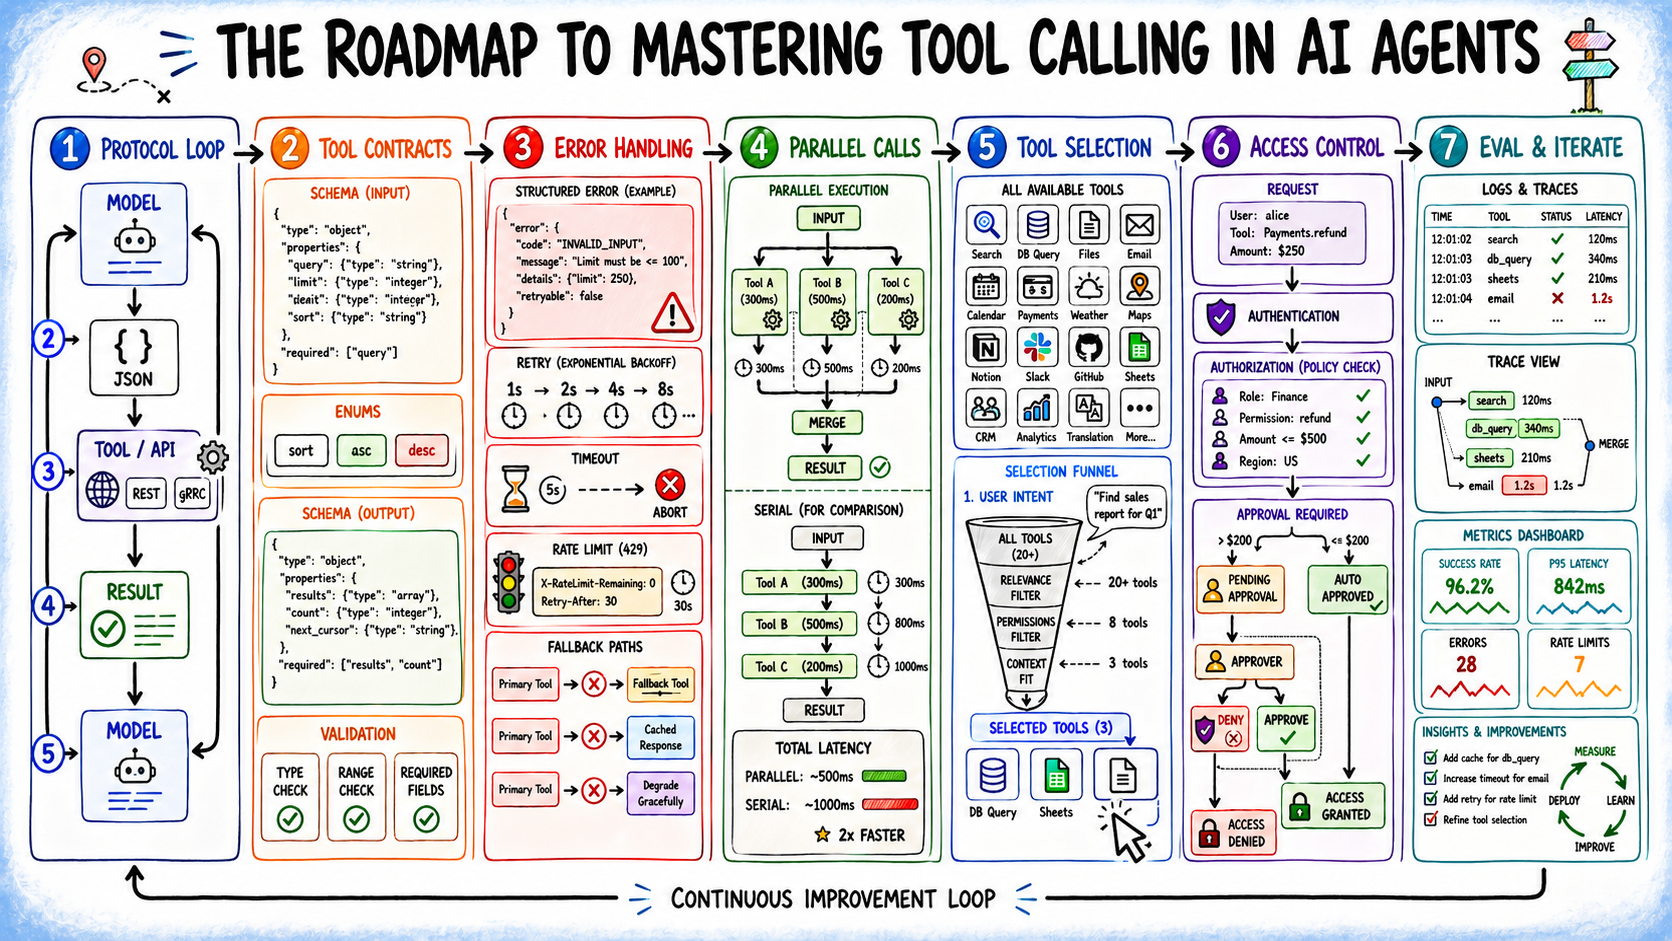
本文探讨了AI代理中掌握工具调用的关键步骤,包括理解工具调用协议、编写工具定义、构建错误处理机制、战略性并行调用、管理工具目录规模、设计安全性和评估工具调用。强调模型推理与执行的分离,以提高代理的可靠性和效率。
Kimi于2026年4月21日发布了K2.6,专注于长周期编程,具备在复杂工程中持续工作和自我优化的能力。K2.6在模型推理和金融引擎优化方面表现出显著的性能提升,企业反馈强调其可靠性和精准性。其开源特性使开发者能够本地部署,降低了开发门槛,推动了国产模型在Agent领域的进步。这标志着AI编程工具的选择将更加注重适用场景。
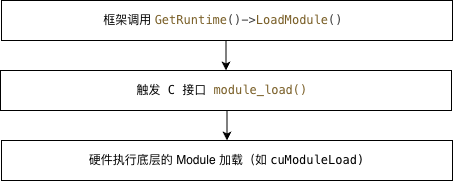
飞桨推出插件式CUDA兼容硬件接入方案,模型推理速度提升2.2倍。通过C接口实现CINN编译器与硬件解耦,支持动态注册,降低适配成本,促进国产芯片融入AI生态。
COMI团队提出了一种新型长文本压缩方法,通过边际信息增益(MIG)优化相关性与多样性,解决了高压缩率下性能下降的问题。在32倍压缩下,该方法显著提升了模型推理能力,确保多样化信息的保留,推动了大模型的轻量化与实用化。
PPIO近日获得InfoQ 2025年度AI基础设施卓越奖,因其在分布式算力调度和模型推理加速方面的技术贡献。该奖项旨在表彰在AI创新和产业落地中表现突出的企业。PPIO通过整合多款开源模型和自研技术,提升Agent开发效率,推动AI行业发展。
Apple硅芯片的Mac在AI开发者中越来越受欢迎,MLX框架使得在Mac上高效运行大型语言模型成为可能。MLX支持神经网络的训练和推理,利用M5芯片的神经加速器提升性能,提供更快的模型推理体验,支持Python、Swift及C/C++等多种语言的简单安装和使用。
flash-linear-attention 是一个高效的线性注意力模型集合,支持多平台运行,集成多种最新模型,优化内存消耗,便于扩展和部署。PaperVision 提供用户友好的节点编辑器,适合计算机视觉算法实验。UniswapX 是无 Gas 费用的 ERC20 交换协议,提升交易效率。mpt-30B-inference 支持在 CPU 上运行 MPT-30B 模型推理,推荐使用 Docker 和 Python 3.10。
提示词工程是构建AI应用的基础,连接人类意图与大语言模型。它包括结构设计、工程流程和输出塑形,分为结构层、方法层和输出层。提示词由任务描述、行为规约和输出约束组成,影响模型推理。工程流程包括试运行、评估和优化,推动其向多模态和智能体扩展。
ai-cookbook 是一个开源项目,提供构建人工智能系统的示例和教程,包括可复制代码。rag-from-scratch 旨在帮助理解检索增强生成技术,提升模型推理能力。hack-together-dotnet 鼓励开发者构建云原生和 AI 应用,并提供微软专家指导。games 是 Flutter 游戏工具包,包含多种休闲游戏模板。onepixel_backend 是一个 API URL 缩短器。
remote-jobs 是一个汇总支持远程工作的科技公司列表,帮助求职者寻找合适职位。amazon-q-developer-cli 是一个命令行工具,用于自然语言应用开发。awesome-entra 收集了 Microsoft Entra 相关资源。GPTFast 加速 Hugging Face 模型推理,JettonGramGpuMiner 用于挖掘 GRAM 代币。
本文介绍了如何为机器学习应用程序实现用户管理和身份验证系统,以确保安全性。通过创建用户和分配访问权限,管理员能够有效管理用户访问,降低安全风险。应用程序基于FastAPI框架,支持API密钥认证,允许用户进行模型推理。设计包括用户创建、删除功能及模型信息访问,确保安全性和可扩展性。
谷歌云为Cloud Run无服务器平台推出GPU支持,助力开发者加速模型推理。本文介绍如何在GPU基础的Cloud Run上部署Llama 3.1大语言模型,步骤包括环境初始化、部署TGI模型服务器和推理测试。
完成下面两步后,将自动完成登录并继续当前操作。