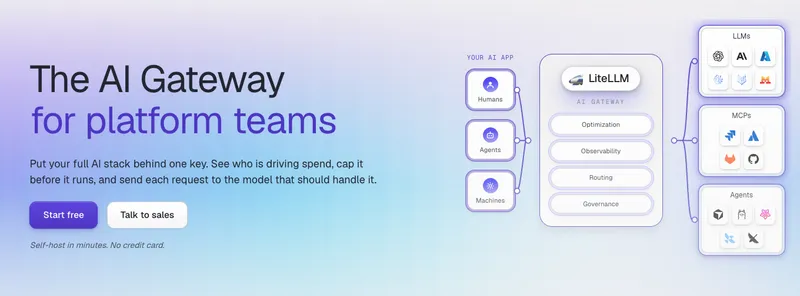


本文介绍了作者搭建LiteLLM网关,统一管理多个大模型接口,供Hermes使用。配置了PostgreSQL、Redis、Traefik和ArgoCD,并分享了Kustomize管理配置、Redis缓存及部署中的坑。文章强调通过模型映射切换底层模型,无需改动客户端,并计划后续补充健康检查等功能。
Visual Studio 18.9 Insiders 2 新增“思考力度”控制,用户可按任务复杂度调整模型推理级别(低/中/高/超高/最大),简单问题用低档省积分,复杂问题用高档加深推理。设置位于模型管理窗口,与能力、成本并列。该功能优化答案匹配度并控制AI积分消耗,提升日常开发效率。
Unity AI Gateway 通过统一目录提供对各种模型的访问,包括Meta的新模型Muse Spark 1.1。用户可以集中管理API密钥,确保安全和合规。注册模型后,团队可实时跟踪请求和支出,使用熟悉的权限和监控功能。该服务支持AWS、Azure和GCP,旨在简化模型的使用和管理。
AI编排是管理多个AI模型的层,负责任务路由、状态管理、工具调用和重试机制,确保任务按顺序执行并避免冲突。它协调不同AI的工作,处理复杂的多步骤任务。设计时需考虑模型的不确定性,确保流程稳健,避免因模型错误导致的失败。选择工具时应关注实际需求,保持简单有效。
VisualIdentity是一款开源免费的视觉识别API服务,旨在帮助开发者解决模型管理和多任务识别的问题。它具备现代化能力和高性能推理,支持多模型管理、单机多任务识别及跨平台部署,适用于工业质检、零售分析和智能安防等场景。
CodexSwitch 是一个本地代理,允许 Codex App 连接多个模型,如 DeepSeek。它通过协议转换和请求路由,保持 Codex App 的使用体验,同时支持灵活切换模型。用户可以在本地面板查看用量和成本,适合需要多模型管理的开发者。
MLOps与DevOps的主要区别在于,MLOps专注于机器学习模型的生命周期管理,包括数据处理、模型训练和监控。MLOps需要处理数据、模型和代码的版本控制,确保模型在生产环境中的稳定性和可靠性,并应对模型漂移问题,自动触发模型再训练。有效的沟通和文档共享对团队协作至关重要。
2026年的大型语言模型操作(LLMOps)已成为完整的生产系统,团队需要多种工具来支持模型的管理与监控。文章列出了十种必备工具,如PydanticAI、Bifrost和OpenLLMetry,分别用于输出安全、API路由、可观察性、测试和内存管理等功能。这些工具帮助团队在生产环境中高效连接、评估和改进模型。
MLflow是管理机器学习生命周期的标准工具,提供可重复和可扩展的架构。新课程教授如何将模型从研究转入生产,涵盖实验跟踪、模型参数管理及LLM运维等内容,并通过与Databricks和Hugging Face的集成,掌握企业级模型服务与监控技能。
红帽公司推出了全新的AI企业平台(RHAE),旨在整合AI生命周期,支持混合环境中的模型和应用管理。该平台与NVIDIA合作,提供高性能推理和模型定制,助力企业实现大规模AI生产。同时,红帽发布了AI 3.3版本,增加了多种模型支持和自助服务功能,以提升AI在大型组织中的使用效率。
Docker在构建自主AI系统中提供了可组合的基础设施。Docker Model Runner使用户能够轻松运行和切换模型,Docker Compose简化了多个模型的管理,Docker Offload支持在云端运行大型模型,提升本地开发体验。模型上下文协议服务器优化了代理功能。整体而言,Docker为构建模块化的AI应用提供了强大支持。
Heroku更新了Managed Inference和Agents,推出新标准计划,简化模型管理,支持Claude 4.6等新模型,提升开发者体验,鼓励用户迁移以获得最佳性能。
谷歌在BigQuery推出了第三方生成AI推理功能,允许数据团队通过SQL部署Hugging Face或Vertex AI模型。该功能简化了模型管理,自动配置计算资源,用户只需两条SQL语句即可创建和运行模型,并支持自定义设置,兼容13,000多个Hugging Face文本嵌入模型,提升了数据分析和工程师的效率。
该项目基于.NET 10架构,结合YoloDotNet推理引擎与SQLite存储,旨在解决多任务视觉识别中的模型管理与协同部署问题。提供智能识别平台,支持多模型管理与跨平台部署,降低AI应用落地门槛,助力开发者创新。
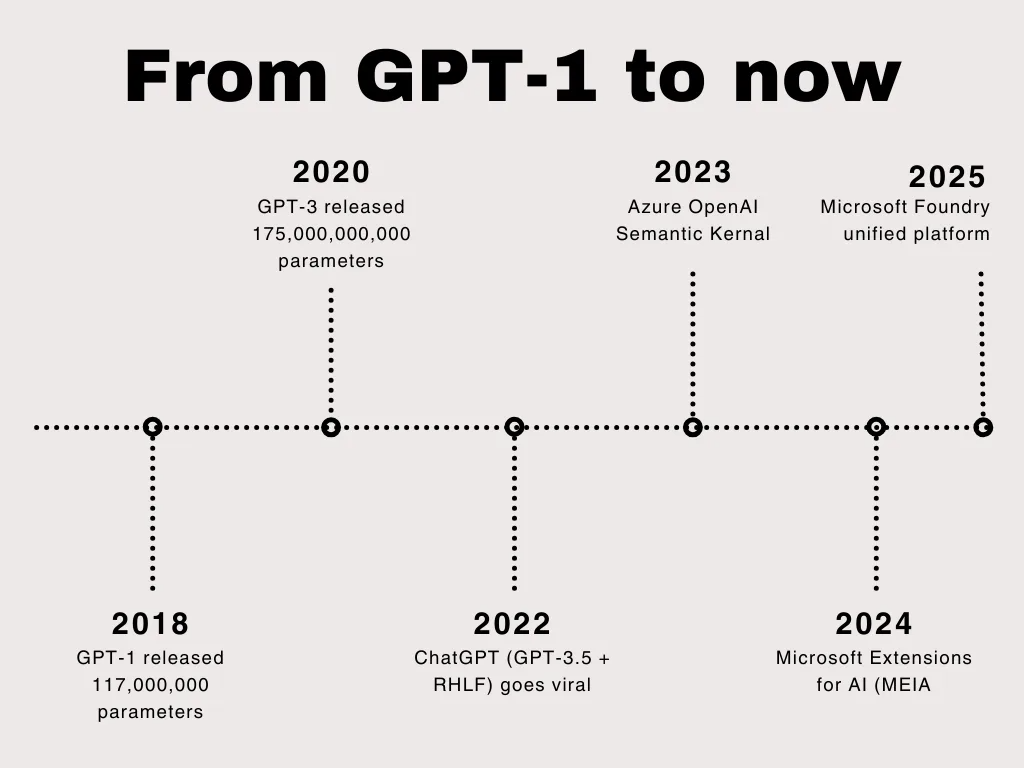
生成式AI迅速崛起,ChatGPT在短时间内吸引了1亿用户。微软推出Azure OpenAI服务,支持开发者使用AI模型。文章探讨了AI术语、生成式AI的定义及其在.NET/C#开发中的应用,强调模型管理和工具整合的重要性。
AI PaaS(人工智能平台即服务)为开发者提供云平台,简化AI应用的构建、部署和运营,结合传统PaaS的可扩展性与安全性,增加模型访问和数据检索等AI特定功能,解决AI项目生产中的难题。
Apache TVM是一个支持多种硬件的深度学习编译框架,其远程过程调用(RPC)功能提升了开发效率,允许在远程设备上运行神经网络模型。RPC系统由追踪器、代理和服务器组成,简化了模型管理与执行。设置过程需安装和配置相关组件,并确保环境变量正确。故障排除时可通过创建虚拟numpy解决依赖问题。
LinkedIn重新设计了边缘构建系统,以支持多样化的推理工作流,提供更及时和个性化的推荐。新架构满足实时扩展、成本效率和灵活性需求,结合离线、近线和在线推理,提升推荐的相关性和多样性。通过嵌入式检索和模型管理,LinkedIn提高了实验效率和用户参与度。
GitHub对大文件有严格限制,单个文件超过100MB无法提交。使用Git LFS可解决此问题,但免费额度仅1GB,超出需付费。建议将大型模型文件存储在HuggingFace等平台,保持代码与模型分离,以便于管理和协作。
Llama-Swap是一个轻量级开源代理服务器,允许用户在本地轻松切换多个大型语言模型(LLM)。它通过监听API请求,自动管理模型服务器,简化了模型管理。用户只需配置YAML文件,即可在一台机器上运行多个模型,提高资源利用率和灵活性。
完成下面两步后,将自动完成登录并继续当前操作。