Chat SDK 代理现可通过 json-render 流式生成 UI:代理按类型化组件目录写出 JSON 规格,再转换为 Chat SDK 卡片,各适配器以平台原生格式(如 Slack 的 Block Kit、Teams 的 Adaptive Cards)发布。目录涵盖表格、图表、按钮等,无需为每种消息形态单独开发工具。streamCard 在根元素有内容后发布卡片,并随新元素流入更新消息,默认每 500 毫秒编辑一次;流结束后显示最终校验过的卡片。toCard 会按组件模式校验属性,无效时抛出 CardSpecError 并列出问题,便于让模型修正。平台对单条消息有容量上限,可传入限制拒绝超限规格。
本文以 Koog 1.3.0 的 Kotlin API 为例,讲解模型调用的输入与输出。输入方面,user 消息可混排文本与图片、音频、视频、文件等附件,但多模态支持取决于 provider 和模型能力,例如 DeepSeek V4 Flash 不支持 document 附件。参数方面,LLMParams 可在 prompt、子图、会话三层生效,包含 temperature、maxTokens、toolChoice、schema 等字段,并有构造期校验。输出方面,流式调用 requestLLMStreaming 返回 Flow<StreamFrame>,可用 collectText 拼接文本,也可边流式边解析 Markdown 为对象;结构化输出用 data class 加注解生成 schema,requestLLMStructured 返回 Result,解析失败可由 StructureFixingParser 自动修复。文中还提及 Anthropic 与 Bedrock 的提示词缓存配置差异。
Sentry JavaScript SDK v11 为所有 JS 平台引入追踪,以源码转换和诊断通道取代 OpenTelemetry 的 Node 模块加载器,支持 Cloudflare Workers、Bun、Deno 及打包部署。Unreal MCP 让编码代理驱动 UE5.8 编辑器,自动配置 Sentry、上传调试符号并定位崩溃。文章还比较了 Seer、Sentry MCP、CLI 与编码代理的适用场景。
vLLM-Omni流式TTS需区分首包延迟(TTFP)与端到端时间。官方在H200并发1下测得,异步分块加流式使TTFP从733ms降至64ms,但端到端升至941ms。优化应按场景选目标:互动产品保TTFP与连续播放,离线产品保RTF与成本,并关注分片大小、协议完整性与内容质量。
苹果设备端听写依赖神经音频编码器作为分词器,其参数量影响内存、功耗与延迟。研究提出潜空间蒸馏压缩法:以量化前的潜表示为目标,仅训练学生编码器回归教师逐帧潜表示,并用仿射层对齐宽度。2.8倍压缩下,六组师生中五组相对WER仅差1.9%,优于同容量独立训练编码器3.9%。
流式JSON报错源于逐块解析,正确做法是按事件仅收集文本增量,拼接后在流结束再解析校验。文章以Gemini结构化流式输出为例,给出Pydantic模式与代码,强调处理背压、断线重试、跳过未知事件,且校验通过前不得触发业务。
本文介绍如何利用 Amazon DynamoDB 的租约机制构建弹性实时 WebSocket 工作节点集群:通过条件写入实现分布式锁,保证每个连接仅由一个工作节点持有;借助心跳续约检测故障,租约过期后由对账循环自动接管,实现秒级故障转移;支持优雅关闭以实现低停机部署,并利用 CloudWatch 指标驱动自动扩缩容。
近一年,NVIDIA与Google公开了四项说话人分离专利,推动该技术从离线批处理转向流式处理,并引入大模型纠错。此技术旨在解决转写中“谁在何时说话”的难题,减少人工核对时间。落地机会在于为转写交付方开发质检插件,提供工具订阅和一次性审核服务,但需注意大厂内置功能的竞争风险。
部分模型不通过标准 tool_calls 返回工具调用,而是将 DSML/XML 标记混入文本流,导致代理循环收不到工具事件、界面显示乱码。文章提出跨分块流式 DSML 恢复状态机:检测前缀后进入捕获模式,缓冲并拼接分块标签;识别用户示例时禁用恢复,原生调用与文本冲突时失败关闭;解析后校验工具名与 JSON Schema,合成标准工具调用事件,交由代理循环执行。
本文介绍AOTInductor(PyTorch编译器后端)如何将模型权重存储在共享库外,并在推理时线程安全地更新权重。通过设置`package_constants_in_so`为False、`freezing`为False及`always_keep_tensor_constants`为True,权重可外部保存。C++端使用`load_constants`加载权重到非活动缓冲区,再通过`swap_constant_buffer`和`free_inactive_constant_buffer`实现双缓冲安全交换,支持热更新,避免GPU内存峰值。
MCP最新路线图旨在将AI Agent从“工具调用者”升级为“独立行动者”,涵盖五大优先领域:统一长任务消息系统、用HTTP取代stdio、渐进式工具发现、标准身份与委托权限,以及生成SDK。目标是让Agent具备独立身份、远程运行和高效协作能力,但仍有缓存冲突、隐私边界等未解难题,需社区共同探索。
本文介绍如何构建一个始终在线的流式AI代理,用于监控维基百科实时编辑流并检测恶意编辑。系统采用两阶段漏斗设计:第一阶段用廉价Python逻辑过滤大多数无关编辑,第二阶段仅对可疑事件调用本地LLM(通过Ollama)进行深度分析。代理支持实时流式输出推理过程,并通过SSE广播给客户端。文章强调效率、自动重连和优雅降级对始终在线系统的重要性。
本文调研实时多模态视频模型,提出L0-L3能力分级,区分“支持视频”的四种层次。核心在于“可流式性”插入的层级:客户端采帧、分块编码、共享时间轴、显式触发、异步思考、模态专家或原生AV2AV。文章分析Qwen3.5-Omni、MiniCPM-o、ROMA、DuplexOmni、ELLSA、Wan-Streamer等方案,强调真正的实时取决于状态增量更新、说话时机可学习及音视频因果生成,并给出选型建议。
AI Gateway新增流式转录功能,支持边捕获音频边输出实时转录结果,降低延迟,适用于实时字幕和语音输入。该功能处于测试阶段,可通过AI SDK的streamTranscribe函数使用,兼容多种模型如OpenAI和xAI,并支持为智能体添加语音模式,无需改动现有文本处理流程。
本文讨论流式数据处理的规划,重点在于Kafka与Flink的结合。内容涵盖流处理基础、Kafka内核、Flink运行时、状态管理及交付语义,旨在解决实时数据链路中的关键问题,如事件时间、窗口处理、状态管理及故障模式。目标读者为数据平台工程师,帮助他们理解流式计算与批处理的差异,以及如何有效运维Kafka和Flink管道。
本文总结了流式数据处理中的背压机制及常见故障模式,如数据倾斜、checkpoint超时和Kafka rebalance风暴。详细阐述了背压的传播链、监测指标及其对系统性能的影响,并提供了故障诊断与修复建议。最后,比较了Flink、Kafka Streams、Spark和RisingWave四种流处理引擎的状态模型和运维复杂度,以帮助用户做出选型决策。
本文介绍了Agent Framework Workflow的基本概念,包括执行器(Executor)的定义和使用WorkflowBuilder构建工作流。通过创建UppercaseExecutor和ReverseTextExecutor两个执行器,示例展示了如何连接它们以实现流式输出,并实时监听执行器的完成和错误事件,以便调试复杂工作流。
本文讨论了阿里云百炼平台GLM-5模型的严重bug:流式输出内容截断。用户在发送简单问候消息时,回复内容被截断,导致最后几个字符丢失。阿里云售后认为是工具问题,但分析显示这是服务端生成逻辑的bug。建议阿里云修复以确保所有token完整发送,并增加测试以检查输出完整性。
本文介绍了SpecTokenizer,一种轻量级流式神经音频编解码器,采用压缩谱域建模,显著降低计算量和参数规模。实验结果表明,其在低码率下优于现有模型,适合资源受限环境,具备良好的泛化能力和高效的部署潜力。
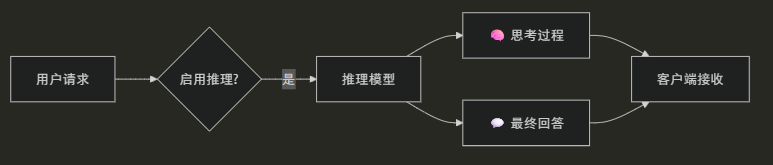
本文介绍如何在 Microsoft.Extensions.AI 中启用 DeepSeek 和千问推理模型的推理模式,支持流式和非流式获取思考过程。通过 RawRepresentationFactory 和 JsonPatch 设置参数,实时提取推理内容,以优化用户体验和调试。
完成下面两步后,将自动完成登录并继续当前操作。