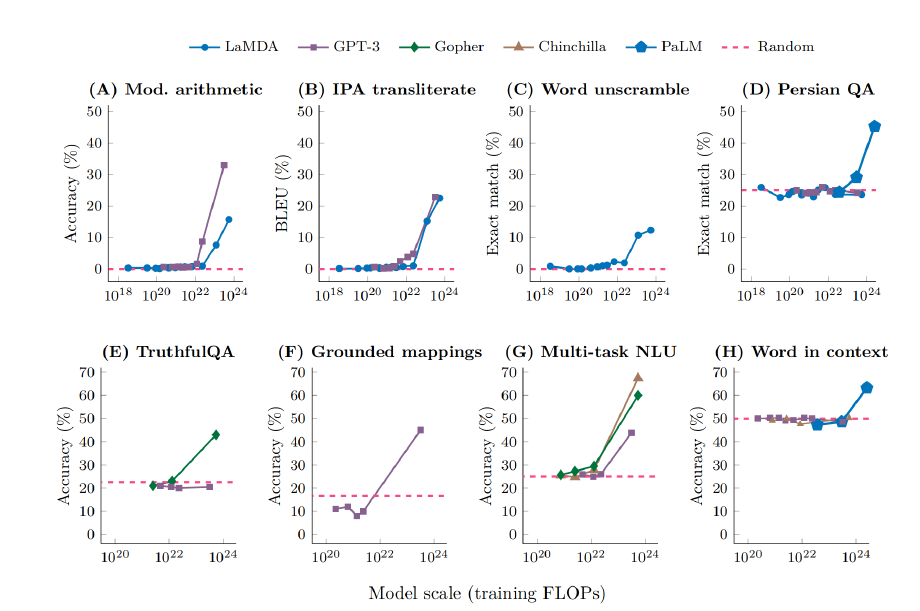
该文探讨大模型“涌现能力”是否真实存在。Wei等人认为能力随规模突现,但Schaeffer等人指出这可能是评测指标非线性或分辨率不足造成的假象。后续研究如PassUntil发现部分任务仍有非线性,而CoT和ICL的机制证据表明,许多现象更可能是接口激发而非新能力产生。结论是需谨慎看待涌现叙事,区分真实规模效应与评测伪影。
LLM扩展面临的挑战在于对涌现能力的理解不足。UC伯克利的研究表明,通过微调模型可以预测涌现能力,并发现微调可以提前识别涌现点。研究使用四个NLP基准验证了涌现定律,结果显示微调数据量影响涌现偏移,能够准确预测涌现点。
清华大学和智谱AI团队的研究发现,大模型的涌现能力与预训练损失的关系比模型参数更紧密。解锁涌现能力的关键在于优化预训练损失至关键值以下。
OpenAI发布视频生成模型Sora技术报告。Sora是文本条件扩散Transformer,在时空图像块上训练,可生成最长一分钟高清视频,支持多种分辨率、时长和宽高比。采用统一视觉块表示,结合重述技术提升文本遵循度。Sora展现3D一致性、长程连贯、物体持久性及模拟数字世界等涌现能力,但物理模拟仍有局限。
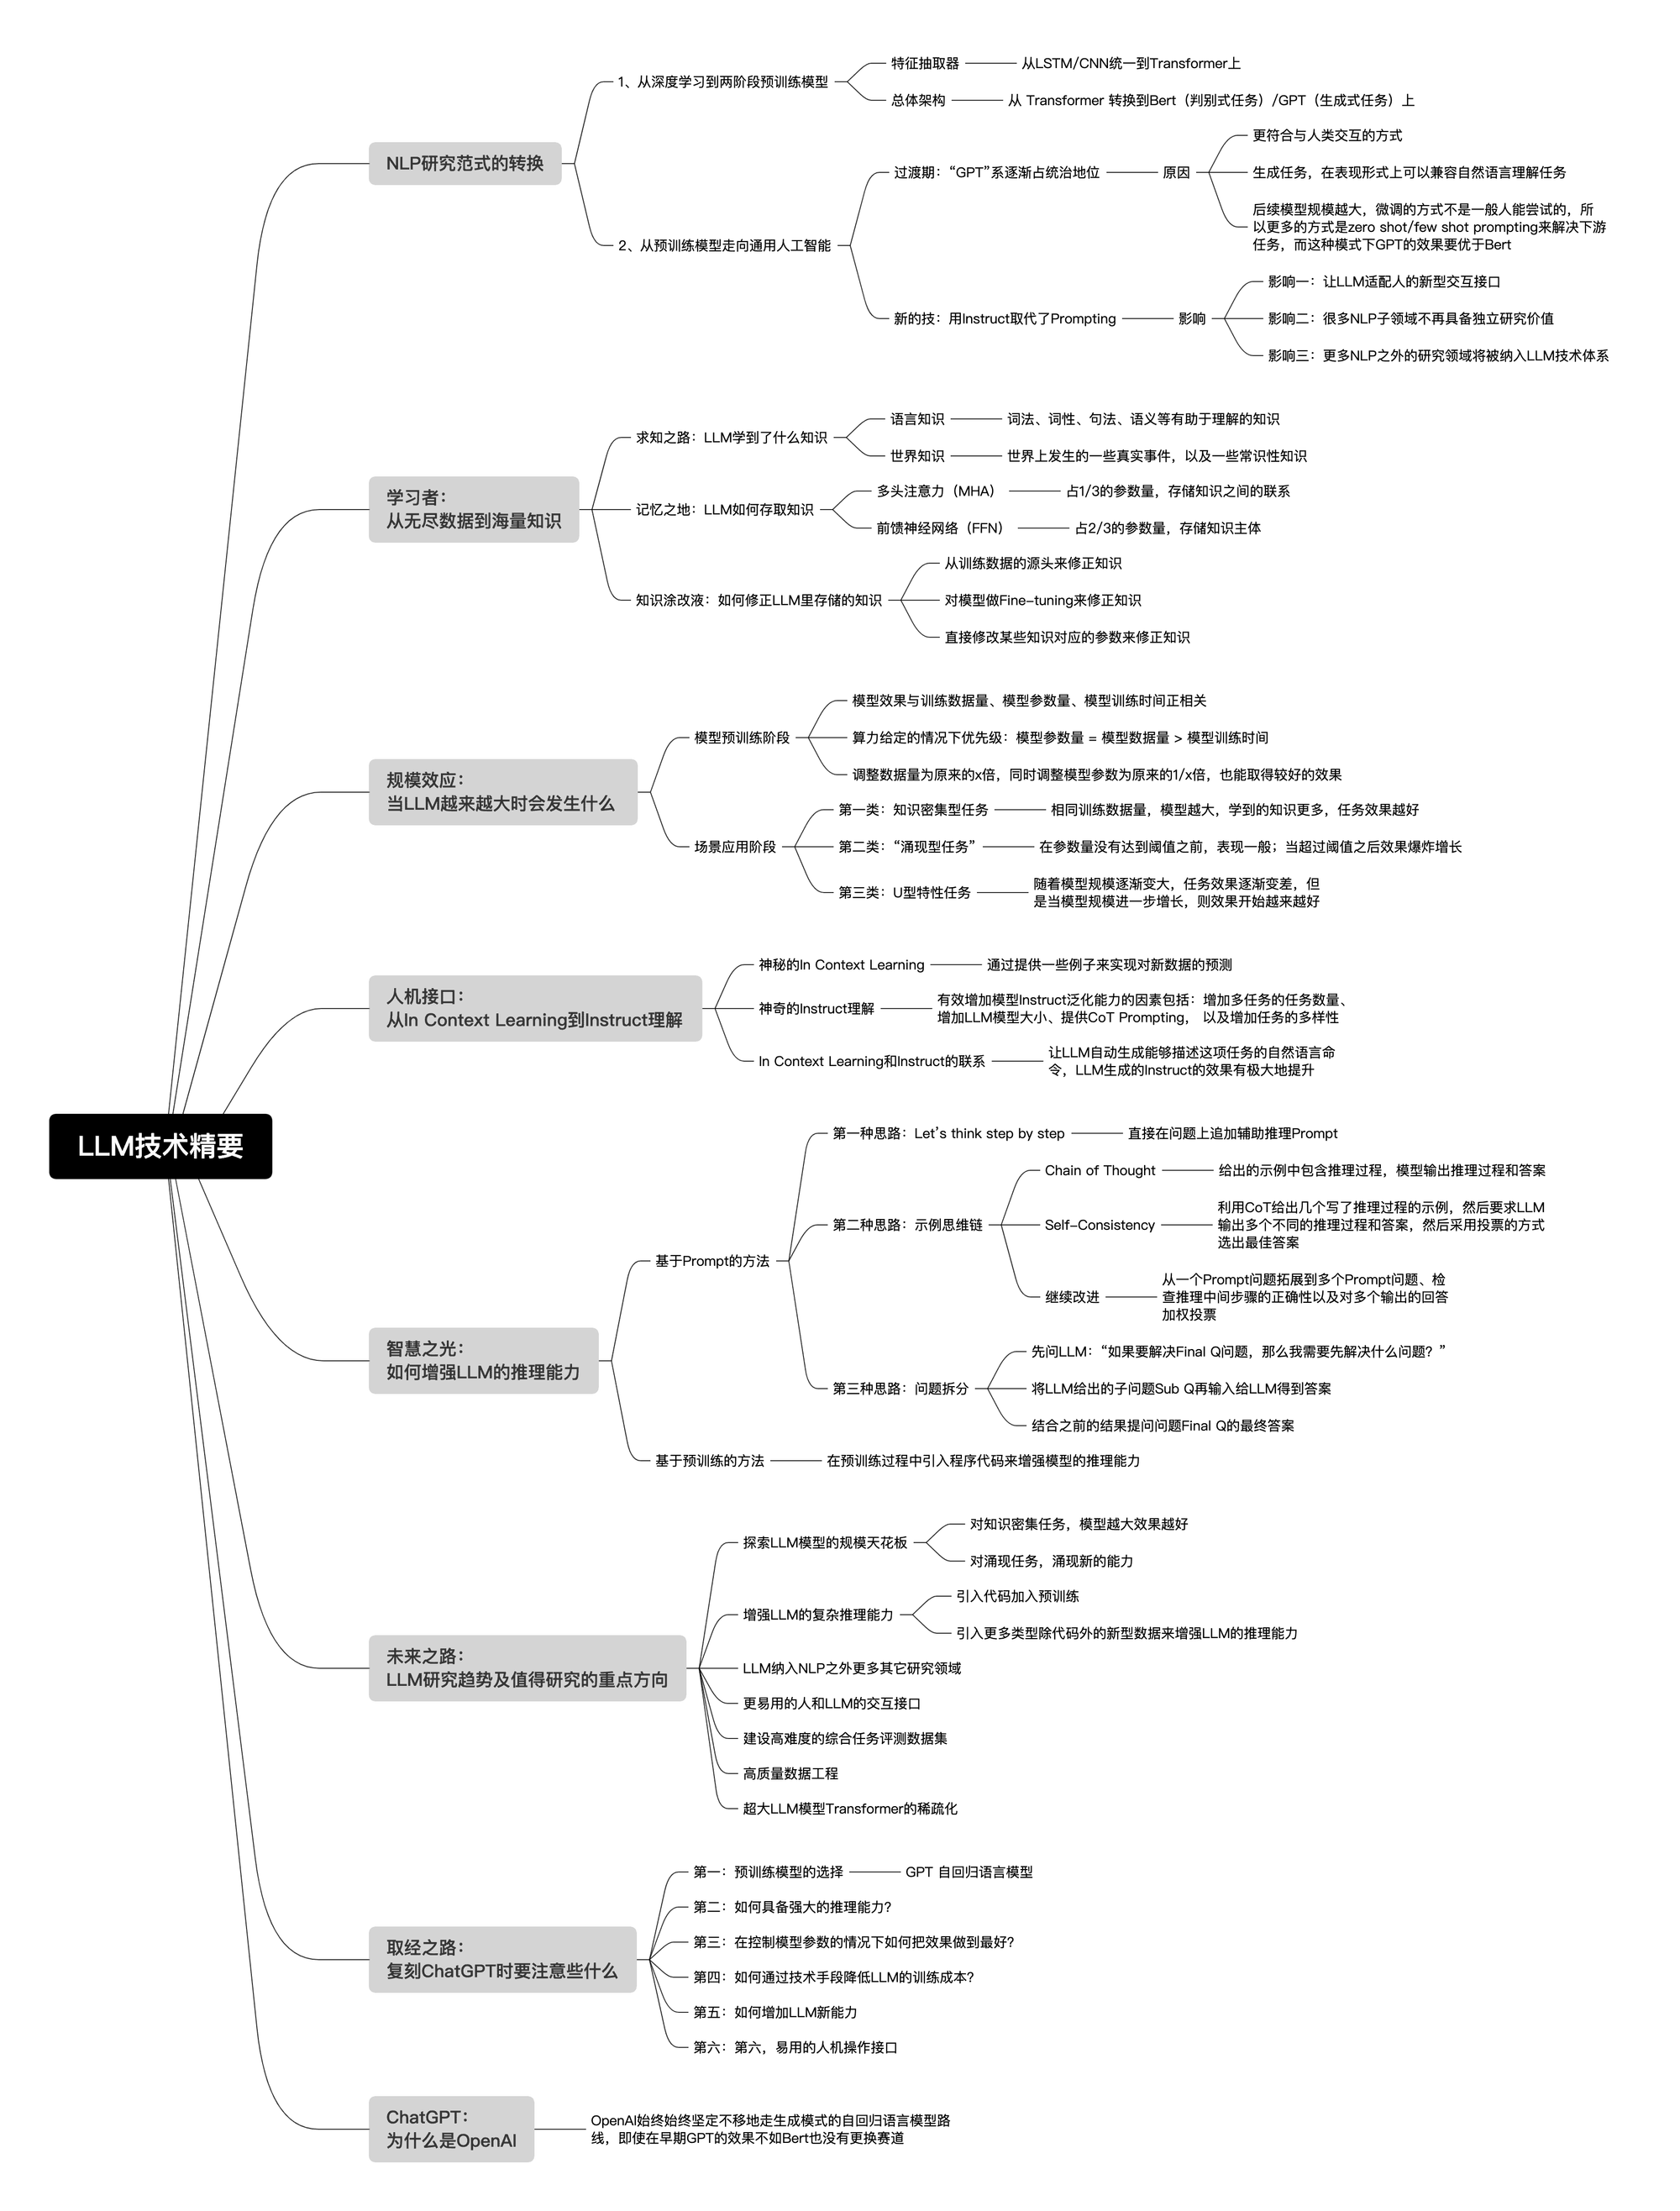
ChatGPT的出现标志着大语言模型进入新范式:以指令(Instruct)取代提示(Prompting),使模型更适配人类使用习惯。文章回顾了自然语言处理十年间的两次范式转换——从深度学习到预训练模型,再到通用人工智能,并重点讨论了大语言模型如何存储知识、规模效应、涌现能力、推理增强方法,以及复刻ChatGPT的关键技术方向,包括代码预训练、数据工程和易用人机接口。
《通向AGI之路》梳理了大语言模型技术要点:NLP经历从深度学习到预训练模型、再到ChatGPT以指令微调取代提示工程的范式转换;LLM从数据中习得语言与世界知识,存储于Transformer的FFN参数中;规模增长带来涌现能力,但复杂推理仍较弱;未来方向包括扩大规模、增强推理、引入代码预训练和优化人机接口。
《通向AGI之路》梳理了大语言模型技术要点:NLP经历从深度学习到预训练模型、再到ChatGPT以指令取代提示的两次范式转换;LLM从数据中习得语言与世界知识,存储于Transformer的FFN参数中;模型规模扩大带来涌现能力,但复杂推理仍薄弱;未来方向包括增强推理、引入代码预训练、建设易用人机接口及高质量数据工程。
研究人员发现,大规模语言模型的涌现能力是由于衡量指标的选择,而非模型行为的根本性变化。非线性或不连续的衡量标准会导致明显的涌现能力,而线性或连续的度量标准会导致模型性能的平滑、连续、可预测的变化。涌现能力的消失与指标选择相关,不是大规模模型的基本属性。该论文于去年4月底发布,并获得最佳论文奖。
本文介绍了一篇名为《大语言模型的涌现能力》的论文,研究人员对于这些大小不同的语言模型完成了八项新能力的测试。文章探讨了涌现的概念,即模型变得足够大才足够抽象,从而产生从未出现过的全新能力。
本文讨论了大型语言模型的涌现能力,即在大模型中出现但在小模型中不存在的能力。虽然有很多论文讨论了各种各样的涌现能力,但这些能力的不可解释和不可预测性使得一些科技领袖担心这种技术的发展。然而,LLM还不具备人类的心智层面的能力,输出有时对、有时错、有时荒谬,但没有意义。因此,LLM可以用于写会议纪要或者写段代码,但对于文学作品等需要保留每个字的意义的领域,LLM的输出可能不够。
本文介绍了大型语言模型的涌现能力,即“不存在于小模型中但存在于大模型中”的能力。已发现100多个涌现能力的例子,其中少量提示任务的性能对于小模型是随机的,对于大模型是随机的。涌现提示任务专注于特定数据集,而涌现的第二类是小样本提示策略,这是仅适用于足够大规模的语言模型的通用提示策略。
完成下面两步后,将自动完成登录并继续当前操作。