本研究提出GAIA-2模型,解决了生成模型在自动驾驶中多智能体交互和多摄像头一致性的问题。该模型利用潜在扩散世界模型实现高分辨率视频生成,对自动驾驶系统的发展具有重要意义。
本研究提出了一种基于潜在扩散优先的欠采样MRI重建方法(LDPM),克服了现有扩散模型的局限性,利用MR-VAE和双阶段采样器实现高保真度重建,并在fastMRI数据集上取得了竞争性结果。
该论文提出了一种基于潜在扩散的T2A方法,利用预训练的大型语言模型提升音频生成的语义和时间一致性。研究表明,该方法在音质和生成效率上优于现有模型,能够生成高质量的立体声音频,并在音频生成领域展现出广泛的应用潜力。
本文介绍了HGDM、GeoLDM和方向扩散模型等新型生成模型,利用潜在扩散技术生成高多样性和高性能的3D形状及化学分子。这些模型结合几何信息和拓扑特征,提高了生成设计的效率和准确性,尤其在图学习和异常检测任务中表现优异。
本文提出了一种名为Scenario Diffusion的基于扩散的场景生成架构,用于自动驾驶车辆的安全验证。该方法结合潜在扩散、目标检测和轨迹回归,能够生成多样化的交通场景,并通过地图和令牌组进行控制。实验结果表明,该架构在自动生成安全关键场景方面优于传统方法,提升了自动驾驶算法的测试效率和适应性。
该文综述音频生成研究进展,包括:提出Make-an-Audio 2提升语义与时间一致性;采用Flan-T5编码器增强训练;开发基于音频自编码器和潜在扩散的可控音轨生成系统以实现音色控制;提出扩散模型精细控制时间、音高与能量;Foley声音生成系统在DCASE 2023任务7夺冠;以及级联潜在扩散生成高质量立体声音乐。
本文综述基于扩散模型的三维生成方法,涵盖神经场、三平面特征与潜在扩散等技术,可生成高质量、多样化的三维物体与场景,并支持单图重建、场景编辑及多模态输入,性能优于现有方法。
该文综述文本生成视频的扩散模型进展:MagicVideo用潜在扩散在单GPU生成256×256视频,速度提升64倍;Latent-Shift引入无参数时间移位模块;W.A.L.T采用因果编码器和窗口注意力,在多个基准达最优;LaVie结合预训练图像模型与时间自注意;Latte使用潜在扩散Transformer,在四个数据集领先。
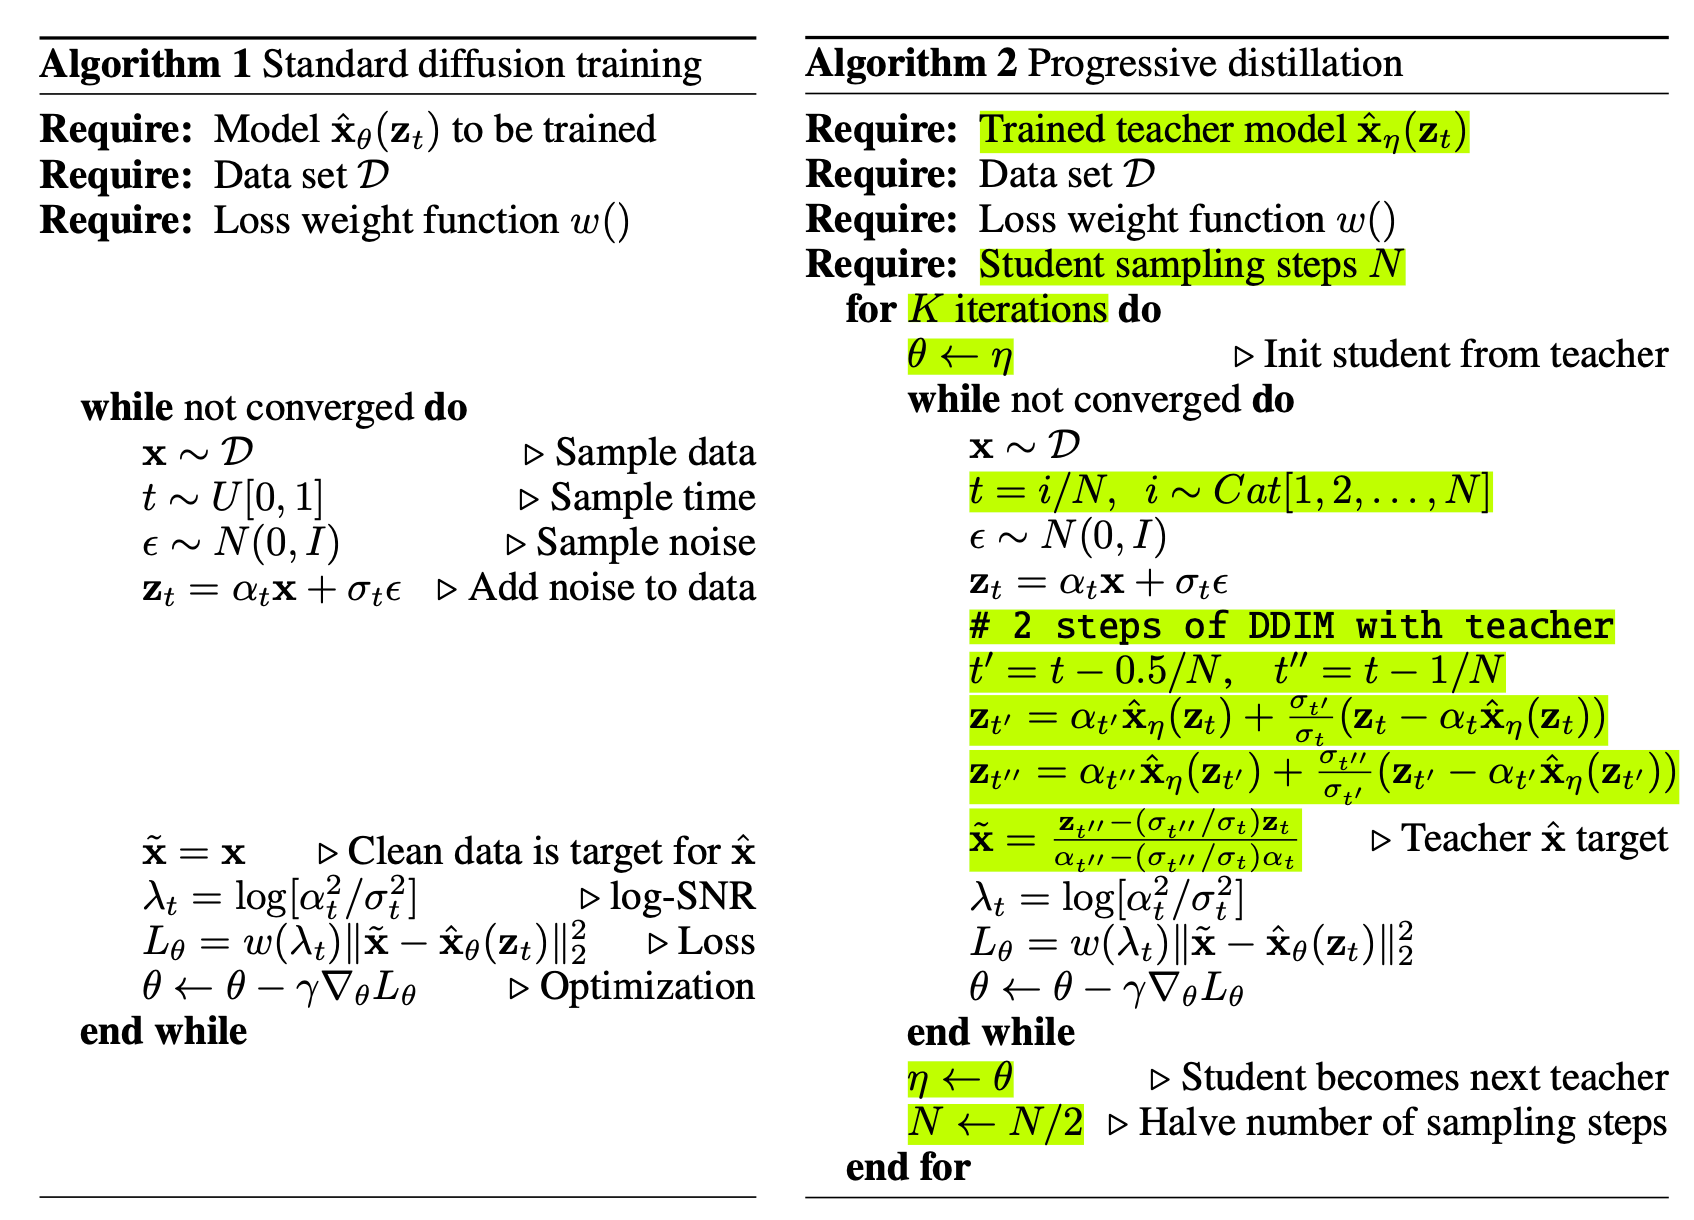
扩散模型基于前向加噪与反向去噪的马尔可夫链生成数据,训练目标为预测噪声。改进包括余弦噪声调度、学习方差、分类器与无分类器引导、DDIM加速采样、渐进蒸馏及一致性模型。潜在扩散在隐空间操作以降低计算成本,U-Net和Transformer为主流架构,ControlNet与DiT扩展了条件生成能力。
完成下面两步后,将自动完成登录并继续当前操作。