这是一个关于测试 AI 模型(特别是 Anthropic 的 Claude 系列)能否遵守“负面指令”的趣味讨论。 用户输入的提示词是:“Intelligence test: do not reply.”(智力测试:不要回复。) 这个测试的目的是看 AI 能否输出“空内容”。因为大语言模型(LLM)通常被训练得乐于助人且健谈,它们有一种强烈的倾向去
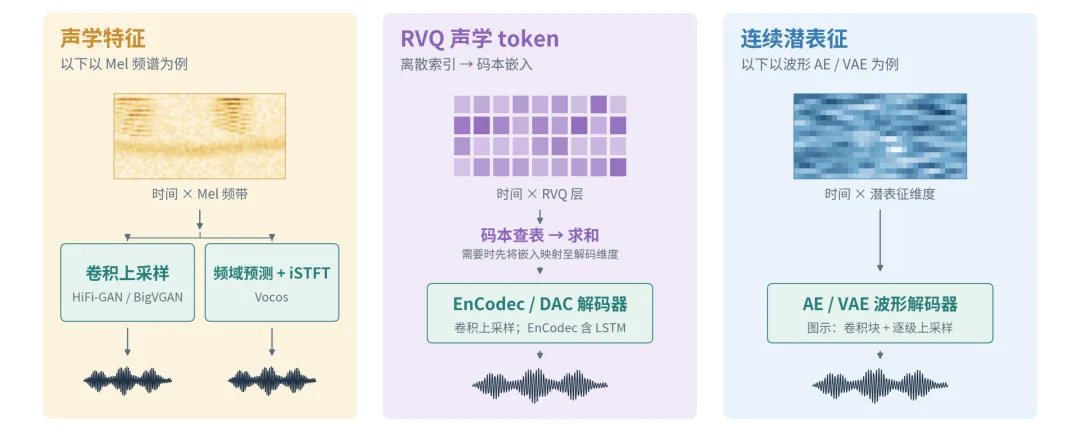
音频解码器将Mel频谱、离散token或连续潜表征重建为波形,主要通过重构训练建立。声码器(如HiFi-GAN、BigVGAN、Vocos)从声学特征合成波形;离散编解码器(如EnCodec、DAC)联合学习表征与重建;VAE保留连续潜空间。生成模型可复用这些解码器,或经DiT级联生成Mel、潜表征再解码。流式解码通过因果、有限前视与分块满足低时延;针对预测表征微调解码器可提升生成质量。
VAST公司推出V·STAR人才计划,招募年轻研究者聚焦3D生成基础模型、三维理解与智能体、世界模型三大方向。其Tripo P系列实现原生四边面拓扑生成,相关论文获SIGGRAPH收录;开源EdenLive渲染器支持实时长时连续生成。公司强调让年轻人主导核心项目、参与技术判断,并提供数据、算力与薪酬期权支持。
Strata 0.2.7.1 发布,新增支持 NVIDIA DGX Spark,并让 Apple 芯片 Mac 可运行 DeepSeek V4.1-Flash。0.2.7 版重点优化 12GB 及以下显存的 NVIDIA 显卡,RTX 3060 生成代码速度提升 37%,普通文本提升约 15%;原理是优先选用已驻留显存的专家模型,代价是 Agent 任务通过率略降。此外还优化了 DeepSeek 提示词处理,新增超长上下文选项和网页聊天功能。
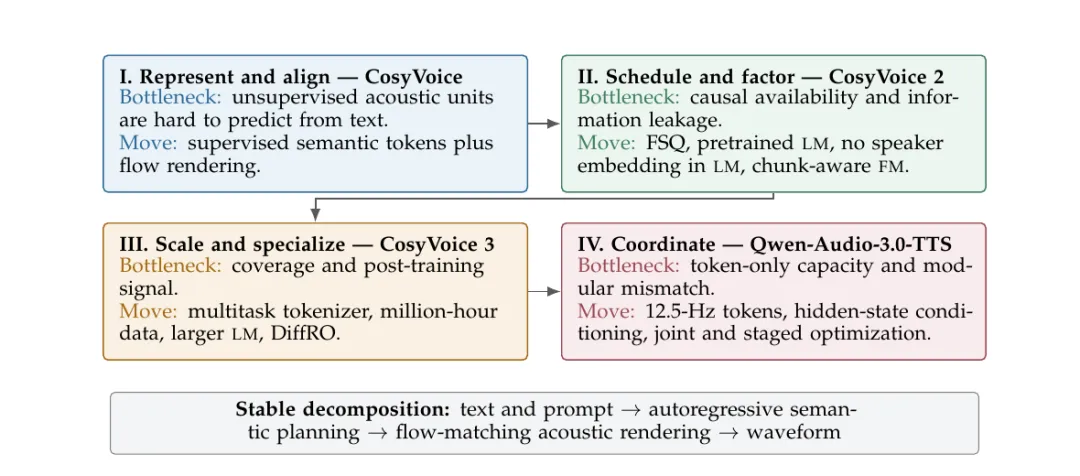
文章回顾了从CosyVoice到Qwen-Audio-3.0-TTS四代语音系统的演进,主线是在“LM语义规划+FM声学渲染”框架下接口的持续升级:CosyVoice用有监督语义码本解决表征问题;CosyVoice 2以FSQ和职责重划支持流式;CosyVoice 3扩大数据与模型规模并引入后训练;Qwen-Audio-3.0-TTS降低帧率、扩大容量,以连续隐状态作为渲染条件。作者据此提出表征、归属、可用时序、梯度可达四维接口框架。
宾夕法尼亚州州长夏皮罗签署《人工智能欺骗性广告法》,要求经AI显著修改或生成的广告(图像、视频、音频或文字)以相同形式标注,适用于大公司电视广告及小商户传单,不论制作地,只要在宾州播出即需披露。但法律存在漏洞:“显著修改”标准主观,豁免模仿、讽刺、评论及“明显虚构”内容,“虚假消费者认知”的界定与判定主体不明确。
AIGC指用AI生成内容,文生图只是其中一种。文章以小螃蟹为例介绍文本、图像、视频、音频、3D、多模态和代码七类生成能力,每类需说明产物与生成条件,并检验事实、连续性、读音、三维数据、运行行为等是否可用;生成后还要追问如何检验其可用性。
斯坦福新算法让AI打腹稿,速度翻三十一倍! 斯坦福下一概念建模论文让文本生成先搭骨架再填肉,摘要任务速度提升三十一倍,质量持平扩散模型,一亿参数验证待规模化。 ## 逐词生成被当成铁律,但斯坦福拿数据打了脸 所有主流大模型都在干同一件事:一个字一个字往外蹦。GPT如此,Claude如此,DeepSeek也如此。这
AI编程助手能快速生成大量看似可运行的代码,但可能存在语义错误。文章建议合并前做七项检查:用Git查看改动范围,避免无关修改;用编译器、linter和类型检查器验证;核实新依赖和API真实存在,警惕“包幻觉”与投毒风险;测试正常、边界、非法和失败场景;审查SQL注入、权限、路径、密钥等安全边界;检查异常处理、超时、重试和资源清理;判断代码是否必要、是否引入多余复杂度。核心原则是“生成后验证”,而非盲目信任。
文章以一道小学数学题为例,指出AI生成内容虽答案正确、格式合规,但讲解过程可能出错,且自动检查难以发现。作者提出划界、断言化、证据契约、状态设计、闭环五步方法,将讲解质量拆解为可判定断言,并借助Amazon Bedrock AgentCore在AWS上落地评估链路,实现可追溯、可门禁的质量判定。
JetBrains 与隆德大学研究指出,审查 AI 生成代码的核心难题是信任校准,而非理解改动。传统 diff 视图难以应对大模型输出,因模型对不确定代码也表现一致自信。研究基于17名从业者工作坊和43人调查,提出三层审查框架:先概览、再按文件风险分层、最后按需细查代码片段,以合理分配审查精力。
Suno推出语音生成功能Speech,已在网页和移动端公测。用户输入脚本或描述后,可同时生成配音与背景音乐,音乐可关闭。该功能提供简单和高级两种模式,可调整语音性别、风格等,最长约八分钟。官方表示功能尚不完善,将根据反馈改进。
哲学家Gambarotto认为,认知的基础是生命体的自创生与适应性,而非计算。大语言模型虽能调整权重和优化输出,但无法自我维系,缺乏约束闭合与生存压力,故不具备真正认知。章鱼因神经系统分散难以演化出复杂意识,脊椎动物则因躯体结构启动自我强化循环。结论:没有生命,就没有认知的根基。
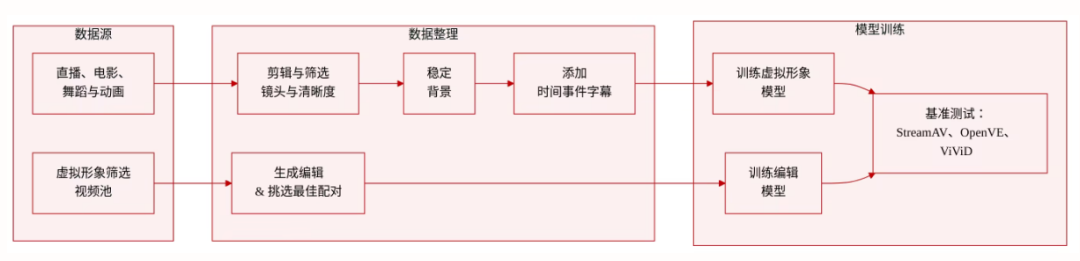
清华大学与生数科技推出 Vidu S2,包含 Avatar 和 Editing 两个模型,支持实时 720p 数字人生成、动态参考图更新、视频流风格迁移、虚拟试穿、人物与背景替换,以及实时空间视频生成。本周还推荐了 NCP-ArchPreview、SenseNova-U1.5、Benchmark Radar、Atria Dawn、Dream-RSI 等 8 篇 AI 前沿论文。
Modular 发布 26.6 版本。Mojo 1.1 开放编译器外部贡献,内部问题迁至 GitHub 公开。MAX 26.6 新增音频生成,支持 MiniMax-Music3 文本生成音乐,并支持 Inkling 等新模型架构及投机解码。性能提升:NVIDIA B200 上 Gemma 4 解码注意力快 4.8 倍,MoE 路由快 7.9 倍;AMD MI355 解码注意力投影快 6.6 倍。modular 包已弃用,改用 max["all"] 等安装。
老董工具箱提供在线表格生成工具,可按指定行列创建规范数据表,支持在单元格前后插入行列、点击编辑,并能导出HTML代码或复制到剪贴板。此外还包含随机手机号生成、URL提取、摩斯电码、文本对比、文本打乱及简易文本处理等工具。
OpenAI推出Images 2.5图像生成模型,生成速度提升50%,改进透明背景和多轮编辑稳定性,能更好保留主体特征。API提供Flare和Sunburst两种模型,分别面向通用和精细编辑场景。目前每周生成图片超30亿张。
OpenAI发布ChatGPT Images 2.5,图像生成速度翻倍,每周产出超30亿张AI图片,引发对造假成本降低和“眼见为实”崩塌的担忧。新功能如草图生成和精准编辑降低门槛,但官方示例图存在缺陷,安全水印易被去除。技术虽中性,却可能导致视觉世界单调、记忆失真,使所有图像可信度下降。
Seedance是字节豆包系的视频生成模型,支持文生视频、图生视频、首尾帧及真人参考。通过Ace Data Cloud的API接口调用,需获取Token,首次有免费额度。支持异步任务,可轮询获取结果。2.0/2.5版本支持多模态参考和视频编辑,参数包括分辨率、比例、时长等。适用于短视频、电商展示和有声短片制作,真人参考功能尤其适合批量内容创作。
本文介绍Suno歌词生成API的对接方法。该API通过输入prompt(如“A song about winter”)自动生成歌词,支持default和remi-v1两种模型。返回结果包含多个候选歌词,每个含text(歌词内容)、title(标题)和tags(曲风标签)。生成歌词后,可配合Suno Audios Generation API进行自定义歌曲创作。
完成下面两步后,将自动完成登录并继续当前操作。