


论文解读|从 CosyVoice 到 Qwen-Audio-3.0-TTS:四代语音生成系统,如何逐步破解瓶颈
内容提要
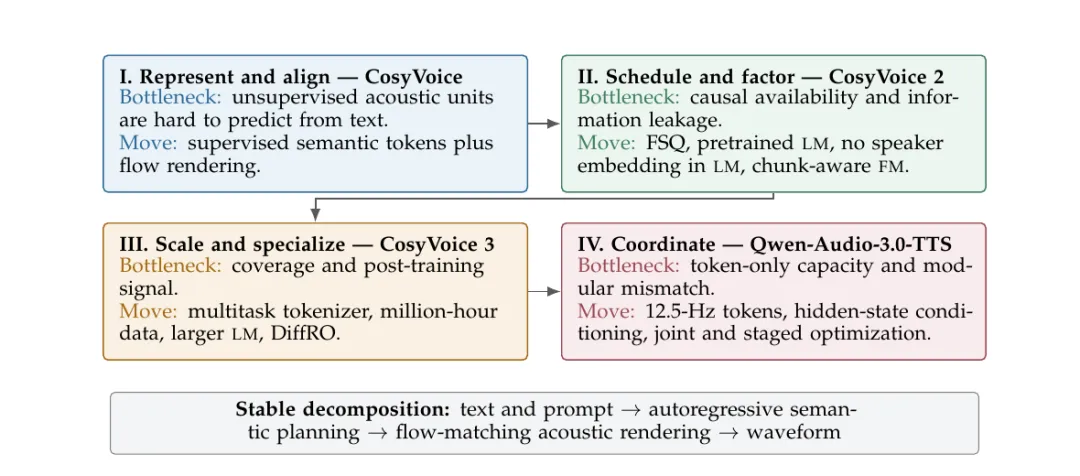
文章回顾了从CosyVoice到Qwen-Audio-3.0-TTS四代语音系统的演进,主线是在“LM语义规划+FM声学渲染”框架下接口的持续升级:CosyVoice用有监督语义码本解决表征问题;CosyVoice 2以FSQ和职责重划支持流式;CosyVoice 3扩大数据与模型规模并引入后训练;Qwen-Audio-3.0-TTS降低帧率、扩大容量,以连续隐状态作为渲染条件。作者据此提出表征、归属、可用时序、梯度可达四维接口框架。
延伸解读
接口契约:比版本号更实用的诊断工具
文章将LM与FM之间的接口契约拆解为表征、归属、可用时序和梯度可达四个维度,并指出这套框架可用于故障定位:内容错误更可能指向表征与规划,音色漂移更可能指向声学条件,延迟过高则应先检查token帧率和可用时序。这比单纯比较版本号更有针对性,但作者也强调,这是基于论文内部消融和架构变化的机制性解释,并非受控的跨版本因果实验。
Qwen-Audio-3.0-TTS的取舍:降帧率必须配扩容
为降低生产延迟,Qwen-Audio-3.0-TTS将tokenizer帧率从25 Hz降至12.5 Hz,同时把FSQ空间扩展到最多59,049个索引。论文内部对比表明,只降低帧率会带来损失,提高单步容量可以恢复大部分性能。这说明减少自回归步数并非没有代价,接口容量需要同步跟上,否则可控性、长文本和说话人保真等需求会受损。
渐进训练的顺序逻辑:先保模块能力,再解接口失配
Qwen-Audio-3.0-TTS采用五阶段渐进训练:独立预训练、联合训练与质量退火、LM强化学习、FM鲁棒性训练、FM强化学习。这套顺序的核心是先让各模块具备独立能力,再解决接口失配;先优化语义规划,再处理声学鲁棒性和最终感知质量。文章指出,这样做是为了避免端到端训练过早破坏模块能力,对理解复杂语音系统的训练策略有参考价值。
技术回顾的边界与部署风险
作者明确说明,本文是技术回顾而非跨四代系统的合成排行榜,不同论文使用的数据、checkpoint和评测栈并不完全一致,因此“瓶颈迁移”不能当作受控的因果结论。此外,高保真零样本语音合成伴随冒充、欺诈及未经授权的声音克隆等风险,真实部署需要结合知情授权、来源标记或有效水印、访问控制、滥用监测及合成媒体披露机制。
Q&A
CosyVoice 系列四代系统共同的技术框架是什么?
四代系统都沿用同一条主干:文本与提示先由自回归语言模型(LM)完成语义规划,生成紧凑的语音计划;再由流匹配模型(FM)渲染连续声学细节,最终输出波形。LM 不必串行描述所有声音细节,FM 负责音色、韵律和声学细节。真正不断演进的是 LM 与 FM 之间的接口。
CosyVoice 第一代如何让语音单元更容易从文本预测?
CosyVoice 将向量量化引入多语种 ASR 编码器,在有监督识别目标下学习包含 4,096 个条目的语义码本,使离散单元更贴近语言内容;FM 则承担连续声学重建。这解决了表征问题,让语音计划具备明确的内容属性,并能稳定地由文本预测。
CosyVoice 2 如何支持流式生成并重新划分模块职责?
CosyVoice 2 以有限标量量化(FSQ)替代 VQ,6,561 码空间达到完整利用(VQ 基线利用率仅 23%)。系统从 LM 中移除句级说话人嵌入,把显式音色条件保留在 FM;双流调度与 chunk-aware 因果 FM 让语义规划与声学生成在兼容的时间边界上协同。关键是把条件交给真正消费它的模块。
CosyVoice 3 在规模扩大后如何继续优化难例和真实场景?
CosyVoice 3 将生成训练数据扩展到 100 万小时,覆盖 9 种语言及广泛中文方言;多任务语音编码器从 53 万小时数据中学习 25 Hz FSQ token。LM 从 0.5B 扩展到 1.5B,FM 从 100M 扩展到 300M。tokenizer 融合 ASR、语言识别、情感识别、音频事件检测和说话人分析等监督;DiffRO 通过 token 域奖励让纠正性梯度直接到达 LM。流式链路上还将 HiFT 声码器改造成因果形式。
Qwen-Audio-3.0-TTS 降低 token 帧率后,如何避免接口容量不足?
Qwen-Audio-3.0-TTS 将 tokenizer 帧率从 25 Hz 降至 12.5 Hz,同时把 FSQ 空间扩展到最多 3¹⁰ = 59,049 个可能索引。论文内部对比表明:只降低帧率会带来损失,提高单步容量可以恢复大部分性能。系统仍保留离散 token 作为语义预测目标,但不再让 token embedding 成为 FM 的唯一直接条件,连续 LM 隐状态取代它成为渲染接口,既能携带更丰富的信息,也允许 flow loss 在联合训练时反向塑造上游表征。
作者提出的四维接口框架 𝓘 = (R, O, A, G) 分别指什么?
R(Representation):跨过边界的表征是什么;O(Ownership):内容、音色等因素由谁负责;A(Availability):接口信息何时可以用于推理;G(Gradient reach):哪些目标能够跨越边界塑造上游。这四个问题提供了一种诊断方式:内容错误更可能指向表征与规划;退化参考音频导致音色漂移,更可能指向声学条件;质量不变但延迟过高,则应首先检查 token 帧率和可用时序。
Qwen-Audio-3.0-TTS 采用五阶段渐进训练的顺序和目的是什么?
五阶段顺序为:独立预训练 → 联合训练与质量退火 → LM 强化学习 → FM 鲁棒性训练 → FM 强化学习。核心目的是:先让模块各自具备能力,再解决接口失配;先优化语义规划,再处理声学鲁棒性和最终感知质量。
