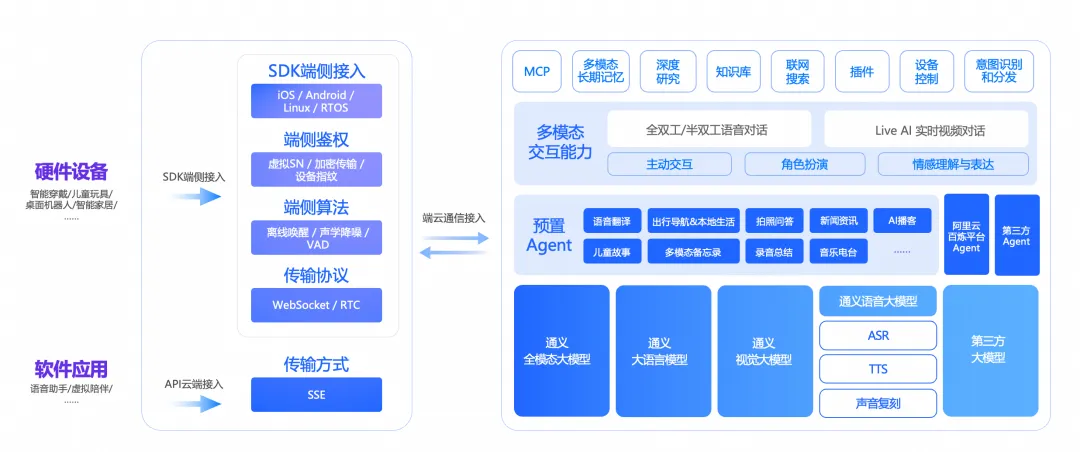
阿里云百炼多模态实时交互套件升级至Qwen-Audio-3.1,面向AI眼镜、学习机、汽车、机器人等硬件提供级联式语音交互方案。ASR支持30种语言、16种中文方言及热词识别,首字响应约160毫秒;TTS支持跨语言同音色与情绪语速调节,Elo评分全球第一。套件端到端延迟最低1秒,一套SDK适配30多个硬件平台,TTS降价约70%、ASR降价95%,并提供设备管理与运营能力。
本文介绍优化大模型微调性能的方法。作者以Qwen 27B为例,指出GPU利用率98%仍具误导性,需用torch trace深入分析。通过融合内核(如Flash Linear Attention、causal-conv1d)减少算子数量,并将批次改为1D打包张量消除填充,训练时间从7小时44分降至1小时17分,提速6倍。
微软发布Decision-1决策模型,基于阿里Qwen3.5-9B训练,定价与TypeSafe的Jev相同,速度比GPT-6快14倍,已用于Xbox、Copilot等内部团队。但研究显示Jev类模型易受误导性输入影响,且Decision-1不支持图像,兼容性存疑。
Qwen-Image 2.1 是 2026 年 9 月发布的开放权重图像模型,由文本编码器、7B DiT 和 VAE 三组件接力生成图片,支持文生图、参考图编辑、局部修改和透明背景。在 RTX 3060 6GB 显存加 32GB 内存下,借助 Unsloth Desktop 和模型卸载可运行,但 40 步生成一张图约需 40 分钟。文章还介绍了参数配置、与 GPT Image 2 的对比及商用许可限制。
腾讯QClaw将于12月24日停运,用户可迁移至WorkBuddy。千问发布Qwen-Audio-3.1系列并大幅降价,TTS降70%、Realtime降85%、ASR降95%。小米发布18 Pro系列,称其为AI改造手机的开始。谷歌杭州跨境电商加速中心投运。Meta的AI智能体Muse登顶美区App Store,推动纳指创新高。
小米发布小米18 Pro/Pro Max,起售价5999/6999元,首发2nm骁龙8至尊版,配2亿像素徕卡三摄、7000/8500mAh电池,同场推出平板9系列、手环11、Watch S5及多款家电。阿里发布Qwen-Audio-3.1语音大模型并全线降价。Amazfit推出全球首款双面太阳能手表T-Rex Dual Solar。雷蛇发布灰鲭鲨X音箱。Netflix公布《赛博朋克:边缘行者2》片段。
阿里发布Qwen-Audio-3.1系列五款语音模型,覆盖识别、合成、实时交互与音频创作,全线降价:TTS降约70%、Realtime降约85%、ASR降95%。ASR支持30种语言和16种中文方言,新增润色与分角色转写;ASR-Next可理解情绪与环境声;TTS支持跨语言音色合成;TTS-Next统一生成人声、音效与环境声;Realtime实现全双工交互并可调用工具。
林俊旸离职半年后,前华为“天才少年”刘大一恒正式接任阿里千问(Qwen)负责人。刘大一恒本硕博均就读于四川大学,2021年加入达摩院,是Qwen初期核心成员,主导Qwen1至Qwen3.5及Qwen-Math系列开发,参与开源300多款模型。今年3月起,他逐步接管预训练、后训练和Coding团队,近期全面接手Qwen。其演讲主题“真实世界智能体”透露了Qwen下一步方向。
Qwen训练中优化QSA indexer top-k回放:原方案数据量达router百倍,每步耗时增8倍。作者发现中间环节无需理解top-k,改为payload只写一次存共享存储,仅传KB级引用,布局机器改用24字节handle,额外开销降至7%以下。
9月22日云栖大会上,阿里公布大模型进展:Qwen3.8-Max实现自主训练、推理优化与芯片协同设计,RSI初步落地;Qwen4已训练,未来Qwen4.5、Qwen5参数将达5-10T。同时发布图像、音乐、世界、语音、全模态等新模型,并开源460余个模型,下载量破30亿次。
2026云栖大会上,阿里公布大模型进展:Qwen3.8-Max在编程与办公领域表现强劲,Qwen4已投入训练,未来参数将扩至5至10万亿。多模态方面,Qwen-Image-3.1、Qwen-Audio-3.1、Wan3.0等均居全球前列。阿里还公布RSI自我进化技术,模型可零人工干预自主迭代。Qwen系列全面开源,下载量超30亿次,成为全球AI开源社区基座模型。
用户反馈 Qwen 3.8 Flash Next 未审查版长上下文出现多语言乱码。排查发现,BF16 舍入误差随生成累积,FP4/FP8 lm_head 扰动概率排序,导致语言混杂。修复方法:GDN 循环状态恢复 FP32,lm_head 使用原生 BF16,主体仍为 NVFP4。修复后连续生成约 1.1 万 tokens 无漂移,但显存增加、速度下降。建议日常使用官方原版量化,破甲版仅供研究。
Qwen3.8-27B因快速生成网页走红,每秒近2000 Token,能凭一句Prompt现场生成完整界面。实测中,它五分钟做出数据分析小工具,但生成的12306抢票页面只是逼真空壳,无法联网、支付或真实抢票。它降低了做网页门槛,却仍难接入现实后端,离真正交付产品还有距离。
作者将Qwen 3.8 27B模型调优至极限,对比124与104两组配置的端到端吞吐(均含TTFT),五项中位数全部由124领先,TTFT也明显改善,并称错过算力舱就错过全球最快Qwen 3.8 27B。
用户测试了专为Qwen优化的推理框架Ninfer,并与优化后的vLLM对比。在Qwen 3.8 27B、开启CUDA Graph下,vLLM的Decode和Prefill性能全面超越Ninfer,解码最高63.34 TPS,Prefill最高3230 TPS,TTFT低至0.15秒。多数场景vLLM更快,250K Prefill和TTFT领先达54.5%。优化后单流解码提升8.6%~14.5%,并发吞吐提升约15.6%。
2026年9月17日,ZEGO云端实时语音识别发布v2.4.0,新增支持Qwen-Audio-3.0-ASR-Flash-Streaming模型,可配置热词,支持中文、英语、日语等语种,通过ASR参数设置厂商、语种和模型;同时下架qwen3-asr-flash-realtime模型,原用户后续将被替换为新模型。
用户偏好Qwen 3.8 27B,认为其在明确任务下执行精准稳定,虽不如GPT全能。因Qwen 3.8 Flash Next训练不严谨、长上下文易乱码而弃用。用户采用GPT规划、27B执行的组合,并用Pi Agent配27B修复博客视频问题,效率很高。
Qwen Code v0.23.1/0.23.2 将代码智能体工作流变为可查看、暂停、隔离和回收权限的运营对象,新增工作流管理页、上下文占用拆分、最多8个命名任务及独立 Git Worktree,并支持本地目录临时授权。作者认为竞争转向控制面,建议采用“动作-对象”命名、独立 Worktree、检查上下文、最小授权,并制定运行合同。
作者分享Qwen模型移植经验:DeepSeek V4 Flash和Qwen 3.8 27B未审查版移植正常,但Qwen 3.8 Flash Next未审查版在输出超过5K时出现中英韩混合乱码,归因于训练不严谨。通过设置温度0.3、top_p 0.95、top_k 20,并统一模型ID为qwen3.8-flash-next-uncensored可解决。作者已更新算力舱内多个模型,后续将继续优化。
文章介绍了一种高效且省钱的工作流:利用线上GPT进行全局规划与设计,再将方案交给离线模型(如Qwen 27B)执行具体任务。离线模型在后台运行,能自主解决环境问题,既保留线上模型能力,又大幅降低订阅成本,节省约90%费用。
完成下面两步后,将自动完成登录并继续当前操作。